
- মাসিক ভিজিট
- 0
- মূল্য
- সেট করা হয়নি
- তালিকাভুক্ত
- —
- আপডেট করা হয়েছে
- 2026-09-10
01AuK কী
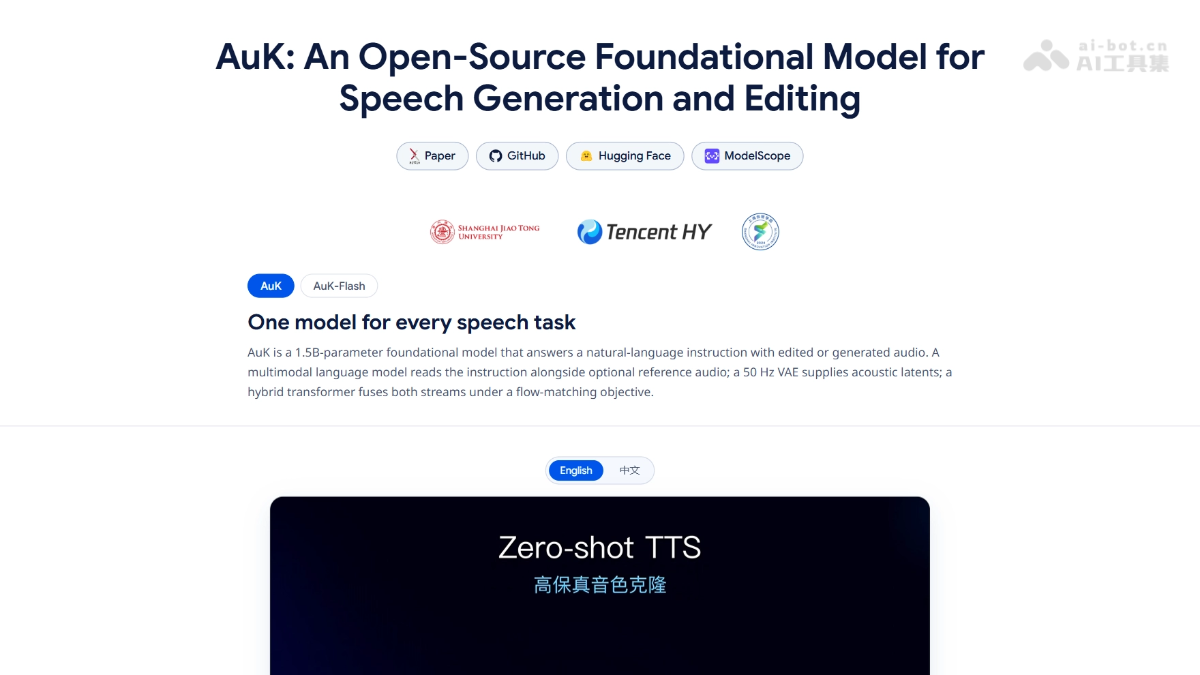
AuK হলো Tencent Hunyuan-এর ওপেন-সোর্স করা 1.5 বিলিয়ন প্যারামিটারের স্পিচ জেনারেশন ও এডিটিং বেস মডেল, যা অটোরিগ্রেসিভ পদ্ধতির পরিবর্তে ফ্লো-ম্যাচিং ডিফিউশন আর্কিটেকচার ব্যবহার করে। মডেলটি একটি统一 প্রাকৃতিক ভাষা নির্দেশনা ইন্টারফেসের মাধ্যমে 16 ধরনের স্পিচ টাস্ক সম্পন্ন করতে পারে, যার মধ্যে রয়েছে জিরো-শট/নির্দেশনাভিত্তিক TTS, স্পিচ কনটেন্ট এডিটিং, অ্যাকোস্টিক সমন্বয়, প্যারালিঙ্গুয়াল এডিটিং, নয়েজ কমানো এবং ভয়েস আলাদা করা। মডেলটি 4 ধাপের ইনফারেন্স-সমৃদ্ধ AuK-Flash দ্রুত সংস্করণও সরবরাহ করে, যার গতি প্রায় 4.5 গুণ বেশি।
02AuK-এর প্রধান বৈশিষ্ট্য
Zero-shot TTS: কয়েক সেকেন্ডের রেফারেন্স অডিও ব্যবহার করে কণ্ঠস্বর ক্লোন করে নতুন স্পিচ সংশ্লেষণ।
Instruct TTS: রেফারেন্স অডিও ছাড়াই শুধু লেখায় কণ্ঠের বৈশিষ্ট্য বর্ণনা করে সংশ্লিষ্ট স্পিচ তৈরি।
স্পিচ কনটেন্ট এডিটিং: কণ্ঠস্বর ও স্বরভঙ্গি অপরিবর্তিত রেখে রেকর্ডিংয়ের লেখা প্রতিস্থাপন, সংযোজন বা মুছে ফেলা।
গানের কথা সম্পাদনা: সুর ও কণ্ঠের বৈশিষ্ট্য অক্ষুণ্ণ রেখে শুধু গানের কথা পরিবর্তন।
পিচ/গতি/ভলিউম সম্পাদনা: সেমিটোন, গুণিতক গতি ও ডেসিবেল এককে অ্যাকোস্টিক বৈশিষ্ট্য নির্ভুলভাবে সমন্বয়।
আবেগ ও কণ্ঠস্বর সম্পাদনা: শব্দ পরিবর্তন না করে আবেগের রং বদলানো, অথবা কনটেন্ট অক্ষুণ্ণ রেখে কণ্ঠস্বর রূপান্তর।
উচ্চারণ সম্পাদনা ও নয়েজ কমানো: উচ্চারণের প্রভাব দূর করা, নয়েজ ও রিভার্ব কমিয়ে স্বচ্ছতা বাড়ানো।
প্যারালিঙ্গুয়াল ইভেন্ট সম্পাদনা: শ্বাসের শব্দ, হাসি ও কাশি যোগ বা অপসারণ করে স্বাভাবিক স্পিচ ও ফিসফিসে কথনে রূপান্তর।
স্পিচ আলাদা করা: কথা বলার ক্রম অনুযায়ী একাধিক ব্যক্তির অডিও ভাগ করা, অথবা কনটেন্টের বর্ণনা অনুযায়ী নির্দিষ্ট বক্তার কণ্ঠ বের করা।
মিউজিক আলাদা করা: গান থেকে ভোকাল বের করা এবং বাদ্যযন্ত্রের অংশ অপসারণ।
03AuK-এর প্রযুক্তিগত নীতি
WeChat-এ ফলো করে “开源” লিখে উত্তর দিন এবং AI ওপেন-সোর্স প্রকল্পের আলোচনা গ্রুপে যোগ দিন
সামগ্রিক পদ্ধতি: AuK ফ্লো-ম্যাচিং ডিফিউশন আর্কিটেকচার ব্যবহার করে অডিওর ল্যাটেন্ট স্পেস উপস্থাপনা তৈরি করে, যা “এডিটিং” ধরনের কাজের জন্য স্বাভাবিকভাবেই উপযোগী। এটি মূল অডিওর ল্যাটেন্ট উপস্থাপনাকে ডিনয়জিংয়ের সূচনা হিসেবে ব্যবহার করে এবং নির্দেশনায় চাওয়া অংশটুকুই পরিবর্তন করে। ফলে মূল কণ্ঠস্বর, সুর ও অপরিবর্তিত কনটেন্ট আরও ভালোভাবে সংরক্ষিত হয়। এটাই বিভিন্ন এডিটিং টাস্ক সমর্থনের প্রযুক্তিগত ভিত্তি।
তিন-কম্পোনেন্ট পাইপলাইন আর্কিটেকচার: সিস্টেমটি তিনটি অংশ নিয়ে গঠিত: মাল্টিমোডাল বড় মডেল প্রাকৃতিক ভাষার নির্দেশনা ও রেফারেন্স অডিও পড়ে এবং সেমান্টিক কন্ডিশন তৈরি করে; অডিও VAE 24kHz ওয়েভফর্মকে 50Hz অ্যাকোস্টিক ল্যাটেন্ট স্পেসে এনকোড করে; মূল হাইব্রিড Transformer 10 স্তরের ডুয়াল-স্ট্রিম MMDiT এবং 20 স্তরের সিঙ্গেল-স্ট্রিম DiT দিয়ে গঠিত, যার মডেল প্রস্থ 1536 এবং মোট প্যারামিটার 1.5 বিলিয়ন।
বৃহৎ পরিসরের নির্দেশনা-সামঞ্জস্য প্রশিক্ষণ: প্রশিক্ষণ ডেটায় প্রায় 3.03 বিলিয়ন “নির্দেশনা—অডিও” জোড়া রয়েছে, যা মোট প্রায় 1.95 মিলিয়ন ঘণ্টার কার্যকর তত্ত্বাবধান প্রদান করে। মূল বিষয় হলো সব টাস্ককে একই “নির্দেশনা + ইনপুট অডিও → আউটপুট অডিও” ফরম্যাটে একীভূত করা, যাতে মডেলটি একটি একক ইন্টারফেসের মাধ্যমে 16টি টাস্কে সাধারণীকরণ করতে পারে।
পরবর্তী প্রশিক্ষণ ও মানব-পছন্দ অপ্টিমাইজেশন: বেস প্রশিক্ষণের পর মডেলটি মানব-পছন্দ অপ্টিমাইজেশন এবং রিইনফোর্সমেন্ট লার্নিং পোস্ট-ট্রেনিং (RL post-training) এর মধ্য দিয়ে যায়, যা তৈরি স্পিচের স্বাভাবিকতা, নির্দেশনা অনুসরণ এবং শ্রুতিগত মান উন্নত করে।
04AuK কীভাবে ব্যবহার করবেন
হার্ডওয়্যার পরিবেশ নিশ্চিত করুন: প্রায় 24GB VRAM-এর NVIDIA GPU, যেমন RTX 3090/4090, প্রস্তুত করুন।
কোড রিপোজিটরি ক্লোন করুন: GitHub থেকে Tencent-Hunyuan/AuK রিপোজিটরি স্থানীয়ভাবে ক্লোন করুন।
নির্ভরতা ইনস্টল করুন: রিপোজিটরির নির্দেশনা অনুযায়ী Python পরিবেশ কনফিগার করে প্রয়োজনীয় প্যাকেজ ইনস্টল করুন।
মডেল ওজন ডাউনলোড করুন: Hugging Face বা ModelScope থেকে AuK ওজন এবং সংশ্লিষ্ট VAE ফাইল ডাউনলোড করুন।
সেমান্টিক কন্ডিশন মডেল ডাউনলোড করুন: নির্দেশনা ও রেফারেন্স অডিও বিশ্লেষণের জন্য মাল্টিমোডাল বড় মডেল Qwen2.5-Omni-3B আলাদাভাবে ডাউনলোড ও কনফিগার করুন।
ইনপুট উপকরণ প্রস্তুত করুন: লক্ষ্য টেক্সট, রেফারেন্স অডিও অথবা সম্পাদনা করার মূল অডিও ফাইল প্রস্তুত রাখুন।
প্রাকৃতিক ভাষার নির্দেশনা লিখুন: কাজের প্রয়োজন অনুযায়ী নির্দেশনা লিখুন, যেমন কণ্ঠের বৈশিষ্ট্য বর্ণনা করা, প্রতিস্থাপনযোগ্য বাক্য নির্দিষ্ট করা অথবা পিচ/স্পিচের গতি সমন্বয় করা।
ইনফারেন্স চালান: কমান্ড লাইন (CLI) দিয়ে নির্দেশনা ও উপকরণ ইনপুট করে জেনারেশন বা এডিটিং চালান এবং আউটপুটের জন্য অপেক্ষা করুন।
শুনে দেখুন ও সমন্বয় করুন: ফলাফলের অডিও পরীক্ষা করুন; সন্তুষ্ট না হলে নির্দেশনার ভাষা, স্যাম্পলিং ধাপের সংখ্যা অথবা CFG শক্তি পরিবর্তন করে আবার তৈরি করুন।
05AuK-এর মূল সুবিধা
একীভূত ইন্টারফেস, সম্পূর্ণ টাস্ক কভারেজ: প্রাকৃতিক ভাষার নির্দেশনার মাধ্যমে মডেলটি TTS, এডিটিং, এনহ্যান্সমেন্ট ও সেপারেশনসহ 16 ধরনের স্পিচ টাস্ক সম্পন্ন করতে পারে, প্রতিটি টাস্কের জন্য আলাদা মডেল স্থাপনের প্রয়োজন নেই।
এডিটিং ক্ষমতা শিল্পে বিরল: শব্দ পরিবর্তন, বাক্য সংযোজন, পিচ সমন্বয় ও আবেগ পরিবর্তনের মতো সূক্ষ্ম সম্পাদনা সমর্থন করে এবং মূল কণ্ঠস্বর ও স্বরভঙ্গি সর্বাধিক সংরক্ষণ করতে পারে।
Instruct TTS-এ রেফারেন্স অডিও লাগে না: লেখায় কণ্ঠের বৈশিষ্ট্য বর্ণনা করেই স্পিচ তৈরি করা যায়, ফলে ব্যবহারের বাধা কমে।
ফ্লো-ম্যাচিং আর্কিটেকচারে বেশি বিশ্বস্ততা: টোকেন ধরে ধরে পূর্বাভাসের পরিবর্তে ডিফিউশন-ভিত্তিক জেনারেশন ব্যবহার করে। সম্পাদনার সময় মূল অডিওকে সূচনা হিসেবে নিয়ে ডিনয়জিং করা হয়, তাই অপরিবর্তিত অংশে প্রায় কোনো ক্ষতি হয় না।
06AuK প্রকল্পের ঠিকানা
প্রকল্পের অফিসিয়াল ওয়েবসাইট:https://auk-project.github.io/
GitHub রিপোজিটরি:https://github.com/Tencent-Hunyuan/AuK
HuggingFace মডেল রিপোজিটরি:https://huggingface.co/tencent/AuK
arXiv প্রযুক্তিগত গবেষণাপত্র:https://arxiv.org/pdf/2609.08936
07AuK-এর প্রয়োগের ক্ষেত্র
চলচ্চিত্র/স্বল্পদৈর্ঘ্য নাটকের পোস্ট-প্রোডাকশন সংলাপ সংশোধন: অভিনেতা ভুল শব্দ বললে বা স্ক্রিপ্ট সামান্য পরিবর্তন হলে রেকর্ডিংয়ের নির্দিষ্ট শব্দ বা বাক্য সরাসরি প্রতিস্থাপন করা যায়। স্টুডিওতে পুনরায় ডাবিংয়ের প্রয়োজন নেই এবং মূল অভিনয়ের আবেগ বজায় থাকে।
পডকাস্ট ও সাক্ষাৎকার নির্মাণ: ভুল বলা ও অপ্রয়োজনীয় কথা মুছে ফেলা, বলার গতি ও ছন্দ সমন্বয়, পটভূমির শব্দ ও রিভার্ব অপসারণ করে কাঁচা উপকরণকে এক ধাপে সম্পূর্ণ কাজে রূপ দেওয়া।
অডিওবুক ও AI ডাবিং তৈরি: Instruct TTS ব্যবহার করে চরিত্রের বর্ণনা অনুযায়ী আলাদা কণ্ঠস্বর তৈরি করা যায়। একই narrator পরবর্তী পর্যায়ে আবেগ ও স্বরভঙ্গিও সমন্বয় করতে পারেন, ফলে বহু-চরিত্র নির্মাণের খরচ কমে।
সঙ্গীত সৃষ্টি ও পুনর্নির্মাণ: মূল সুর ও কণ্ঠের বৈশিষ্ট্য রেখে কভার গানের কথা পরিবর্তন করা, অথবা গান থেকে ভোকাল বের করে remix উপকরণ হিসেবে ব্যবহার করা।
ভাষা প্রশিক্ষণ ও অ্যাক্সেসিবিলিটি: উচ্চারণের সমস্যা বা ভাষাগত প্রতিবন্ধকতা থাকা ব্যবহারকারীদের উচ্চারণের প্রভাব কমানো, বলার গতি ও ভলিউম সমন্বয় করা এবং আরও স্পষ্ট ও সহজবোধ্য স্পিচ কনটেন্ট তৈরি করা।
© দাবিত্যাগ: সময়ের সঙ্গে ডোমেইন ও লিংক করা কনটেন্ট পরিবর্তিত হতে পারে। AIEZZ তৃতীয় পক্ষের ওয়েবসাইট নিয়ন্ত্রণ করে না। বাহ্যিক কনটেন্ট ও ঝুঁকি স্বাধীনভাবে পর্যালোচনা করুন।
ব্যবহারকারীর রিভিউ0