
- মাসিক ভিজিট
- 0
- মূল্য
- বিনামূল্যে এবং পে করুন
- তালিকাভুক্ত
- 2026-08-07
- আপডেট করা হয়েছে
- 2026-08-07
01SALMONN-2 কী
SALMONN-2 হলো ছিংহুয়া বিশ্ববিদ্যালয়, সাংহাই কৃত্রিম বুদ্ধিমত্তা গবেষণাগার এবং ক্যামব্রিজ বিশ্ববিদ্যালয়ের যৌথভাবে উন্মুক্ত করা একটি সাধারণ অডিও বৃহৎ ভাষা মডেল। এটি বাইটড্যান্সের SPEAR একীভূত স্ব-তত্ত্বাবধানভিত্তিক অডিও এনকোডার ও বহুপদী বৈশিষ্ট্য-সমন্বয় অ্যাডাপ্টারের ওপর নির্মিত এবং Qwen3-কে টেক্সট ভিত্তি হিসেবে ব্যবহার করে। প্রায় 1.8万 ঘণ্টা তত্ত্বাবধানভিত্তিক ডেটা ব্যবহার করেই এটি MMAU-Pro, MMAR ও MMSU—এই তিনটি সামগ্রিক বেঞ্চমার্কে একই আকারের উন্মুক্ত মডেলগুলোর মধ্যে সেরা ফল করেছে। সাধারণ ALLM-এ এটি প্রথমবারের মতো শব্দ-ঘটনা শনাক্তকরণ, অডিও জালিয়াতি শনাক্তকরণ, বক্তৃতার গুণমান মূল্যায়ন এবং বহুমাত্রিক প্রাসঙ্গিক বক্তৃতা শনাক্তকরণের মতো উন্নত সক্ষমতা পদ্ধতিগতভাবে বাস্তবায়ন করেছে।
02SALMONN-2-এর প্রধান কার্যাবলি
সাধারণ অডিও অনুধাবন: বক্তৃতা শনাক্তকরণ, অডিও বর্ণনা, সংগীত অনুধাবন, আবেগ শনাক্তকরণ, বক্তা যাচাইকরণসহ বিভিন্ন ক্ষেত্রের কাজ সমর্থন করে।
শব্দ-ঘটনা শনাক্তকরণ (SED): পরিবেশগত শব্দের ঘটনা শনাক্ত করে তাদের শুরু ও শেষের সময়সীমা নির্ধারণ করতে পারে, যেমন কুকুরের ডাক ও পায়ের শব্দ।
অডিও গভীর জালিয়াতি শনাক্তকরণ: বক্তৃতা আসল না নকল তা নির্ধারণ করে এবং সন্দেহজনকভাবে সংশ্লেষিত বা সম্পাদিত স্থানীয় অংশের সময়সীমা শনাক্ত করে।
বক্তৃতার গুণমান মূল্যায়ন (SQA): শব্দ, বিকৃতি, স্বচ্ছতাসহ নিম্নস্তরের ধ্বনিতাত্ত্বিক বৈশিষ্ট্য অনুধাবন করে এবং গুণমানের স্কোর ও ব্যাখ্যা দেয়।
বহুমাত্রিক প্রাসঙ্গিক বক্তৃতা শনাক্তকরণ (MICL): লিখিত বানান এবং রেফারেন্স উচ্চারণের অডিও একত্র করে দুর্লভ শব্দ ও বিরল ব্যক্তিনামের শনাক্তকরণের নির্ভুলতা বাড়ায়।
03SALMONN-2-এর প্রযুক্তিগত নীতি
উইচ্যাটে ফলো করে “开源” লিখে উত্তর দিন এবং AI উন্মুক্ত প্রকল্পের আলোচনা গ্রুপে যোগ দিন
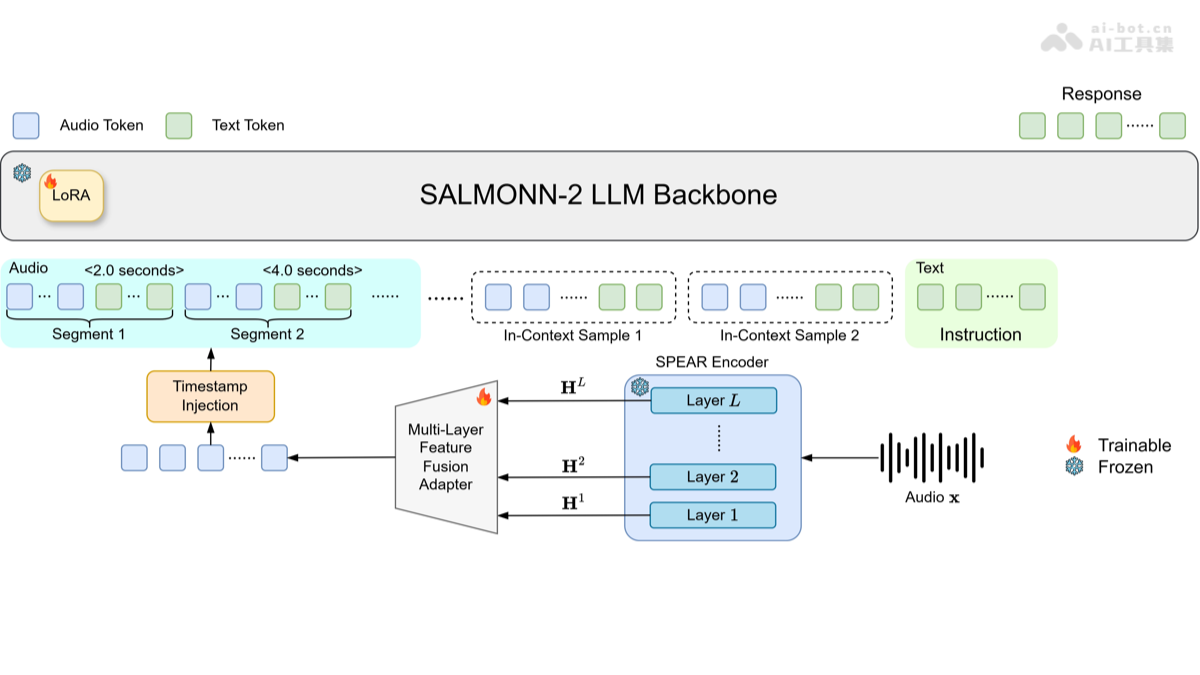
একীভূত স্ব-তত্ত্বাবধানভিত্তিক অডিও এনকোডার: SALMONN-2 একটি একক অডিও ফ্রন্টএন্ড হিসেবে SPEAR ব্যবহার করে। এনকোডারটি বিপুল অনুল标িত অডিও ডেটায় স্ব-তত্ত্বাবধানভিত্তিক শিক্ষণের মাধ্যমে প্রশিক্ষিত এবং একই সঙ্গে শব্দার্থ, উচ্চারণ, কণ্ঠস্বর, বক্তা ও ধ্বনিতাত্ত্বিক পরিবেশের তথ্য ধারণ করতে পারে। এটি প্রচলিত Whisper+BEATs দ্বৈত এনকোডার পদ্ধতির বিকল্প হিসেবে কাজ করে এবং স্থাপত্য সরল করার পাশাপাশি বিভিন্ন ক্ষেত্রে আরও ভারসাম্যপূর্ণ সক্ষমতা বজায় রাখে।
বহুস্তরীয় বৈশিষ্ট্য-সমন্বয় (MLF) অ্যাডাপ্টার: SPEAR-এর বিভিন্ন স্তরের এনকোড করা তথ্যের স্তরভেদে পার্থক্য রয়েছে—প্রাথমিক স্তর ধ্বনিতাত্ত্বিক ও উচ্চারণের সূক্ষ্মতা ধরে রাখে, মধ্যস্তর কণ্ঠস্বর ও বক্তার তথ্য বহন করে, আর গভীর স্তর শব্দার্থিক ধারণা সঞ্চয় করে। MLF অ্যাডাপ্টার প্রথমে প্রতিটি স্তরের লুকানো অবস্থা স্তর-স্বাভাবিকীকরণ ও সংযোজনের মাধ্যমে একত্র করে, এরপর শেখনযোগ্য নিম্ন-প্রক্ষেপণ ও ফ্রেম-গ্রুপ সংকোচনের মধ্য দিয়ে যায়। সবশেষে সমন্বিত স্তরভিত্তিক উপস্থাপনাকে ভাষা মডেলের এমবেডিং স্পেসে রূপান্তর করা হয়, যাতে মডেল কাজের প্রয়োজন অনুযায়ী বিভিন্ন স্তরের ধ্বনিতাত্ত্বিক সংকেত নমনীয়ভাবে ব্যবহার করতে পারে।
টাইমস্ট্যাম্প সংযোজন পদ্ধতি: মডেল টাইমস্ট্যাম্পকে স্বাভাবিক ভাষার টেক্সট আকারে, যেমন <2.0 seconds>, সরাসরি অডিও সিকোয়েন্সে প্রবেশ করায় এবং অডিও এমবেডিংয়ের সঙ্গে পালাক্রমে ভাষা মডেলে ইনপুট দেয়। ফলে অতিরিক্ত টাইমস্ট্যাম্প-নির্দিষ্ট এমবেডিং স্তর ছাড়াই একই জেনারেশন কাঠামোর মধ্যে সময় নির্ধারণের কাজ সম্পন্ন করা যায়।
বহুমাত্রিক প্রাসঙ্গিক শিক্ষণ (MICL) প্রশিক্ষণ: প্রাসঙ্গিক বক্তৃতা শনাক্তকরণে মডেল শুধু টেক্সট-ভিত্তিক পক্ষপাত শব্দতালিকা গ্রহণ করে না, একই সঙ্গে ওই শব্দগুলোর রেফারেন্স উচ্চারণের অডিওও বহুমাত্রিক প্রাসঙ্গিকতা হিসেবে গ্রহণ করে। প্রশিক্ষণের সময় বিভ্রান্তিকর শব্দ ও লক্ষ্য শব্দ এলোমেলোভাবে বাদ দেওয়ার কৌশল ব্যবহার করা হয়, যাতে অতিরিক্ত পক্ষপাত রোধ হয় এবং মডেল ধ্বনিতাত্ত্বিক প্রমাণের ভিত্তিতে প্রাসঙ্গিক সংকেত যথাযথভাবে ব্যবহার করতে শেখে।
04SALMONN-2 কীভাবে ব্যবহার করবেন
রিপোজিটরি访问 ও কোড ক্লোন করুন: GitHub রিপোজিটরি https://github.com/bytedance/SALMONN/tree/salmonn2-এ প্রবেশ করে git clone ব্যবহার করে কোড স্থানীয়ভাবে ডাউনলোড করুন।
রানটাইম পরিবেশ তৈরি করুন: conda create -n salmonn2 python=3.10 চালিয়ে ভার্চুয়াল পরিবেশ তৈরি ও সক্রিয় করুন, এরপর pip, setuptools এবং wheel আপগ্রেড করুন।
নির্ভরতা ও প্রকল্প ইনস্টল করুন: রিপোজিটরির মূল目录তে pip install -r requirements.txt এবং pip install -e . --no-deps চালিয়ে SALMONN-2 ও এর রানটাইম নির্ভরতা ইনস্টল করুন।
প্রশিক্ষিত ওজন ডাউনলোড করুন: HuggingFace CLI-এর মাধ্যমে মডেল চেকপয়েন্ট ডাউনলোড করুন: hf download marcoyang/SALMONN-2-8B --repo-type model --local-dir /path/to/salmonn-2-hf।
মডেল লোড করে ইনফারেন্স চালান: AutoProcessor ও AutoModelForCausalLM ব্যবহার করে স্থানীয় ওজন লোড করুন, অডিও ফাইল ও নির্দেশনামূলক টেক্সট দিন এবং model.generate() কল করে অডিও অনুধাবনের ফলাফল পান।
05SALMONN-2-এর মূল সুবিধা
ডেটা-সাশ্রয়ী: প্রায় 1.8万 ঘণ্টা তত্ত্বাবধানভিত্তিক ডেটা ব্যবহার করে, যা একই আকারের প্রতিদ্বন্দ্বী মডেলগুলোর প্রচলিত কয়েক লাখ থেকে কয়েক মিলিয়ন ঘণ্টার তুলনায় অনেক কম এবং লেবেলিংয়ের খরচ উল্লেখযোগ্যভাবে কমায়।
আরও ভারসাম্যপূর্ণ একীভূত ফ্রন্টএন্ড: একক SPEAR স্ব-তত্ত্বাবধানভিত্তিক এনকোডার দ্বৈত এনকোডারের বিকল্প হিসেবে কাজ করে এবং বক্তৃতা, পরিবেশগত শব্দ, সংগীত ও প্যারালিঙ্গুইস্টিক কাজের মধ্যে আরও ভারসাম্যপূর্ণ ফল দেয়।
স্তরভিত্তিক তথ্যের পূর্ণ ব্যবহার: MLF অ্যাডাপ্টার এনকোডারের সব স্তরের বৈশিষ্ট্য একত্র করে, ফলে শুধু শেষ স্তর ব্যবহার করার কারণে ধ্বনিতাত্ত্বিক বা কণ্ঠস্বরের মতো গুরুত্বপূর্ণ সূক্ষ্মতা হারায় না।
বিস্তৃত অডিও বিশ্লেষণ সক্ষমতা: সাধারণ ALLM-এ প্রথমবারের মতো SED, জালিয়াতি শনাক্তকরণ ও SQA-এর মতো আগে উপেক্ষিত শব্দ বিশ্লেষণ কাজ পদ্ধতিগতভাবে সমর্থন করে।
স্কেল করা যায়: টেক্সট ভিত্তিকে 8B থেকে 30B-A3B-তে সম্প্রসারণের পর তিনটি সামগ্রিক বেঞ্চমার্কেই স্কোর ধারাবাহিকভাবে বেড়েছে, যা স্থাপত্যটির ভালো scale-up সম্ভাবনা প্রমাণ করে।
06SALMONN-2-এর প্রকল্প ঠিকানা
GitHub রিপোজিটরি: https://github.com/bytedance/SALMONN/tree/salmonn2
HuggingFace মডেল রিপোজিটরি: https://huggingface.co/marcoyang/SALMONN-2-8B
arXiv প্রযুক্তিগত গবেষণাপত্র: https://arxiv.org/pdf/2607.17079
07SALMONN-2-এর ব্যবহারক্ষেত্র
স্মার্ট মিটিং সহকারী: সভার বিষয়বস্তু তাৎক্ষণিকভাবে প্রতিলিপি করে এবং অংশগ্রহণকারীদের উচ্চারণের উদাহরণ ব্যবহার করে বিদেশি নাম ও পেশাগত পরিভাষা নির্ভুলভাবে শনাক্ত করে।
অডিও কনটেন্ট পর্যালোচনা: লাইভস্ট্রিম বা পডকাস্টের অস্বাভাবিক শব্দ-ঘটনা স্বয়ংক্রিয়ভাবে শনাক্ত করে এবং প্রতারণা প্রতিরোধে গভীর জালিয়াতি করা বক্তৃতা চিহ্নিত করে।
বক্তৃতার গুণমান পর্যবেক্ষণ: গ্রাহকসেবা কল ও রেকর্ডিং স্টুডিওর উপকরণের গুণমান স্বয়ংক্রিয়ভাবে স্কোর করে এবং শব্দ ও বিকৃতির অংশ শনাক্ত করে।
মাল্টিমিডিয়া আর্কাইভ অনুসন্ধান: ঐতিহাসিক অডিও ও সম্প্রচার অনুষ্ঠানের জন্য টাইমস্ট্যাম্পসহ ঘটনা-বর্ণনা তৈরি করে এবং বিষয়বস্তু-ভিত্তিক নির্ভুল অনুসন্ধান সম্ভব করে।
শ্রবণপ্রতিবন্ধী সহায়ক ডিভাইস: পরিবেশের শব্দ-ঘটনা, যেমন দরজার ঘণ্টা ও সতর্কসংকেত, টেক্সট ও টাইমস্ট্যাম্পের মাধ্যমে শ্রবণপ্রতিবন্ধী ব্যবহারকারীদের তাৎক্ষণিকভাবে জানায়।
© দাবিত্যাগ: সময়ের সঙ্গে ডোমেইন ও লিংক করা কনটেন্ট পরিবর্তিত হতে পারে। AIEZZ তৃতীয় পক্ষের ওয়েবসাইট নিয়ন্ত্রণ করে না। বাহ্যিক কনটেন্ট ও ঝুঁকি স্বাধীনভাবে পর্যালোচনা করুন।
ব্যবহারকারীর রিভিউ0