
- মাসিক ভিজিট
- 0
- মূল্য
- সেট করা হয়নি
- তালিকাভুক্ত
- —
- আপডেট করা হয়েছে
- 2026-09-08
01LLaDA-Image কী
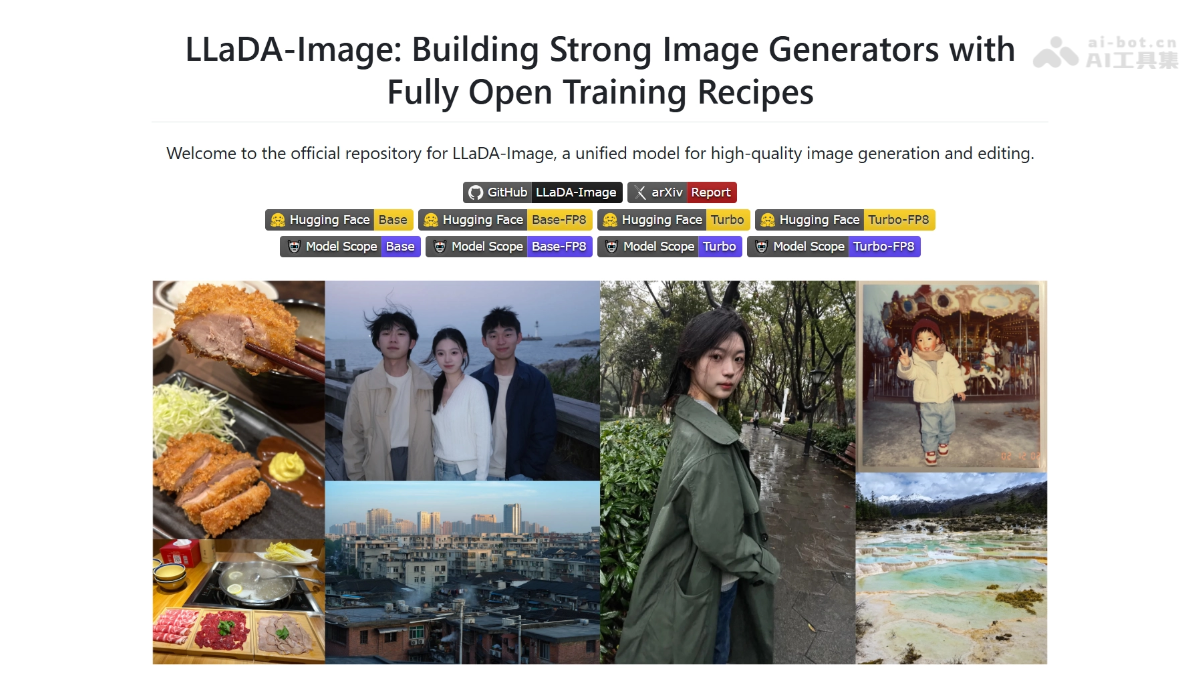
LLaDA-Image হলো Ant Group-এর inclusionAI-এর ওপেন-সোর্স করা 6B প্যারামিটারের সমন্বিত ইমেজ জেনারেশন ও এডিটিং মডেল। মডেলটি প্রথমে বিশুদ্ধ ছবি দিয়ে প্রি-ট্রেনিং, পরে ভাষাগত অ্যালাইনমেন্টের উদ্ভাবনী পদ্ধতি অনুসরণ করে এবং সম্পূর্ণ ডিফিউশন আর্কিটেকচার (LLaDA2.0-mini বোঝাপড়া + 6B DiT জেনারেশন) ব্যবহার করে টেক্সট-টু-ইমেজ, নির্দেশনাভিত্তিক সম্পাদনা এবং চীনা ও ইংরেজি টেক্সট রেন্ডারিং সমর্থন করে। Turbo সংস্করণে মাত্র 2–4 ধাপে ছবি তৈরি করা যায় এবং Qwen-Image-Bench-এর চীনা ও ইংরেজি উভয় ট্র্যাকেই ওপেন-সোর্স মডেলগুলোর মধ্যে প্রথম হয়েছে।
02LLaDA-Image-এর প্রধান ফিচার
টেক্সট-টু-ইমেজ জেনারেশন: প্রাকৃতিক ভাষার বর্ণনা অনুযায়ী উচ্চ বিশ্বস্ততা ও সমৃদ্ধ বিবরণসহ ফটোরিয়েলিস্টিক ছবি তৈরি করে।
নির্দেশনাভিত্তিক ইমেজ এডিটিং: রেফারেন্স ছবি আপলোড করে প্রাকৃতিক ভাষায় নির্দেশনা দিলে নির্দিষ্ট অংশ নিখুঁতভাবে পরিবর্তন করে এবং বাকি অংশ অপরিবর্তিত রাখে।
চীনা ও ইংরেজি দ্বিভাষিক টেক্সট রেন্ডারিং: তৈরি ছবিতে চীনা ও ইংরেজি টেক্সট নির্ভুলভাবে উপস্থাপন করে; পোস্টার, লেআউট এবং আর্টিস্টিক টেক্সট ডিজাইন সমর্থন করে।
VQ কন্ডিশনাল জেনারেশন: ভিজ্যুয়াল কোয়ান্টাইজেশন (VQ) token-কে কন্ডিশনাল ইনপুট হিসেবে ব্যবহার করে নিয়ন্ত্রিত ছবি তৈরি করে।
রেফারেন্স ছবি সম্পাদনা: আপলোড করা ছবিকে রেফারেন্স হিসেবে ব্যবহার করে স্টাইল ট্রান্সফার, কনটেন্ট পরিবর্তনসহ বিভিন্ন সম্পাদনা করা যায়।
Turbo দ্রুত ইনফারেন্স: ডিস্টিলড মডেলটি মাত্র 2–4 ধাপ স্যাম্পলিংয়ে 1024×1024 উচ্চমানের ছবি তৈরি করতে পারে।
03LLaDA-Image-এর প্রযুক্তিগত নীতি
WeChat-এ ফলো করে “开源” লিখে রিপ্লাই দিন, AI ওপেন-সোর্স প্রকল্পের আলোচনা গ্রুপে যোগ দিন
সম্পূর্ণ ডিফিউশন সমন্বিত আর্কিটেকচার: মডেলটি LLaDA2.0-mini বোঝাপড়া মডিউল (MoE-ভিত্তিক ডিফিউশন ভাষা মডেল) এবং 6B DiT জেনারেশন মডিউল নিয়ে গঠিত। উভয়ের ব্যাকএন্ডই ডিফিউশন মডেল; Connector-এর মাধ্যমে সংযুক্ত হয়ে সেমান্টিক বোঝাপড়া ও পিক্সেল জেনারেশনকে আলাদা করে।
পর্যায়ভিত্তিক প্রশিক্ষণ কৌশল: “আগে আঁকা শেখা, পরে নির্দেশ মানা শেখা” পদ্ধতিতে প্রথমে বিশুদ্ধ ইমেজ প্রি-ট্রেনিং ও মধ্যবর্তী প্রশিক্ষণের মাধ্যমে শক্তিশালী ভিজ্যুয়াল জেনারেশন প্রায়র তৈরি করা হয়, তারপর জোড়া ভাষাগত তত্ত্বাবধান যুক্ত করে টেক্সট-ভিশন অ্যালাইনমেন্ট সম্পন্ন করা হয়।
উচ্চমানের ডেটা নির্মাণ: জেনারেশন প্রশিক্ষণে মোট প্রায় 2.2 কোটি নমুনা ব্যবহার করা হয়েছে, যার 98% বাস্তব ছবি। ভাষাগত অ্যালাইনমেন্ট পর্যায়ের ছবি-টেক্সট বর্ণনা Qwen সিরিজের বড় মডেল দিয়ে তৈরি ও যাচাই করা হয়, যাতে নির্দেশনা অনুসরণের নির্ভুলতা নিশ্চিত হয়।
দক্ষ প্রশিক্ষণ অপ্টিমাইজেশন: সম্পূর্ণ পাইপলাইনে প্যারামিটার-স্বাধীন RMSNorm দিয়ে LayerNorm প্রতিস্থাপন করা হয়েছে এবং Muon অপ্টিমাইজার ব্যবহার করা হয়েছে, ফলে বৃহৎ পরিসরের প্রশিক্ষণের স্থিতিশীলতা ও দক্ষতা বাড়ে।
Twin-DMD দ্রুত ডিস্টিলেশন: Turbo সংস্করণে Twin-DMD ডিস্টিলেশন প্রযুক্তির মাধ্যমে Base মডেল সংকুচিত করা হয়েছে। 2–4 ধাপ স্যাম্পলিংয়ে 1024×1024 উচ্চমানের ছবি তৈরি করা যায়, ফলে গতি ও মানের ভারসাম্য বজায় থাকে।
04LLaDA-Image কীভাবে ব্যবহার করবেন
পরিবেশ সেটআপ: Python 3.11, PyTorch 2.8, Diffusers 0.39.0 এবং FlashAttention 2.8.3সহ প্রয়োজনীয় নির্ভরতা ইনস্টল করে স্থানীয় ইনফারেন্স পরিবেশ তৈরি করুন।
ওজন সংগ্রহ: Hugging Face বা ModelScope থেকে LLaDA-Image (উচ্চ বিশ্বস্ততা সংস্করণ) অথবা LLaDA-Image-Turbo (দ্রুত সংস্করণ)-এর মডেল ফাইল ডাউনলোড করুন।
টেক্সট থেকে ছবি তৈরি: মডেল লোড করার পর বর্ণনামূলক টেক্সট ইনপুট দিন। Base সংস্করণে 50 ধাপ ও guidance scale 5.0, Turbo সংস্করণে 2–4 ধাপ ও guidance scale 1.0 সেট করে 1024×1024 ছবি তৈরি করুন।
নির্দেশনা দিয়ে ছবি সম্পাদনা: রেফারেন্স ছবি আপলোড করে প্রাকৃতিক ভাষায় সম্পাদনার নির্দেশনা দিন, যেমন “পটভূমি সমুদ্রতটে পরিবর্তন করুন”। মডেল স্বয়ংক্রিয়ভাবে অপরিবর্তিত অংশগুলো আগের মতো রাখবে।
আকারের নিয়ম: টেক্সট-টু-ইমেজ ও VQ কন্ডিশনাল জেনারেশনের ইনপুট আকার 16-এর গুণিতক হতে হবে; এডিটিং কাজের ক্ষেত্রে 32-এর গুণিতক হতে হবে।
05LLaDA-Image-এর মূল সুবিধা
ওপেন-সোর্স কর্মদক্ষতায় এগিয়ে: Qwen-Image-Bench-এর চীনা ও ইংরেজি উভয় ট্র্যাকেই ওপেন-সোর্স মডেলগুলোর মধ্যে প্রথম এবং FLUX.2 Max-এর মতো প্রধান ওপেন-সোর্স মডেলগুলোকেও সামগ্রিক স্কোরে ছাড়িয়ে গেছে।
সমন্বিত জেনারেশন ও এডিটিং: একটি মডেলেই উচ্চমানের টেক্সট-টু-ইমেজ এবং সূক্ষ্ম নির্দেশনাভিত্তিক ইমেজ এডিটিং সমর্থন করে; আলাদা মডেল পরিবর্তনের প্রয়োজন নেই।
দ্রুত ইনফারেন্স: Turbo ডিস্টিলড সংস্করণটি মাত্র 2–4 ধাপ স্যাম্পলিংয়ে 1024×1024 উচ্চ বিশ্বস্ততার ছবি তৈরি করতে পারে, ফলে অপেক্ষার সময় উল্লেখযোগ্যভাবে কমে।
চীনা ও ইংরেজি টেক্সট রেন্ডারিং: চীনা ও ইংরেজি টেক্সট তৈরিতে অসাধারণ দক্ষতা রয়েছে; পোস্টার, লেআউট ও আর্টিস্টিক টেক্সটের মতো ডিজাইন কাজেও কার্যকর।
ফটোরিয়েলিস্টিক বাস্তবতা: 98% বাস্তব ছবিভিত্তিক প্রি-ট্রেনিং ডেটার কারণে তৈরি ছবিতে প্রাকৃতিক আলো, সমৃদ্ধ বিবরণ এবং উচ্চ বাস্তবতা দেখা যায়।
06LLaDA-Image-এর প্রকল্পের ঠিকানা
GitHub রিপোজিটরি:https://github.com/inclusionAI/LLaDA-Image
HuggingFace মডেল সংগ্রহ:https://huggingface.co/collections/inclusionAI/llada-image
arXiv প্রযুক্তিগত গবেষণাপত্র:https://arxiv.org/pdf/2609.03796
07LLaDA-Image-এর ব্যবহারক্ষেত্র
ই-কমার্স ভিজ্যুয়াল ডিজাইন: পণ্যের বর্ণনা অনুযায়ী এক ক্লিকেই প্রোডাক্টের প্রধান ছবি তৈরি করা যায়, অথবা নির্দেশনার মাধ্যমে দ্রুত পটভূমি পরিবর্তন ও আলো-ছায়া সমন্বয় করা যায়, ফলে ফটোগ্রাফি ও পোস্ট-প্রসেসিংয়ের খরচ কমে।
মার্কেটিং পোস্টার তৈরি: চীনা ও ইংরেজি টেক্সট রেন্ডারিংয়ের দক্ষতা ব্যবহার করে ব্র্যান্ডের Slogan ও প্রচারণার তথ্যসহ বাণিজ্যিক পোস্টার এবং সামাজিক যোগাযোগমাধ্যমের ছবি সরাসরি তৈরি করা যায়।
সামাজিক যোগাযোগমাধ্যমের কনটেন্ট তৈরি: ব্লগার ও কনটেন্ট নির্মাতাদের জন্য ফটোরিয়েলিস্টিক প্রতিকৃতি, দৃশ্য ও লাইফস্টাইল ছবি তৈরি করা যায়; স্টাইলভিত্তিক সম্পাদনা এবং দ্রুত ছবি তৈরিও সমর্থিত।
গেম ও চলচ্চিত্রের কনসেপ্ট ডিজাইন: টেক্সটের ভিত্তিতে দ্রুত চরিত্র ও দৃশ্যের কনসেপ্ট ছবি তৈরি করা যায় এবং নির্দেশনার মাধ্যমে বিবরণ পুনরায় সম্পাদনা করে প্রাথমিক সৃজনশীল প্রক্রিয়া ускорিত করা যায়।
ব্যক্তিগত ছবি সম্পাদনা: ছবি আপলোড করে প্রাকৃতিক ভাষার নির্দেশনায় অবাঞ্ছিত বস্তু অপসারণ, আকাশ পরিবর্তন, রঙ সমন্বয়সহ নানা কাজ করা যায়। অপরিবর্তিত অংশ আগের মতো থাকে, ফলে জটিল ছবি সম্পাদনা সফটওয়্যারের বিকল্প হিসেবে ব্যবহার করা যায়।
© দাবিত্যাগ: সময়ের সঙ্গে ডোমেইন ও লিংক করা কনটেন্ট পরিবর্তিত হতে পারে। AIEZZ তৃতীয় পক্ষের ওয়েবসাইট নিয়ন্ত্রণ করে না। বাহ্যিক কনটেন্ট ও ঝুঁকি স্বাধীনভাবে পর্যালোচনা করুন।
ব্যবহারকারীর রিভিউ0