
- মাসিক ভিজিট
- 0
- মূল্য
- সেট করা হয়নি
- তালিকাভুক্ত
- —
- আপডেট করা হয়েছে
- 2026-10-11
01PixelUMM কী
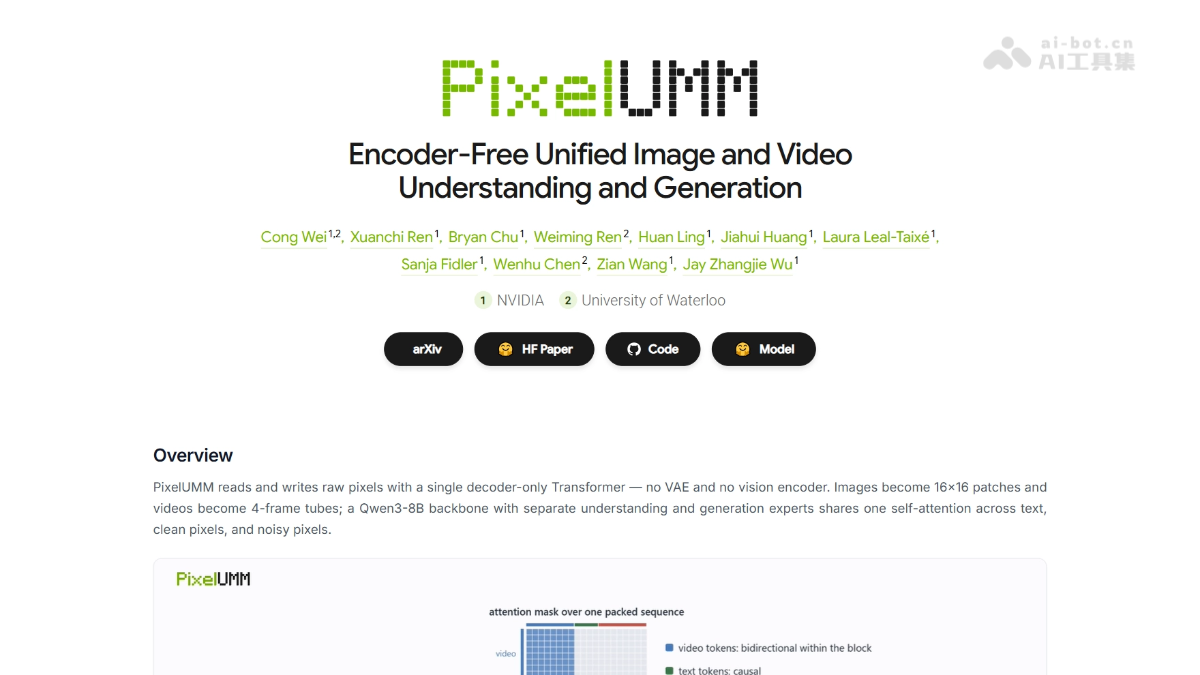
PixelUMM হলো NVIDIA ও ইউনিভার্সিটি অব ওয়াটারলুর যৌথভাবে প্রকাশিত একটি এনকোডারবিহীন ইউনিফায়েড মাল্টিমোডাল মডেল। এর মূল উদ্ভাবন হলো VAE ও ভিশন এনকোডার সম্পূর্ণ অপসারণ করে একটি Decoder-only Transformer-এর মাধ্যমে সরাসরি কাঁচা পিক্সেল স্পেসে ছবি ও ভিডিও পড়া ও লেখা। বোঝা ও তৈরি করার কাজ একই ডিকোডার এবং self-attention ভাগ করে। ছবি 16×16 patch এবং ভিডিও 4 ফ্রেমের tubelet-এ বিভক্ত করা হয়। কোড উন্মুক্ত করা হয়েছে।
02PixelUMM-এর প্রধান ফিচার
টেক্সট থেকে ভিডিও (T2V): সর্বোচ্চ 832×464 রেজোলিউশন, 96 ফ্রেম এবং 24fps-এ 4 সেকেন্ডের ভিডিও তৈরি করতে পারে; ছবির মান প্রধান ভিডিও ডিফিউশন মডেলগুলোর সমতুল্য।
টেক্সট থেকে ছবি (T2I): একই মডেলের মধ্যে সরাসরি ছবি তৈরি করে; আলাদা ইমেজ শাখা বা ডিকোডারের প্রয়োজন হয় না।
ছবি বোঝা: VQA, OCR, চার্ট, ডকুমেন্টসহ 21টি ইমেজ আন্ডারস্ট্যান্ডিং কাজ সম্পন্ন করতে পারে এবং 8B-স্তরের VLM-এর গড় মানে পৌঁছায়।
ভিডিও বোঝা: MVBench, Video-MME-এর মতো ভিডিও প্রশ্নোত্তর বেঞ্চমার্ক সমর্থন করে এবং dense ও sparse—দুটি ইনপুট মোড দেয়।
ছবি থেকে ভিডিও (I2V): পরিষ্কার প্রথম ফ্রেমের ছবিকে বোঝার বিশেষজ্ঞের শর্ত হিসেবে ইনজেক্ট করে পরবর্তী ভিডিও তৈরি করা যায়; শর্তযুক্ত ফ্রেমকে VAE-তে এনকোড করার প্রয়োজন নেই।
ভিডিও সম্পাদনা: ইনপুট ভিডিওকে ভিজ্যুয়াল শর্ত হিসেবে ব্যবহার করে মাল্টিমোডাল কনটেক্সট কন্ডিশনিংয়ের মাধ্যমে সম্পাদনা-সংক্রান্ত কাজ সম্পন্ন করে।
03PixelUMM-এর প্রযুক্তিগত নীতি
এনকোডারবিহীন আর্কিটেকচার: PixelUMM প্রচলিত ইউনিফায়েড মডেলের VAE ও ভিশন এনকোডার সম্পূর্ণ সরিয়ে দিয়েছে। ছবি সরাসরি 16×16 patch এবং ভিডিও 4 ফ্রেমের tubelet-এ বিভক্ত হয়ে কাঁচা RGB পিক্সেল হিসেবে ইনপুট হয়; আউটপুটও লিনিয়ার হেডের মাধ্যমে সরাসরি পিক্সেল রিগ্রেশন করে। পুরো প্রক্রিয়ায় latent স্পেসের এনকোডিং-ডিকোডিংজনিত ক্ষতি নেই, ফলে সত্যিকারের end-to-end পিক্সেল পড়া ও লেখা সম্ভব হয়।
MoT শেয়ার্ড অ্যাটেনশন কাঠামো: মডেলটি Qwen3-8B-কে ভিত্তি করে Mixture-of-Transformers তৈরি করে। বোঝার বিশেষজ্ঞ ও জেনারেশন বিশেষজ্ঞের FFN আলাদা হলেও তারা একই self-attention ভাগ করে। ফলে টেক্সট, পরিষ্কার পিক্সেল ও নয়েজযুক্ত পিক্সেল একই অ্যাটেনশন স্পেসে পারস্পরিক ক্রিয়া করতে পারে এবং একটি মডেলের মধ্যে বোঝা ও তৈরি একীভূত হয়।
পিক্সেল স্পেস ডিফিউশন প্রশিক্ষণ: জেনারেশন কাজ পিক্সেল স্পেসেই flow-matching ধরনের প্রশিক্ষণ ব্যবহার করে। Ablation পরীক্ষায় দেখা গেছে, পিক্সেল স্পেস ও VAE স্পেসের গ্রেডিয়েন্ট নর্ম প্রায় একই, তবে পিক্সেল স্পেসের প্রশিক্ষণ বেশি স্থিতিশীল। কম্প্রেশন-রেট পরীক্ষায় আরও প্রমাণিত হয়েছে যে 16×16 patch ও 4 ফ্রেমের tubelet শেখার কঠিনতা ও দক্ষতার সর্বোত্তম ভারসাম্য দেয়।
মাল্টিমোডাল কন্ডিশন ইনজেকশন: টেক্সট কন্ডিশন, রেফারেন্স ছবি ও ইনপুট ভিডিওর মতো “পরিষ্কার শর্ত” বোঝার বিশেষজ্ঞের মাধ্যমে যায়, আর তৈরি হওয়ার অপেক্ষায় থাকা নয়েজযুক্ত token জেনারেশন বিশেষজ্ঞের মাধ্যমে যায়। দুটিই শেয়ার্ড অ্যাটেনশনে একীভূত হয়। এর ফলে SenseNova-U1-এর encoder-free কন্ডিশন পদ্ধতি ছবি থেকে ভিডিও ও ভিডিও সম্পাদনায় সম্প্রসারিত হয়েছে। Ablation পরীক্ষায় দেখা গেছে, এই নকশা বোঝার ক্ষমতা ক্ষতিগ্রস্ত করে না এবং চারটি ভিডিও বেঞ্চমার্কে 0.89–3.49 পয়েন্ট উন্নতি আনে।
লিনিয়ার আউটপুট হেড ও কনভল্যুশন হেডের তুলনা: ডিফল্ট হালকা লিনিয়ার আউটপুট হেড ব্যবহার করলে 16 পিক্সেলের গ্রিড-জাতীয় আর্টিফ্যাক্ট দেখা দিতে পারে। Wan-ধাঁচের আপস্যাম্পলিং কনভল্যুশন হেড ও PixelShuffle হেডের পরীক্ষায় প্রমাণিত হয়েছে যে কনভল্যুশন হেড আর্টিফ্যাক্ট দূর করতে পারে। এর মধ্যে সময়-অগ্রাধিকারপ্রাপ্ত PixelShuffle প্রশিক্ষণ ক্ষতি ও আর্টিফ্যাক্ট দমনের মধ্যে সর্বোত্তম ভারসাম্য দেয়। হেড পরিবর্তন করলে পুনরায় প্রশিক্ষণ প্রয়োজন।
04PixelUMM কীভাবে ব্যবহার করবেন
রিপোজিটরি ক্লোন করুন: git clone https://github.com/nv-tlabs/PixelUMM, তারপর ENVIRONMENT.md অনুসরণ করে CUDA পরিবেশ কনফিগার করুন।
ওজন ডাউনলোড করুন: Hugging Face-এর nvidia/PixelUMM থেকে ডিফল্ট checkpoint S8-F22-R05 ডাউনলোড করুন এবং CHECKPOINT.md অনুসরণ করে Qwen3-8B-এর কনফিগারেশন ও tokenizer ফাইল ডাউনলোড করুন।
পাথ সেট করুন: PIXELUMM_CKPT, PIXELUMM_QWEN_DIR এবং PIXELUMM_OUTPUT—এই তিনটি environment variable-এ স্থানীয় absolute path নির্ধারণ করুন।
checkpoint যাচাই করুন: প্রথমে check_checkpoint.py চালিয়ে ওজনের পূর্ণতা ও tensor সামঞ্জস্য পরীক্ষা করুন।
নিরাপত্তা পর্যালোচনার অনুমতি নিন: Hugging Face-এ nvidia/Cosmos-1.0-Guardrail ব্যবহারের অনুমতি চেয়ে লগ ইন করুন।
ইনফারেন্স চালান: inference.py-তে --task t2i / t2v / image-vlm / video-vlm নির্ধারণ করে prompt, রেজোলিউশন, ফ্রেম সংখ্যা ইত্যাদি প্যারামিটারসহ ছবি, ভিডিও তৈরি বা বোঝার ফলাফল বের করুন।
ব্যাচ জেনারেশন (ঐচ্ছিক): YAML prompt ফাইলের সঙ্গে inference_batch.py ব্যবহার করে ব্যাচে কাজ চালান।
টয় ট্রেনিং (ঐচ্ছিক): TRAIN.md অনুসরণ করে toy ডেটাসেট ডাউনলোড করুন এবং train_toy.py দিয়ে F22 checkpoint-এর ভিত্তিতে চারটি কাজের প্রশিক্ষণ উদাহরণ চালান।
05PixelUMM-এর মূল সুবিধা
সম্পূর্ণ এনকোডারবিহীন আর্কিটেকচার: VAE ও ভিশন এনকোডার সরিয়ে সরাসরি কাঁচা পিক্সেল স্পেসে পড়া ও লেখা হয়, ফলে latent স্পেসের এনকোডিং-ডিকোডিংজনিত তথ্যের ক্ষতি ও আর্টিফ্যাক্টের উৎস দূর হয়।
বোঝা ও তৈরি একীভূত: একটি decoder-only Transformer একই সঙ্গে টেক্সট থেকে ছবি, টেক্সট থেকে ভিডিও, ছবি বোঝা এবং ভিডিও বোঝার চারটি প্রধান কাজ সম্পন্ন করে। বোঝার বিশেষজ্ঞ ও জেনারেশন বিশেষজ্ঞ একই self-attention ভাগ করে।
সরল আর্কিটেকচার, সরাসরি ইনফারেন্স: হালকা লিনিয়ার হেড সরাসরি পিক্সেল রিগ্রেশন করে, অতিরিক্ত ডিকোডারের প্রয়োজন নেই এবং জেনারেশন প্রক্রিয়া সংক্ষিপ্ত।
নমনীয় ও কার্যকর কন্ডিশন ইনজেকশন: রেফারেন্স ছবি ও ইনপুট ভিডিওর মতো পরিষ্কার শর্ত বোঝার বিশেষজ্ঞের মাধ্যমে ব্যবহার করেই ছবি থেকে ভিডিও ও ভিডিও সম্পাদনা করা যায়। Ablation পরীক্ষায় প্রমাণিত হয়েছে যে এই নকশা বোঝার ক্ষমতা ক্ষতিগ্রস্ত করে না।
স্পষ্ট ও সম্প্রসারণযোগ্য প্রশিক্ষণ নিয়ম: একই ক্ষতিতে পৌঁছাতে 8B মডেলের প্রায় 1.7B মডেলের এক-তৃতীয়াংশ প্রশিক্ষণ ধাপই যথেষ্ট, যা স্কেলিংয়ের স্পষ্ট সুবিধা দেখায়।
06PixelUMM-এর প্রকল্প ঠিকানা
প্রকল্পের ওয়েবসাইট: https://nv-tlabs.github.io/PixelUMM/
GitHub রিপোজিটরি: https://github.com/nv-tlabs/PixelUMM
HuggingFace মডেল রিপোজিটরি: https://huggingface.co/nvidia/PixelUMM
arXiv প্রযুক্তিগত গবেষণাপত্র: https://arxiv.org/pdf/2609.38597
07PixelUMM-এর ব্যবহারের ক্ষেত্র
স্বল্পদৈর্ঘ্য ভিডিও কনটেন্ট তৈরি: একটি বাক্যের নির্দেশনা দিয়ে সরাসরি 4 সেকেন্ডের 24fps ভিডিও তৈরি করা যায়, যা সামাজিক মাধ্যমে দ্রুত কনটেন্ট তৈরির জন্য উপযোগী।
ছবি থেকে ভিডিও ও ভিডিও সম্পাদনা: প্রথম ফ্রেম বা মূল ভিডিওকে শর্ত হিসেবে ব্যবহার করে কনটেন্ট তৈরি বা পরিবর্তন করা যায়, যা ই-কমার্স পণ্যের গতিশীল প্রদর্শন ও চলচ্চিত্রের প্রিভিজুয়ালাইজেশনে কাজে লাগে।
দীর্ঘ ভিডিও বোঝা ও প্রশ্নোত্তর: ইনপুট ভিডিওর বর্ণনা, সারাংশ ও সময়ক্রমিক যুক্তি বিশ্লেষণ করা যায়, যা কনটেন্ট পর্যালোচনা, উপকরণ খোঁজা ও মিটিংয়ের কার্যবিবরণীতে উপযোগী।
ডকুমেন্ট ও চার্ট বিশ্লেষণ: OCRBench 78.0 এবং DocVQA 90.4 স্কোর রসিদ শনাক্তকরণ, রিপোর্টভিত্তিক প্রশ্নোত্তরসহ কর্পোরেট ডকুমেন্ট বুদ্ধিমত্তার বিভিন্ন কাজে সহায়তা করতে পারে।
© দাবিত্যাগ: সময়ের সঙ্গে ডোমেইন ও লিংক করা কনটেন্ট পরিবর্তিত হতে পারে। AIEZZ তৃতীয় পক্ষের ওয়েবসাইট নিয়ন্ত্রণ করে না। বাহ্যিক কনটেন্ট ও ঝুঁকি স্বাধীনভাবে পর্যালোচনা করুন।
ব্যবহারকারীর রিভিউ0