
- মাসিক ভিজিট
- 0
- মূল্য
- সেট করা হয়নি
- তালিকাভুক্ত
- —
- আপডেট করা হয়েছে
- 2026-10-30
01Nemotron 3.5 Transcribe কী
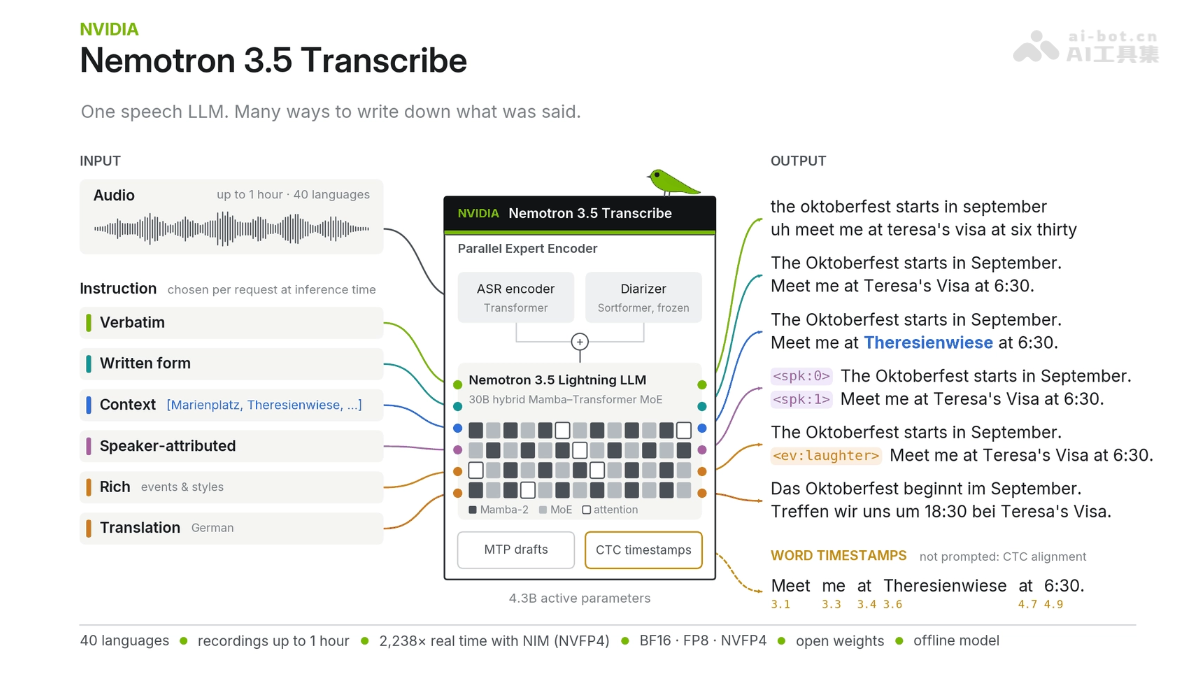
Nemotron 3.5 Transcribe হলো NVIDIA-এর তৈরি একটি ওপেন-সোর্স স্পিচ লার্জ মডেল। এতে স্পিচ এনকোডার ও MoE আর্কিটেকচার ব্যবহার করা হয়েছে, সক্রিয় প্যারামিটার প্রায় ৪.৩ বিলিয়ন। এটি ৪০টি ভাষা সমর্থন করে এবং সর্বোচ্চ ১ ঘণ্টার, সর্বাধিক ৮ জন বক্তার অডিও প্রক্রিয়া করতে পারে। এতে হুবহু ট্রান্সক্রিপশন, বক্তা শনাক্তকরণ, অনুবাদসহ বিভিন্ন সুবিধা রয়েছে। Nemotron 3.5 Transcribe প্রাকৃতিক ভাষার নির্দেশনার মাধ্যমে আউটপুটের ফরম্যাট নির্ধারণ করতে পারে, ফাইন-টিউনিংয়ের মাধ্যমে নির্দিষ্ট পেশাগত ক্ষেত্রের সঙ্গে মানিয়ে নেওয়া যায় এবং বাণিজ্যিক ব্যবহারের জন্য বিনামূল্যে।
02Nemotron 3.5 Transcribe-এর প্রধান বৈশিষ্ট্য
বহুভাষিক ট্রান্সক্রিপশন: ৪০টি ভাষা সমর্থন করে এবং অডিওকে পাঠ্যে রূপান্তর করতে পারে, এমনকি কথ্য ভাষায় ব্যবহৃত ভাষাও শনাক্ত করতে পারে।
বক্তা শনাক্তকরণ: সর্বাধিক ৮ জন বক্তাকে আলাদা করতে পারে এবং প্রতিটি বাক্যের বক্তা চিহ্নিত করে, যা সভা ও বহু-বক্তার সাক্ষাৎকারের জন্য উপযোগী।
দীর্ঘ অডিও প্রক্রিয়াকরণ: একবারে সর্বোচ্চ প্রায় ১ ঘণ্টার রেকর্ডিং প্রক্রিয়া করতে পারে।
নির্দেশনাভিত্তিক ট্রান্সক্রিপশন: প্রাকৃতিক ভাষায় আউটপুটের ফরম্যাট নির্ধারণ করা যায়, যেমন হুবহু ট্রান্সক্রিপ্ট, লিখিত ভাষায় সম্পাদনা, কথার অপ্রয়োজনীয় অংশ বাদ দেওয়া বা পরিভাষার বানান নির্ধারণ; পুনরায় প্রশিক্ষণের প্রয়োজন নেই।
স্পিচ অনুবাদ: ৩১টি ভাষা ও ইংরেজির মধ্যে পারস্পরিক অনুবাদ করতে পারে।
শব্দ-স্তরের টাইমস্ট্যাম্প: প্রতিটি শব্দের সংশ্লিষ্ট অডিও অবস্থান ফেরত দেয়, ফলে পুনরায় শোনা ও অনুসন্ধান সহজ হয়।
ক্ষেত্রভিত্তিক ফাইন-টিউনিং: NeMo Speech টুলকিটের মাধ্যমে অল্প ডেটা ব্যবহার করে একক GPU-তে দ্রুত পেশাগত ক্ষেত্রের সঙ্গে মানিয়ে নেওয়া যায়।
03Nemotron 3.5 Transcribe-এর প্রযুক্তিগত নীতি
WeChat-এ ফলো করে “开源” লিখে উত্তর পাঠান, AI ওপেন-সোর্স প্রকল্পের আলোচনা গ্রুপে যোগ দিন।
স্পিচ-অগমেন্টেড ল্যাঙ্গুয়েজ মডেল (SALM): মডেলটি তিনটি অংশ নিয়ে গঠিত। Transformer স্পিচ এনকোডার অডিও বৈশিষ্ট্য আহরণ করে, একটি ফ্রোজেন Nemotron 3 স্পিকার ডায়ারাইজেশন মডেল বক্তার সক্রিয়তার তথ্য দেয়, এবং উভয় অংশ Nemotron 3.5 Lightning 30B-A3B মিশ্র Mamba-Transformer MoE লার্জ ল্যাঙ্গুয়েজ মডেলে যুক্ত হয়। মোট প্যারামিটার প্রায় ৩৪ বিলিয়ন হলেও প্রতিটি ইনফারেন্সে প্রায় ৪.৩ বিলিয়ন প্যারামিটার সক্রিয় হয়, ফলে সক্ষমতা ও দক্ষতার মধ্যে ভারসাম্য থাকে।
সমান্তরাল বিশেষজ্ঞ এনকোডার: ফ্রোজেন ডায়ারাইজেশন মডেলের আউটপুট বক্তার সক্রিয়তার সংকেত ASR এনকোডারের উপস্থাপনায় যুক্ত হয়। ফলে একক LLM আর্কিটেকচারেই পরিবর্তন ছাড়াই বক্তা-চিহ্নিত ট্রান্সক্রিপশন সম্পন্ন করা যায় এবং সিরিয়ালাইজড আউটপুট পদ্ধতিতে প্রশিক্ষণ দেওয়া যায়।
সুপারভাইজড ব্যালান্সড মিক্সিং: প্রশিক্ষণ ডেটা নমুনার সংখ্যা নয়, উত্তরের token-এর পরিমাণ অনুযায়ী স্যাম্পল করা হয়। প্রতিটি ASR নমুনা একাধিক কাজের নির্দেশনার সঙ্গে ব্যবহার করা যায়, ফলে নতুন সক্ষমতা যুক্ত করতে ১%-এরও কম স্যাম্পলিং হার যথেষ্ট। পুরো প্রশিক্ষণ দুটি ধাপে হয়: সুপারভাইজড ফাইন-টিউনিং এবং একটি সংক্ষিপ্ত রিইনফোর্সমেন্ট লার্নিং ধাপ, যা সরাসরি ট্রান্সক্রিপশন নির্ভুলতা উন্নত করে।
MTP স্পেকুলেটিভ ডিকোডিং: প্রশিক্ষণের সময় মডেলটি মাল্টি-token প্রেডিকশন (MTP) লক্ষ্য অনুযায়ী যৌথভাবে অপ্টিমাইজ করা হয়। তাই এর নিজস্ব MTP স্তর vLLM-এর স্পেকুলেটিভ ডিকোডিংয়ের ড্রাফট মডেল হিসেবে সরাসরি কাজ করতে পারে। পাশাপাশি বিকল্প হিসেবে একটি DFlash2 ড্রাফট মডেলও দেওয়া হয়। উভয়টি একসঙ্গে ব্যবহার করলে একক RTX PRO 6000 Blackwell GPU-তে প্রতি সেকেন্ডে ২২৩৮ সেকেন্ড অডিও ট্রান্সক্রাইব করার থ্রুপুট পাওয়া যায়।
CTC টাইমস্ট্যাম্প অ্যাডাপ্টার: ডিকোডিংয়ের পর একটি হালকা CTC অ্যাডাপ্টার তৈরি টেক্সটকে অডিওর সঙ্গে সামঞ্জস্য করে। এর মাধ্যমে দীর্ঘ অডিও ও ব্যাপকভাবে ওভারল্যাপ করা কথোপকথনের জন্য বক্তা-চিহ্নিত শব্দ-স্তরের টাইমস্ট্যাম্প তৈরি করা যায়, মূল মডেলের ওপর অতিরিক্ত চাপ না দিয়ে।
04Nemotron 3.5 Transcribe কীভাবে ব্যবহার করবেন
হার্ডওয়্যার প্রস্তুত করুন: BF16 সংস্করণের জন্য প্রায় ৮০GB VRAM প্রয়োজন। কম হার্ডওয়্যার প্রয়োজনের জন্য FP8/NVFP4 বা GGUF সংস্করণ বেছে নেওয়া যায়।
মডেল সংগ্রহ করুন: Hugging Face বা ModelScope-এ NVIDIA-Nemotron-3.5-Transcribe-30B-A4B খুঁজে OpenMDW-1.1 লাইসেন্স অনুযায়ী ওজন ডাউনলোড করুন।
পরিবেশ ইনস্টল করুন: তিনটির যেকোনো একটি পদ্ধতি বেছে নিন: Nemotron Transcribe NIM (অফিশিয়াল কনটেইনার), vLLM (MTP অ্যাক্সিলারেশন সমর্থিত), অথবা NeMo-Speech.cpp (GGUF-এর মাধ্যমে স্থানীয় রান)।
অডিও প্রস্তুত করুন: সর্বোচ্চ ১ ঘণ্টার রেকর্ডিং ফাইল আপলোড করুন এবং ব্যবহৃত ফ্রেমওয়ার্কের প্রয়োজন অনুযায়ী ফরম্যাট রূপান্তর করুন।
প্রম্পট লিখুন: প্রাকৃতিক ভাষায় কাজটি জানান, যেমন “হুবহু বক্তব্য রাখুন এবং বক্তা চিহ্নিত করুন” বা “কথার অপ্রয়োজনীয় অংশ বাদ দিয়ে ইংরেজিতে অনুবাদ করুন”।
ইনফারেন্স চালান: অডিও ও প্রম্পট API-তে পাঠান। মডেল ট্রান্সক্রিপশন ফেরত দেবে এবং প্রয়োজন হলে বক্তার লেবেল ও শব্দ-স্তরের টাইমস্ট্যাম্পও দেবে।
(ঐচ্ছিক) দ্রুত অভিজ্ঞতা: ডিপ্লয় করতে না চাইলে Hugging Face-এর nvidia/nemotron-transcribe অভিজ্ঞতা স্পেসে অনলাইনে চেষ্টা করুন।
(ঐচ্ছিক) ক্ষেত্রভিত্তিক ফাইন-টিউনিং: NeMo Speech টুলকিট ব্যবহার করে লেবেলযুক্ত ডেটা প্রস্তুত করুন। একক GPU-তে প্রায় ০.৫–২.৩ ঘণ্টায় নিজস্ব উচ্চারণ, পরিভাষা ও ফরম্যাটের সঙ্গে মানিয়ে নেওয়া যায়।
05Nemotron 3.5 Transcribe-এর মূল সুবিধা
নির্দেশনাভিত্তিক আউটপুট: একটি প্রাকৃতিক ভাষার বাক্যেই হুবহু ট্রান্সক্রিপ্ট, সম্পাদিত ট্রান্সক্রিপ্ট বা অনুবাদের মতো বিভিন্ন ফরম্যাটে পরিবর্তন করা যায়। পুনরায় প্রশিক্ষণ বা একাধিক মডেল কনফিগার করার প্রয়োজন নেই।
উচ্চ ট্রান্সক্রিপশন নির্ভুলতা: ইংরেজি Open ASR বেঞ্চমার্কে গড় WER মাত্র ৪.৭১% এবং বহুভাষিক বেঞ্চমার্কে ৪.৬২%; উভয় ক্ষেত্রেই ওপেন-ওয়েট মডেলগুলোর মধ্যে প্রথম।
উন্নত বক্তা শনাক্তকরণ: ওভারল্যাপ করা বহু-বক্তার অডিওর চিহ্নিত ট্রান্সক্রিপশন কাজে প্রথমবার বিশেষায়িত ক্যাসকেড সিস্টেমকে ছাড়িয়ে গেছে এবং সর্বোচ্চ ১ ঘণ্টা ও ৮ জন বক্তার পরিস্থিতি সমর্থন করে।
শক্তিশালী প্রসঙ্গভিত্তিক সংশোধন: পরিভাষা ও ব্যক্তিনামের মতো সত্তার তালিকা দিলে নামযুক্ত সত্তার ত্রুটির হার ৬ গুণ কমতে পারে; পেশাগত শব্দ অনুমানের ওপর নির্ভর করতে হয় না।
বক্তা-চিহ্নিত শব্দ-স্তরের টাইমস্ট্যাম্প: হালকা CTC অ্যালাইনমেন্ট ট্রান্সক্রিপশনকে পুনরায় শোনা ও অনুসন্ধানের উপযোগী করে, যা সরাসরি কোর্স রিপ্লে ও সভা অনুসন্ধানের মতো কাজে সহায়তা করে।
উচ্চ ইনফারেন্স দক্ষতা: নেটিভ MTP স্পেকুলেটিভ ডিকোডিং ও DFlash2 ড্রাফট মডেল ব্যবহার করে একক RTX PRO 6000 প্রতি সেকেন্ডে ২২৩৮ সেকেন্ড অডিও প্রক্রিয়া করতে পারে।
06Nemotron 3.5 Transcribe-এর প্রকল্প ঠিকানা
Hugging Face মডেল রিপোজিটরি: https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
প্রযুক্তিগত গবেষণাপত্র: https://research.nvidia.com/labs/nemotron/files/NVIDIA-Nemotron-3.5-Transcribe-Technical-Report.pdf
07Nemotron 3.5 Transcribe-এর প্রয়োগক্ষেত্র
সভা সংক্ষিপ্তসার ও সিদ্ধান্ত আহরণ: স্বয়ংক্রিয়ভাবে বক্তাদের আলাদা করে, আলোচনার মূল বক্তব্য সংরক্ষণ করে এবং নির্দেশনা অনুযায়ী সভার সিদ্ধান্ত ও করণীয় বিষয় বের করে।
মিডিয়া সাক্ষাৎকার ও সংবাদ সম্পাদনা: সাক্ষাৎকারদাতার বক্তব্য হুবহু সংরক্ষণ করে বক্তা চিহ্নিত করে, ফলে উদ্ধৃতি নির্ভুল থাকে। প্রয়োজনে কথার অপ্রয়োজনীয় অংশও বাদ দেওয়া যায়।
ক্লাস ও প্রশিক্ষণ রিপ্লে: শব্দ-স্তরের টাইমস্ট্যাম্পসহ ট্রান্সক্রিপ্ট তৈরি করে, যাতে শিক্ষার্থীরা সরাসরি কীওয়ার্ড খুঁজে শিক্ষক ওই বিষয়টি ব্যাখ্যা করার মুহূর্তে যেতে পারে।
চিকিৎসা ও পেশাগত ক্ষেত্রের রেকর্ড: পরিভাষার তালিকা ও ক্ষেত্রভিত্তিক ফাইন-টিউনিংয়ের সঙ্গে ব্যবহার করে চিকিৎসক ও রোগীর কথোপকথন নির্ধারিত ফরম্যাটে মেডিকেল রেকর্ডে রূপান্তর করা যায়, ফলে পেশাগত শব্দের ত্রুটির হার কমে।
বহুভাষিক কনটেন্ট স্থানীয়করণ: ৪০টি ভাষার অডিও সরাসরি ইংরেজি লেখায় অনুবাদ করা যায়, যা আন্তর্জাতিক সভা, সাক্ষাৎকার বা ভিডিও সাবটাইটেল তৈরিতে ব্যবহার করা যায়।
© দাবিত্যাগ: সময়ের সঙ্গে ডোমেইন ও লিংক করা কনটেন্ট পরিবর্তিত হতে পারে। AIEZZ তৃতীয় পক্ষের ওয়েবসাইট নিয়ন্ত্রণ করে না। বাহ্যিক কনটেন্ট ও ঝুঁকি স্বাধীনভাবে পর্যালোচনা করুন।
ব্যবহারকারীর রিভিউ0