

স্বতন্ত্র সাইট পরিচালনা করার সময় আমি发现 করলাম, প্রতি সপ্তাহের সোমবার সকালে একই কাজই করছি।
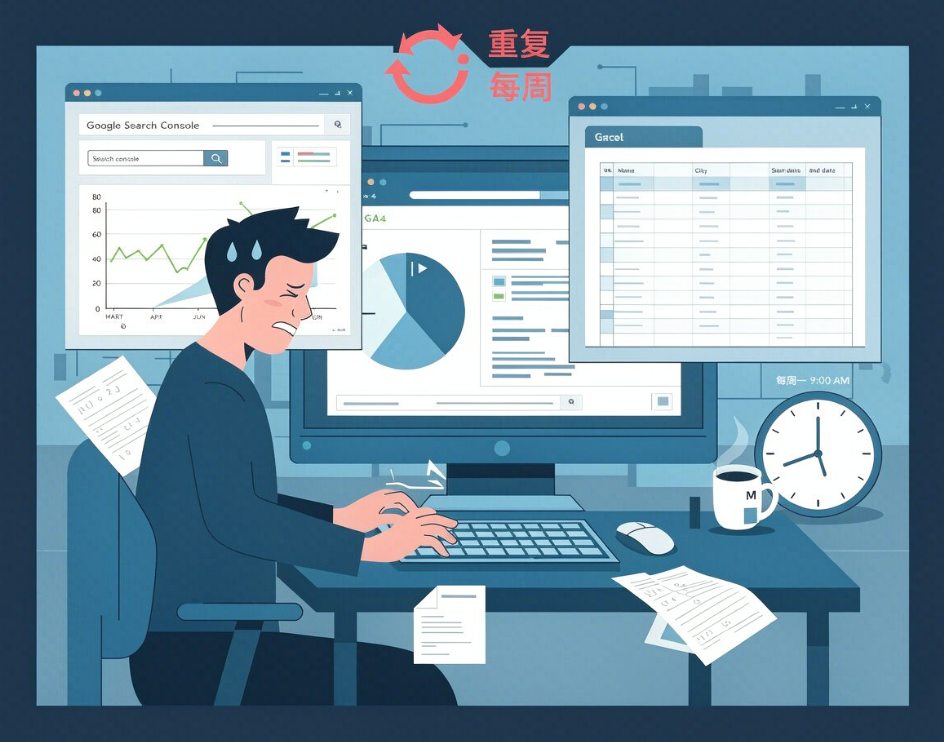
Google Search Console খুলে গত মাসের সার্চ-কোয়েরি ডেটা হাতে করে এক্সপোর্ট করা। GA4 খুলে ট্রাফিকের শীর্ষ 50টি ল্যান্ডিং পেজ CSV হিসেবে এক্সপোর্ট করা। Excel দিয়ে দুটি টেবিল একত্র করা—GSC-এর ইমপ্রেশন ও ক্লিক এবং GA4-এর সেশন ও কনভার্সন URL অনুযায়ী মিলিয়ে নেওয়া। তারপর হাতে রঙ চিহ্নিত করা: ট্রাফিক কমলে লাল, কনভার্সন রেট গড়ের নিচে হলে হলুদ।
পুরো প্রক্রিয়ায় প্রায় দেড় ঘণ্টা লাগত। শেষ করে গ্রুপে পাঠালে ক্লায়েন্টের উত্তর আসত, "পেয়েছি"।
তিন বছর ধরে প্রতি সপ্তাহে এই কাজই করেছি।
গত মাস পর্যন্ত। প্রযুক্তি নিয়ে কাজ করা এক বন্ধু আমার স্ক্রিনে একবার তাকিয়ে এমন একটি কথা বলল, যা আমাকে বেশ আঘাত করেছিল: "তোমার এই কাজটা তো শুধু API কানেক্ট করার ব্যাপার, প্রতি সপ্তাহে হাতে করে করছ কেন?"
আমি কিছুক্ষণ স্তব্ধ হয়ে গেলাম। সে ঠিকই বলেছিল। GSC এবং GA4-এর API আছে, তা আমি জানতাম না এমন নয়। সমস্যা ছিল, প্রতিবার "API কল করার জন্য স্ক্রিপ্ট লেখা" ভাবলেই মাথায় পুরো একটি সফটওয়্যারের ছবি ভেসে উঠত—Python লেখা, অথেন্টিকেশন সামলানো, পেজিনেশন সামলানো, ফিল্ড ম্যাপিং করা, ফ্রন্টএন্ডে দেখানোর ব্যবস্থা করা… সব মিলিয়ে সত্যিই সময় বাঁচত, কিন্তু শুরু করার খরচ এত বেশি মনে হতো যে আমি সবসময় কাজটি পিছিয়ে দিতাম।
পরিবর্তনের মোড় কোথায়? Codex।
১. আগে বলি Codex কী—এবং কেন এটি ChatGPT নয়
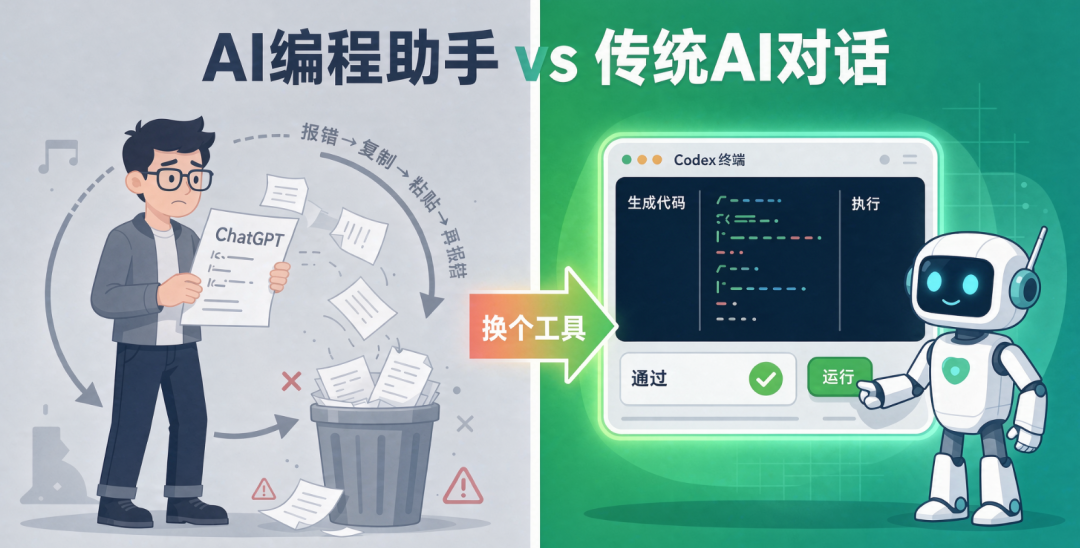
AI দিয়ে কোড লেখার কথা শুনলে অনেকের প্রথম প্রতিক্রিয়া হয়, "ChatGPT-কে দিয়ে একটা স্ক্রিপ্ট লিখিয়ে নিই"। আমিও চেষ্টা করেছি। ChatGPT আপনাকে এক টুকরো কোড দেয়, আপনি সেটি এডিটরে পেস্ট করেন, এনভায়রনমেন্ট সেট করেন, ডিপেন্ডেন্সি ইনস্টল করেন, এরর চালান, এররটি আবার কপি করে তাকে দিয়ে ঠিক করান, তারপর আবার চালান, আবার এরর… সাত-আটবার এভাবে ঘুরতে হয়। হাতে করে ডেটা এক্সপোর্ট করার চেয়েও ক্লান্তিকর।
Codex-এর ভূমিকা একেবারেই আলাদা। এটি টার্মিনালে সরাসরি চলা একটি প্রোগ্রামিং Agent—এর নিজস্ব স্বাধীন স্যান্ডবক্স পরিবেশ আছে, ফাইল পড়তে ও লিখতে পারে, প্যাকেজ ইনস্টল করতে পারে, কমান্ড চালাতে পারে, এরর সামলাতে পারে। শুরু থেকে শেষ পর্যন্ত আপনাকে কোড কপি-পেস্ট করতে হয় না। আপনি স্বাভাবিক ভাষায় একটি নির্দেশ দেন, আর এটি নিজেই পরিকল্পনা করে, লেখে, চালায় এবং ঠিক করে।
উদাহরণ হিসেবে, আমি তাকে যে এক বাক্যের নির্দেশ দিয়েছিলাম তা হলো:
"GSC-এর গত 28 দিনের সার্চ-কোয়েরি ডেটা এক্সপোর্ট করে GA4-এর ল্যান্ডিং পেজ ডেটার সঙ্গে URL অনুযায়ী মিলিয়ে, সবচেয়ে বেশি ট্রাফিক কমেছে এমন শীর্ষ 20টি পেজের একটি টেবিল তৈরি করো।"
এটি নিজে নিজে নিচের কাজগুলো সম্পন্ন করেছে:
•বর্তমান পরিবেশে Google API-এর Python লাইব্রেরি আছে কি না পরীক্ষা করেছে, না থাকলে নিজেই ইনস্টল করেছে•আমার GSC ও GA4 অথেন্টিকেশন ফাইলের পাথ পড়ে OAuth সামলেছে•GSC API কল করে কোয়েরি ও পেজ ডাইমেনশনের ডেটা এনেছে, স্বয়ংক্রিয়ভাবে পেজিনেশন সামলেছে•GA4 Data API কল করে ল্যান্ডিং পেজ ডাইমেনশনের সেশন ও কনভার্সন এনেছে•URL পরিষ্কার করেছে (প্যারামিটার বাদ দিয়েছে, শেষের স্ল্যাশ বাদ দিয়েছে, www প্রিফিক্স এক করেছে)•URL অনুযায়ী ইন্টারসেকশন করে প্রতিটি পেজের ইমপ্রেশন-ক্লিক-কনভার্সন ফানেল হিসাব করেছে•ট্রাফিক কমার পরিমাণ অনুযায়ী সাজানো একটি Markdown টেবিল তৈরি করেছে
পুরো সময় আমি পাশে বসে স্ক্রিন দেখেছি, আর এটি নিজেই সব শেষ করেছে। মাঝখানে GA4 API-এর তারিখের ফরম্যাট নিয়ে একবার এরর হয়েছিল। এটি এরর মেসেজ পড়ে নিজেই ঠিক করেছে, আবার চালিয়েছে, এবং সফল হয়েছে।
🔴 AI প্রোগ্রামিং টুলের পার্থক্য "কোড লিখতে পারে কি না"—এখানে নয়, সবাই পারে। আসল বিষয় হলো "নিজে নিজে কাজটি সফলভাবে চালাতে পারে কি না"।
২. Codex দিয়ে GSC+GA4 ডেটা ক্লোজড লুপ চালানোর সম্পূর্ণ প্রক্রিয়া
নিচে বাস্তবে যে ক্রমে কাজ করেছি, সেই অনুযায়ী পুরো প্রক্রিয়াটি কীভাবে তৈরি করেছি তা দেখাচ্ছি। তত্ত্ব নয়, প্রতিটি ধাপ আমি টার্মিনালে সত্যিই চালিয়েছি।
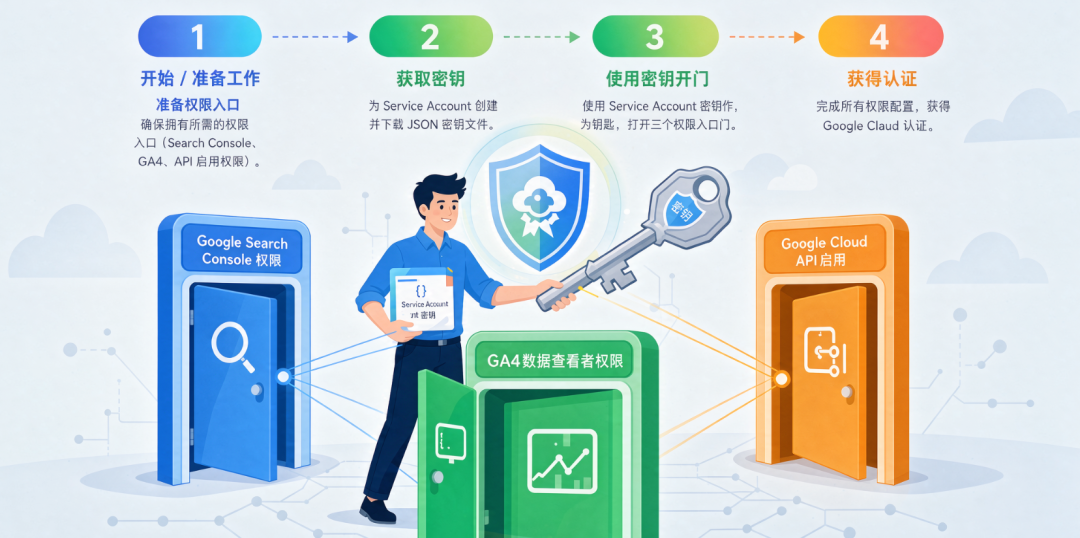
১. প্রস্তুতি: Google Cloud অথেন্টিকেশন
এটি এড়ানো যায় না। GSC ও GA4-এর API-তে Google Cloud-এর OAuth অথবা Service Account অথেন্টিকেশন ব্যবহার করতে হয়। AI ব্যবহার করুন বা না করুন, এই ধাপটি হাতে করতেই হবে।
আমি যা করেছি:
•Google Cloud Console-এ একটি প্রজেক্ট তৈরি করে Search Console API এবং Google Analytics Data API চালু করেছি•একটি Service Account তৈরি করে JSON key ফাইলটি স্থানীয় কম্পিউটারে ডাউনলোড করেছি•GSC-তে ওই Service Account-এর ইমেইলকে "Restricted user" (সম্পূর্ণ অনুমতি) হিসেবে যোগ করেছি•GA4-এর অ্যাডমিন প্যানেলে ওই ইমেইলকে "Data viewer" হিসেবে যোগ করেছি
এই ধাপে Codex আপনাকে সাহায্য করতে পারে না—অথেন্টিকেশন ও অনুমোদন হলো মানুষ ও সিস্টেমের পারস্পরিক প্রক্রিয়া; Google-এর অনুমোদন পেজে ক্লিক করার কাজটি এটি আপনার হয়ে করতে পারে না। তবে পরের প্রতিটি ধাপে, অথেন্টিকেশন ফাইলের পাথ সঠিক থাকলে, এটি নির্বিঘ্নে সংযুক্ত হতে পারে।
⚠️ বেশিরভাগ API অটোমেশন কোডের কারণে প্রথমে আটকে যায় না, আটকে যায় অনুমতির কারণে। Google-এর পারমিশন সিস্টেমটি রুশ পুতুলের মতো—GSC-এর একটি প্রবেশপথ, GA4-এর আরেকটি, Google Cloud-এর আরও একটি; তিনটির অনুমতি পরস্পরের সঙ্গে সংযুক্ত নয়। এই ধাপটি ধৈর্য ধরে শেষ করলে পরের কাজ সহজ হয়ে যায়।
২. প্রথম Skill: GSC সার্চ-কোয়েরি ডেটা আনা
Codex-এর কাজের পদ্ধতি হলো—আপনি একগুচ্ছ কাজকে একটি পুনর্ব্যবহারযোগ্য Skill (দক্ষতা ফাইল) হিসেবে প্যাকেজ করে ~/.codex/skills/ ডিরেক্টরিতে রাখতে পারেন। একই Skill প্রতিবার চালালে এটি একই যুক্তি অনুযায়ী কাজ সম্পন্ন করে।
আমি প্রথমে সবচেয়ে সহজ সংস্করণটি লিখেছিলাম: শুধু GSC-এর সার্চ-কোয়েরি ডাইমেনশনের ডেটা আনা।
এই Skill Codex-কে তিনটি বিষয় জানায়: কোন API ব্যবহার করতে হবে, কোন ডাইমেনশন নিতে হবে এবং কোন ফরম্যাটে আউটপুট দিতে হবে। একবার চালানোর পর প্রায় 40 সেকেন্ডে এটি শীর্ষ 100টি সার্চ-কোয়েরির একটি তালিকা তৈরি করল, যেখানে ক্লিক, ইমপ্রেশন, CTR এবং গড় অবস্থান ছিল।
আমি ফলাফলটি গত মাসে হাতে এক্সপোর্ট করা CSV-এর সঙ্গে মিলিয়ে দেখলাম—ডেটা সম্পূর্ণ এক ছিল। তখন মনে হলো, "হাতে কাজ করার যুগ শেষ"।
তবে পুরোপুরি নির্ভুল ছিল না। GSC API-এর একটি সমস্যা আছে: ডিফল্টভাবে এটি সর্বোচ্চ 1000টি সারি দেয়, এর বেশি হলে পেজ পরিবর্তন করতে হয়। প্রথমবার চালানোর সময় আমার সাইটে এক মাসে 3400-এর বেশি কোয়েরি ছিল। Codex নিজেই বুঝল যে ফেরত আসা সারির সংখ্যা মিলছে না, পেজিনেশন লজিক যোগ করে আবার চালাল, এবং দ্বিতীয়বার পুরো ডেটা পেল।
এটি নিজেই সমস্যা শনাক্ত করেছে। নিজেই ঠিক করেছে। ChatGPT দিয়ে স্ক্রিপ্ট লেখানোর অভিজ্ঞতা থেকে এটি সম্পূর্ণ আলাদা।
৩. দ্বিতীয় Skill: GA4 সংযুক্ত করা
GSC ডেটা আনার পর আমি তাকে GA4-এর ল্যান্ডিং পেজ ডেটাও আনতে বললাম।
এটির জটিলতা অনেক বেশি। GA4 Data API-তে আপনাকে নিজে একটি "ডেটা রিকোয়েস্ট বডি" তৈরি করতে হয়—কোন ডাইমেনশন (landingPage), কোন মেট্রিক (sessions, conversions, eventCount), তারিখের সীমা এবং ফিল্টার শর্ত নির্ধারণ করতে হয়। রিকোয়েস্ট বডির JSON কাঠামো GSC-এর থেকে সম্পূর্ণ আলাদা। তাছাড়া GA4-এর প্রতিক্রিয়ায় ফিল্ডের নাম eventName_xxx ধরনের দীর্ঘ ফরম্যাটে থাকে, যা নিজে পার্স করতে হয়।
GA4 API পড়া ও লেখার সময় Codex-এর পদ্ধতি আমাকে বিশেষভাবে মুগ্ধ করেছে। এটি যান্ত্রিকভাবে নির্দেশ অনুযায়ী API কল করেনি; কল করার আগে Schema অনুসন্ধান করেছে: GA4 Metadata API কল করে ওই property-তে কোন কোন ডাইমেনশন ও মেট্রিক আছে, ফিল্ডের নাম কীভাবে গঠিত হয়—সব একবার দেখে নিয়ে তারপর রিকোয়েস্ট বডি তৈরি করেছে।
💡 "আগে পরিস্থিতি বোঝা, তারপর কাজ শুরু করা"—নতুন API সংযুক্ত করার সময় একজন প্রকৃত মানুষের কাজের পদ্ধতিও এমনই। AI এটিকে স্বয়ংক্রিয় করেছে।
দুটি Skill চালানোর পর আমি দুটি টেবিল পেলাম:
•GSC কোয়েরি ডাইমেনশন: কীওয়ার্ড, পেজ URL, ক্লিক, ইমপ্রেশন, CTR, গড় অবস্থান•GA4 ল্যান্ডিং পেজ ডাইমেনশন: পেজ URL, সেশন, কনভার্সন, গড় এনগেজমেন্ট সময়
এরপর ছিল একত্র করার পালা।
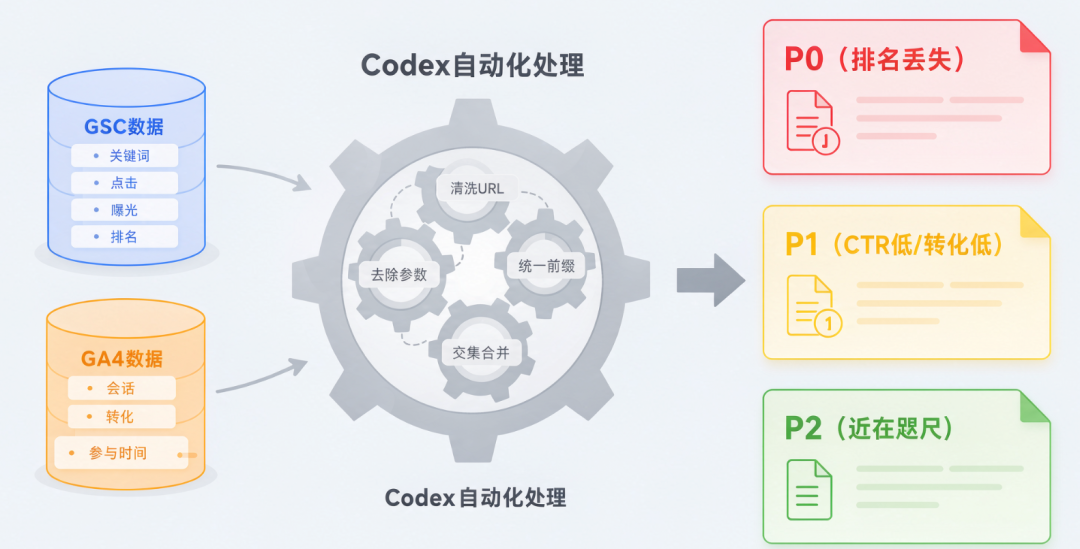
৪. একত্র করা—দুটি টেবিল থেকে অগ্রাধিকার-সাজানো Todo
দুটি টেবিল একত্র করা শুনতে সহজ—URL-এর সঙ্গে URL মিলিয়ে পাশাপাশি বসিয়ে দিলেই হলো। কিন্তু বাস্তবে করতে গিয়ে অসংখ্য ছোট সমস্যা দেখা দেয়।
আমি Codex-কে প্রথমে দুটি টেবিলের ডেটার নমুনা নিজে "দেখতে" বললাম। এটি আবিষ্কার করল: GSC-এর পেজ URL-এ https:// প্রিফিক্স আছে, আর GA4-এর ল্যান্ডিং পেজ পাথে শুধু /blog/seo-guide লেখা। GSC-এর URL-এর শেষে ?utm_source=google কোয়েরি প্যারামিটার আছে, GA4-এ তা আগেই বাদ দেওয়া হয়েছে। আবার কিছু পেজের GSC-তে ডেটা আছে কিন্তু GA4-তে নেই, উল্টোটাও ঘটেছে।
Codex নিজেই এসব পার্থক্যের ডেটা পরিষ্কার করেছে—প্রিফিক্স, প্যারামিটার ও অ্যাঙ্কর বাদ দিয়েছে, শেষের স্ল্যাশ এক করেছে, তারপর ইন্টারসেকশন করে দুটি ডেটাসেট মিলিয়েছে।
মিলানোর পর এটি আমাকে কোনো ঠান্ডা, নিরস Pivot Table দেয়নি; বরং সমস্যার ধরন অনুযায়ী অগ্রাধিকার-চিহ্নিত একটি ডায়াগনস্টিক রিপোর্ট দিয়েছে:
অগ্রাধিকার|পেজের বৈশিষ্ট্য|ডায়াগনসিসের দিক
🔴 P0|ইমপ্রেশন 30%-এর বেশি কমেছে, অবস্থান top5 থেকে top10-এর বাইরে নেমেছে|র্যাঙ্ক হারানো—ব্যাকলিংক ও কনটেন্টের সময়োপযোগিতা পরীক্ষা করুন
🟡 P1|উচ্চ ইমপ্রেশন, কম CTR (CTR গড়ের চেয়ে 50% কম)|শিরোনামের আকর্ষণ কম—Title ও Meta পরিবর্তন করুন
🟡 P1|উচ্চ ক্লিক, কম কনভার্সন (কনভার্সন রেট গড়ের চেয়ে 40% কম)|ল্যান্ডিং পেজের কনভার্সন ক্ষমতা কম—পেজের কনটেন্ট ও CTA পরীক্ষা করুন
🟢 P2|অবস্থান 8-20, উচ্চ সার্চ ভলিউম আছে|লক্ষ্য খুব কাছে—ইন্টারনাল লিংক ও কনটেন্ট শক্তিশালী করুন
📊 দুটি বিচ্ছিন্ন রিপোর্টকে গুরুত্ব অনুযায়ী সাজানো একটি Todo-তে পরিণত করা—"ডেটা ক্লোজড লুপ"-এর আসল অর্থ এটাই। ডেটা দেখার জন্য নয়, কী করা উচিত তা জানার জন্য।
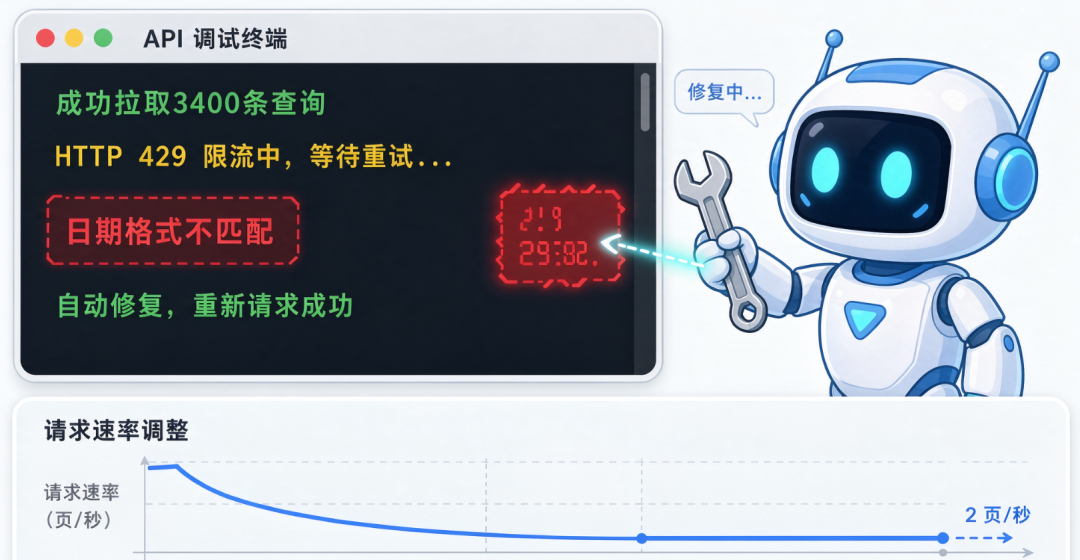
৩. এই প্রক্রিয়ায় বাস্তবে যে সমস্যাগুলোতে পড়েছি
Skill লেখা ও সফলভাবে চালানোর পর ফিরে তাকালে সবকিছুই "স্বাভাবিক" মনে হয়। কিন্তু তখন কয়েকটি বিষয় সত্যিই আমাকে আটকে দিয়েছিল।
সমস্যা এক: GA4-এর মেট্রিকের নাম স্বচ্ছ নয়
GA4 API-তে সেশনের সংখ্যা sessions নামেই আছে, sessions নয়—অর্থাৎ নামটি নিয়ে বিভ্রান্তি তৈরি হতে পারে। কনভার্সনের সংখ্যা conversions নামে নেই; eventCount নামে আছে, তবে শুধু যেসব ইভেন্টকে কনভার্সন হিসেবে চিহ্নিত করেছেন সেগুলোর জন্য। গড় এনগেজমেন্ট সময় avgTimeOnPage নামে নেই; এর নাম userEngagementDuration, এবং সেটিকে নিজে সেশন সংখ্যা দিয়ে ভাগ করতে হয়।
ডকুমেন্টেশন পড়লে অবশ্যই বিষয়গুলো বোঝা যায়—সমস্যা হলো প্রতিটি বিষয় আলাদা করে খুঁজতে এক-দুই ঘণ্টা লেগে যেতে পারে। Codex আমাকে এই সময়টাই বাঁচিয়েছে। API রিকোয়েস্ট তৈরি করার আগে এটি নিজে GA4-এর Metadata ইন্টারফেস কল করে ওই property-তে থাকা সব উপলভ্য মেট্রিকের নাম, ধরন ও বিবরণ সংগ্রহ করেছে, তারপর ইংরেজি অর্থ অনুযায়ী "আমি সেশনের সংখ্যা চাই"—এর সঙ্গে কোন ফিল্ডটি মেলে তা নির্ধারণ করেছে।
সমস্যা দুই: GSC API-এর কোটা সীমা
GSC API-এর দৈনিক কোটা হাতে করে GSC ব্যবহারের মতোই সীমাবদ্ধ। প্রথমবার আমি পেজিনেশন খুব আক্রমণাত্মকভাবে সেট করেছিলাম—একসঙ্গে 20টি পেজ কল করায় সরাসরি rate limit সক্রিয় হয়ে যায়। HTTP 429 পাওয়ার পর Codex কয়েক সেকেন্ড অপেক্ষা করে আবার চেষ্টা করল; দ্বিতীয়বার পেজিনেশনের গতি প্রতি সেকেন্ডে 2 পেজে নামিয়ে দিল, তারপর স্থিতিশীলভাবে চলল।
এই অভিজ্ঞতা আমাকে বুঝিয়েছে—AI যত বুদ্ধিমানই হোক, সে মানুষের লেখা API-ই কল করছে। API-এর rate limit নিয়ম, ডেটা ফরম্যাট ও ফিল্ডের নামের মতো কঠিন কাজগুলো সে আপনার হয়ে সামলাতে পারে, কিন্তু সমস্যাগুলো কোথায় তা আপনার জানা দরকার।
সমস্যা তিন: Codex কখনও কখনও অতিরিক্ত জটিল সমাধান করে
একবার আমি তাকে বলেছিলাম, "ডেটাকে পেজের ধরন অনুযায়ী গ্রুপ করো"—আমার উদ্দেশ্য ছিল URL পাথের /blog/ ও /product/-এর মতো প্রিফিক্স অনুযায়ী ভাগ করা। Codex বুঝল প্রতিটি পেজের HTML কাঠামো পড়ে পেজের ধরন বের করতে হবে। সে সত্যিই তা করল—requests লাইব্রেরি ব্যবহার করে একেকটি HTML পেজ ক্রল করল, meta ট্যাগ ও schema মার্কআপ বিশ্লেষণ করল, তারপর শ্রেণিবিন্যাস করল।
কাজটি সফল হয়েছিল, কিন্তু প্রায় 4 মিনিট লেগে গেল। অথচ আমার আসলে শুধু URL পাথের প্রিফিক্স অনুযায়ী শর্তসাপেক্ষে ভাগ করাই দরকার ছিল।
⚠️ AI-এর সঙ্গে কাজ করার সময় সমস্যার নির্দিষ্টতার মাত্রাই তার দক্ষতা নির্ধারণ করে। আপনি যত নির্দিষ্টভাবে বলবেন, সে তত দ্রুত কাজ করবে। নির্দেশ খুব অস্পষ্ট হলে সে "বোঝার" জন্য সবচেয়ে জটিল পদ্ধতিটি বেছে নিতে পারে—এবং সে যে অপ্রয়োজনীয় ঘুরপথ নিয়েছে, তা সবসময় আপনাকে জানাবে না।
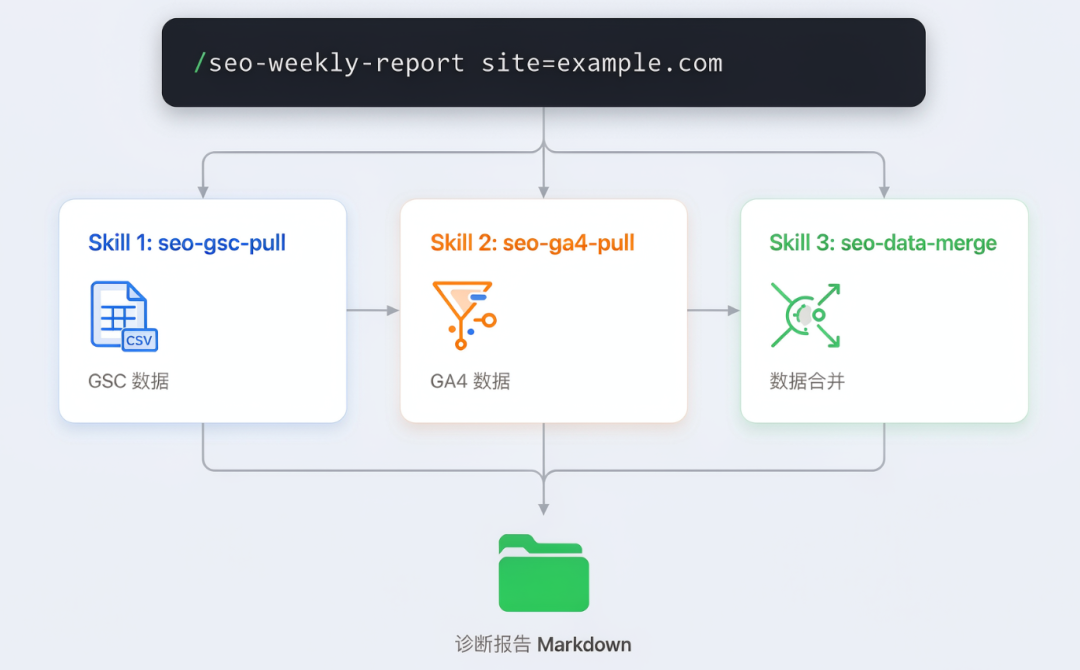
৪. এটিকে কীভাবে "পুনর্ব্যবহারযোগ্য" করা যায়—একবারের স্ক্রিপ্ট নয়
একবার কাজটি সফলভাবে চালানো সহজ। প্রতি সপ্তাহে চালানো যায় এবং অন্য সাইটেও ব্যবহার করা যায় এমন একটি "ডেটা ক্লোজড লুপ" তৈরি করাই আসল মূল্যবান অংশ।
Codex-এর Skill মেকানিজম দিয়ে প্যাকেজ করা
Codex Skill ফাইল সমর্থন করে—~/.codex/skills/ ডিরেক্টরিতে রাখা একটি Markdown ফরম্যাটের নির্দেশনা ফাইল। মূলত এটি অত্যন্ত নির্ভুলভাবে লেখা একটি অপারেশন ম্যানুয়াল। Codex প্রতিবার এই Skill চালানোর সময় একই SOP অনুসরণ করে শুরু থেকে পুরো কাজটি সম্পন্ন করে; "গতবার কিছু সাময়িক পরিবর্তন করেছিলাম কিন্তু ফিরিয়ে দিতে ভুলেছি"—এমন সমস্যাও হয় না।
GSC+GA4-এর ডেটা আনা → পরিষ্কার করা → একত্র করা → ডায়াগনসিস → আউটপুট—এই পুরো প্রক্রিয়াটি আমি তিনটি স্বাধীন Skill-এ ভাগ করেছি:
Skill|কাজ|আউটপুট
seo-gsc-pull|GSC-এর কোয়েরি ও পেজ ডাইমেনশনের ডেটা আনে, স্বয়ংক্রিয়ভাবে পেজ পরিবর্তন করে|দুটি CSV: gsc_queries.csv, gsc_pages.csv
seo-ga4-pull|GA4-এর ল্যান্ডিং পেজ ও কনভার্সন ডেটা আনে, স্বয়ংক্রিয়ভাবে মেট্রিক মিলিয়ে নেয়|ga4_landing.csv
seo-data-merge|তিনটি টেবিল একত্র করে, URL পরিষ্কার করে, ডায়াগনস্টিক অগ্রাধিকার তৈরি করে|Markdown ডায়াগনস্টিক রিপোর্ট+মার্জ করা CSV
তিন ভাগে বিভক্ত করার সুবিধা হলো: GSC-তে সমস্যা হলে শুধু GSC অংশ চালাবেন, GA4-এর কোটা শেষ হলে শুধু GA4 অংশ চালাবেন—একটি অন্যটিকে আটকে রাখবে না। তাছাড়া বিভিন্ন ক্লায়েন্টের সাইটে প্রথম দুটি Skill-এর ডেটা সোর্স আলাদা হলেও তৃতীয় Skill (মার্জ ও ডায়াগনসিস) পুনর্ব্যবহার করা যায়—শুধু সাইটের URL প্যারামিটার পরিবর্তন করলেই হয়।
এক লাইনের কমান্ডে পুরো প্রক্রিয়া চালানো
তিনটি Skill আলাদা করার পর আমি Codex-এ একটি "অর্কেস্ট্রেশন Skill" লিখলাম:
/seo-weekly-report site=example.comCodex এই নির্দেশটি দেখে ক্রমানুসারে তিনটি Skill চালায়—GSC থেকে ডেটা আনা, GA4 থেকে ডেটা আনা এবং ডায়াগনসিস একত্র করা—শেষে টার্মিনালে P0/P1/P2 অনুযায়ী সাজানো একটি পৃষ্ঠা-ভিত্তিক ডায়াগনস্টিক রিপোর্ট আউটপুট দেয়। পুরো প্রক্রিয়াটি চালাতে মোটামুটি 2 মিনিটের একটু বেশি সময় লাগে।
💡 "অটোমেশন" মানে এমন একটি স্ক্রিপ্ট লেখা নয়, যা কখনো নষ্ট হবে না। এর অর্থ হলো বারবার করতে হয় এমন একটি কাজকে এমন একটি প্রক্রিয়ায় রূপান্তর করা, যা একটি বাক্যেই চালু করা যায় এবং ডেটা পরিবর্তনের সঙ্গে মানিয়ে নিতে পারে।
পাঁচ. এই ব্যবস্থা তৈরি করার পর আমার বাস্তব পরিবর্তন
অতিরঞ্জন করছি না, আমার সোমবার সকালের চিত্র পুরোপুরি বদলে গেছে।
আগে:
•GSC ও GA4 ডেটা ম্যানুয়ালি এক্সপোর্ট, পরিষ্কার ও একত্র করতে 40 মিনিট•Excel-এ রঙ দিয়ে অগ্রাধিকার নির্ধারণ করতে 20 মিনিট•একটি "এই সপ্তাহের SEO সারাংশ" লিখে গ্রুপে পাঠাতে 20 মিনিট•ক্লায়েন্টের উত্তর: "পেয়েছি, কষ্ট করেছেন"
এখন:
•সোমবার অফিসে এসে টার্মিনালে এক লাইন /seo-weekly-report লিখি•দুই মিনিট পর ডায়াগনস্টিক রিপোর্ট reports/ ডিরেক্টরিতে তৈরি হয়ে যায়•WeChat-এ কপি-পেস্ট করে, সঙ্গে দুই লাইন মন্তব্য যোগ করে পাঠিয়ে দিই
কিন্তু একই সঙ্গে একটি মজার ব্যাপার ঘটেছে। আগে "অনেকক্ষণ ব্যস্ত থেকে" একটি রিপোর্ট পাঠালে ক্লায়েন্ট মনে করতেন আপনি অনেক কাজ করেছেন। এখন আপনি দুই মিনিটে ফলাফল দেন, কিছু ক্লায়েন্ট উল্টো ভাবেন, "এত দ্রুত? তুমি কি ঠিকমতো দেখেছ?"
মজার শোনাচ্ছে? কিন্তু এটাই বাস্তব মানবিকতা।
তাই এখন আমি কৌশল বদলেছি। রিপোর্ট তৈরি হওয়ার পর P0-এর কয়েকটি পৃষ্ঠা বেছে নিয়ে 15 মিনিট ধরে একেকটি খুলে দেখি, তারপর রিপোর্টে একটি "ম্যানুয়াল রিভিউ মতামত" যোগ করি। এই 15 মিনিট অপচয় নয়—এটি ক্লায়েন্টকে বোঝায় যে "সত্যিই কেউ দেখেছে", এটি AI থেকে বের হওয়া যান্ত্রিক রিপোর্ট নয়।
🔴 AI আপনার হয়ে নোংরা কাজগুলো করে। কিন্তু আপনার বিচারবোধ, আপনার অভিজ্ঞতা এবং আরেকবার দেখে নেওয়ার ইচ্ছা—এসবই অটোমেশনের আওতার বাইরে। আর ঠিক এগুলোকেই ক্লায়েন্টরা সবচেয়ে বেশি গুরুত্ব দেন।

ছয়. যারা এই ব্যবস্থা তৈরি করতে চান, তাদের জন্য কয়েকটি বাস্তব পরামর্শ
আপনিও যদি Codex ব্যবহার করে নিজের SEO ডেটা-চক্র সম্পূর্ণ করতে চান, তাহলে নিচের পরামর্শগুলো আমি বাস্তব অর্থ ও সময় খরচ করে শিখেছি:
① শুরুতেই নিখুঁত করার চেষ্টা করবেন না। আগে শুধু GSC সংযোগ সম্পূর্ণ করুন।
একটি Skill দিয়েই শুরু করুন: গত 28 দিনের সার্চ-কোয়েরি ডেটা এনে CSV আউটপুট দিন। এটি চালু করতে পারলেই আপনার কাছে "সম্পূর্ণ স্বয়ংক্রিয় র্যাঙ্কিং ট্র্যাকিং"-এর সক্ষমতা থাকবে। শূন্য থেকে শুরু করে এটি করতে আমার আধা ঘণ্টা লেগেছিল—যার বেশিরভাগ সময় গেছে Google Cloud-এর অনুমতিতে। প্রথম Skillটি চালু হওয়ার পর মানসিক বাধাটাও আর থাকেনি।
② প্রমাণীকরণ ফাইল ভালোভাবে পরিচালনা করুন—এটাই পুরো প্রক্রিয়ার "মূল দুর্বলতা"।
Google Cloud-এর Service Account JSON কী ফাইল ফাঁস হয়ে গেলে অন্যরা আপনার GSC ও GA4 পড়তে এবং লিখতে পারবে। এই ফাইল Git রিপোজিটরিতে রাখবেন না; পরিবেশ ভেরিয়েবলের মাধ্যমে পাথ রেফার করুন। Codex-এর Skill-এ `${GSC_CREDENTIALS_PATH}`-এর মতো লিখে রেফার করুন, হার্ডকোড করবেন না।
③ Codex-এর লগে প্রতিটি ধাপের সময়কাল আউটপুট করান।
Skill-এ একটি লাইন যোগ করুন: "প্রতিটি ধাপের কাজ শেষ হওয়ার পর সময়কাল রেকর্ড করুন"। দেখানোর জন্য নয়, কোন ধাপটি bottleneck তা জানার জন্য—GSC API ধীরে ডেটা আনছে, GA4-এ বেশি pagination হচ্ছে, নাকি URL পরিষ্কারের লজিক অতিরিক্ত জটিল। জানলেই লক্ষ্যভিত্তিক অপ্টিমাইজ করা যায়।
④ অন্য সাইটে পুনর্ব্যবহারের আগে নিশ্চিত করুন, নতুন ও পুরোনো সাইটের GA4 property structure একই।
একই Skill দিয়ে A ক্লায়েন্টের ক্ষেত্রে ঠিকমতো চলে, কিন্তু B ক্লায়েন্টের ক্ষেত্রে ত্রুটি দেখায়—80% ক্ষেত্রে কারণ হলো দুই GA4 property-র custom dimension এবং event name এক নয়। নতুন সাইটে প্রথমবার চালানোর সময় Codex-কে আগে একবার GA4 Metadata আনতে বলুন, যাতে structure দেখা যায়।
📊 আমার বাস্তব ডেটা: একজন ক্লায়েন্টের জন্য শুরু থেকে পুরো প্রক্রিয়া তৈরি করতে প্রায় 45 মিনিট লাগে (Google-এর অনুমতি সেটআপসহ), এরপর প্রতি সপ্তাহে চালাতে প্রায় 2 মিনিট সময় লাগে।
GitHub-এ কয়েকটি ওপেন-সোর্স Codex SEO Skill আছে, যেগুলো সরাসরি নিয়ে পরিবর্তন করা যায়—owensky-dev একটি seo-gsc-ga4-analyst তৈরি করেছেন, আর AminForou একটি mcp-gsc MCP সার্ভার বানিয়েছেন। আপনাকে শূন্য থেকে চাকা আবিষ্কার করতে হবে না। একটি প্রস্তুত Skill নিয়ে একবার চালিয়ে দেখুন আউটপুট কেমন হয়, তারপর নিজের প্রয়োজন অনুযায়ী পরিবর্তন করুন। শূন্য থেকে লেখার চেয়ে এটি 10 গুণ দ্রুত।
অবশ্য প্রস্তুত Skill থেকে পাওয়া আউটপুট আপনার প্রয়োজনের সঙ্গে পুরোপুরি মানানসই নাও হতে পারে। যেমন owensky-dev-এর Skill ডিফল্টভাবে 90 দিনের ডেটা আনে—আমি নিজে 28 দিনের উইন্ডো বিশ্লেষণ করতে অভ্যস্ত। Skill ফাইলে এমন ছোট পরিবর্তনের জন্য শুধু একটি parameter বদলালেই হয়; Codex আপনার পরিবর্তন পড়ে সেই অনুযায়ী কাজ করবে।
পুরো প্রক্রিয়াটি—একটি ধারণা থেকে স্থিতিশীলভাবে চালানো পর্যন্ত—আমার প্রায় দুইটি বিকেল লেগেছে। প্রথম বিকেল গেছে অনুমতি ও API সংযোগ নিয়ে, দ্বিতীয় বিকেল গেছে Skill লেখা এবং আউটপুট ফরম্যাট ঠিকঠাক করতে। এরপর প্রতি সপ্তাহে এটি সেই দুই বিকেলের সময়ই আমার জন্য বাঁচিয়ে দিচ্ছে।
গত সপ্তাহে বিদেশি বাণিজ্যের সাইট পরিচালনাকারী এক সহকর্মী আমাকে জিজ্ঞেস করলেন: "ডেটা দেখার জন্য তুমি কোন টুল ব্যবহার করো?"
আমি বললাম Codex।
তিনি জিজ্ঞেস করলেন, এটা কি খুব ব্যয়বহুল?
আমি বললাম, গত সপ্তাহে Excel-এ যে সময় ব্যয় করেছ, তার চেয়ে বেশি ব্যয়বহুল নয়।
তিনি কয়েক সেকেন্ড চুপ থাকলেন। তারপর বললেন—"তাহলে ওই Skill-এর একটি কপি আমাকে পাঠাও।"