

AnyJev কী করে
AnyJev একটি ওপেন ভাষা মডেলকে Jev-ধাঁচের সিদ্ধান্ত মডেলে রূপান্তর করে। মডেলকে উত্তর তৈরি করতে এবং পরে তার লেখা পার্স করতে বলার পরিবর্তে, AnyJev একটি prefill থেকে মডেলের পরবর্তী টোকেনের বণ্টন পড়ে এবং সম্ভাবনাসহ একটি টাইপযুক্ত সিদ্ধান্ত ফেরত দেয়।
এটি অনুরোধ রাউট করা, কোনো কাজ ঝুঁকিপূর্ণ কি না অনুমান করা, অথবা কাজ সম্পন্ন হওয়ার মাত্রা স্কোর করার মতো ওয়ার্কফ্লোতে কার্যকর। প্রতিটি ফলাফলে ব্যবহৃত সিদ্ধান্তের স্তর রেকর্ড করা হয়, ফলে পরবর্তী কোড আনক্যালিব্রেটেড বা শূন্য-লেবেল ফলাফল এবং ফিট করা হেড থেকে তৈরি ফলাফলের মধ্যে পার্থক্য করতে পারে।
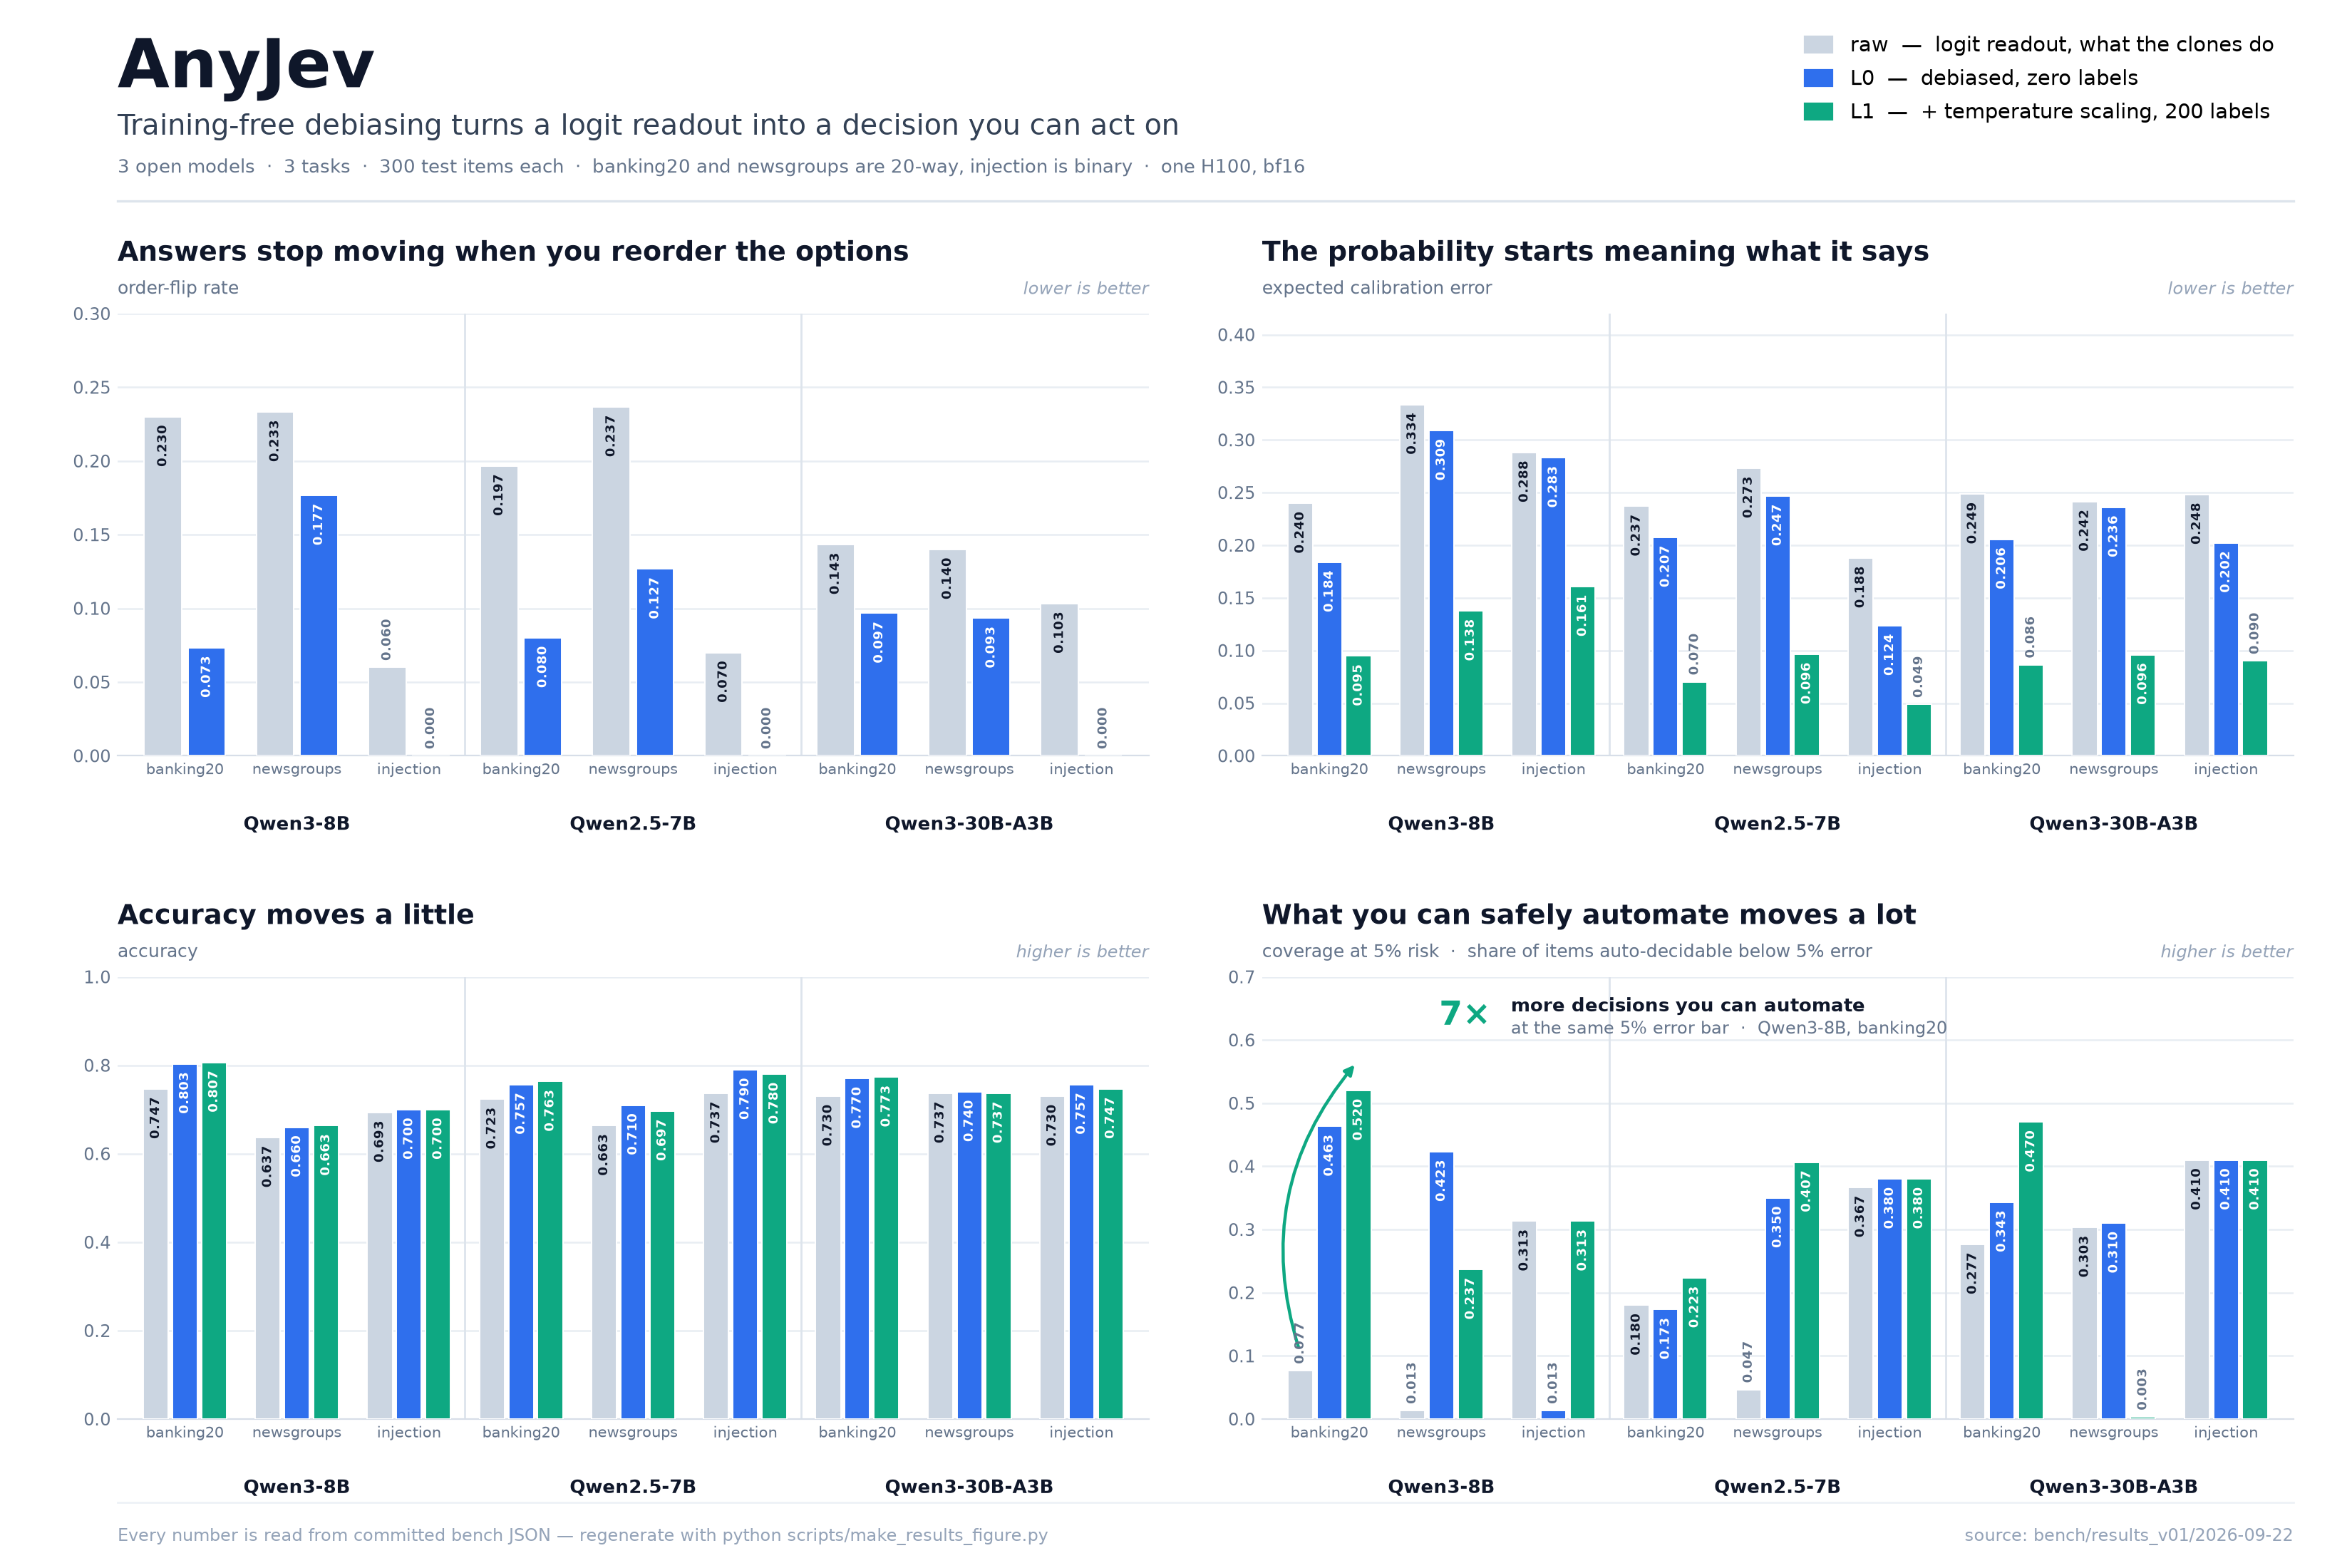
raw logits-এর দুটি ব্যবহারিক সমস্যা AnyJev সমাধান করে: বিকল্পগুলোর ক্রম বদলালে পূর্বাভাস বদলে যেতে পারে, এবং কাঁচা confidence মান থ্রেশহোল্ড-ভিত্তিক অটোমেশনের জন্য যথেষ্ট ভালোভাবে ক্যালিব্রেটেড নাও হতে পারে। README-এর Qwen3-8B BANKING77 পরীক্ষায়, L0 কোনো লেবেল ছাড়াই option-order flip rate 0.230 থেকে 0.073-এ কমিয়েছে। L1 লেবেলযুক্ত উদাহরণসহ expected calibration error 0.240 থেকে 0.095-এ কমিয়েছে।
সিদ্ধান্তের স্তর
AnyJev বিভিন্ন ডেটা ও সার্ভিং প্রয়োজনীয়তাসহ একাধিক স্তর প্রদান করে:
- raw: লেবেল টোকেনগুলোর ওপর সীমিত softmax প্রয়োগ করে। এটি position bias সংশোধন বা confidence ক্যালিব্রেট করে না।
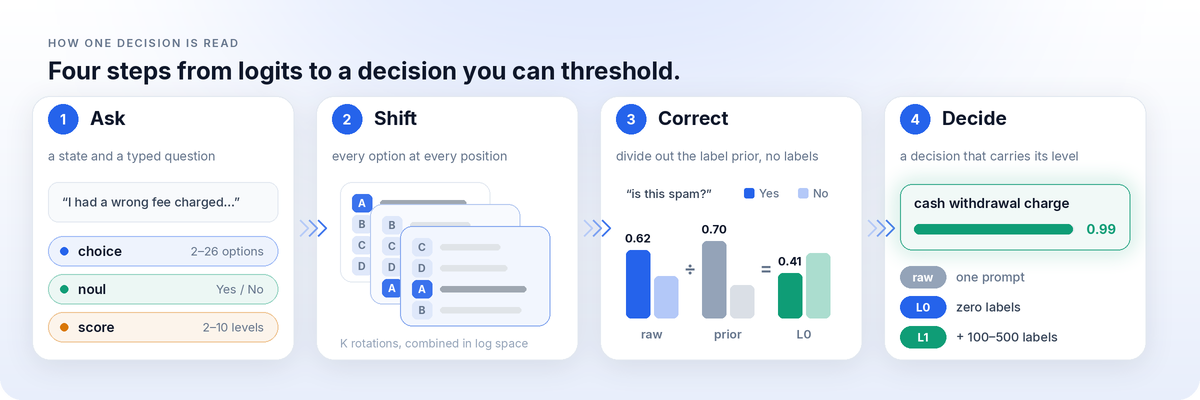
- L0: কোনো লেবেল প্রয়োজন হয় না। এটি cyclic option rotation মূল্যায়ন করে, position bias-এর গড় প্রভাব বাদ দেয় এবং আনুমানিক label prior দিয়ে ভাগ করে।
- L1: L0-এর ওপর temperature scaling ফিট করতে প্রতি প্রশ্নে আনুমানিক 100–500টি লেবেল ব্যবহার করে। এটি ক্যালিব্রেশন উন্নত করে, তবে ranking পরিবর্তন করে না।
- L2: মধ্যবর্তী hidden state থেকে shrunk LDA বা ridge head সমাধান করতে প্রতি প্রশ্নে আনুমানিক 100–300টি লেবেল ব্যবহার করে। এর জন্য একটি স্থানীয় মডেল প্রয়োজন এবং এটি মডেল ও প্রশ্ন উভয়ের জন্যই নির্দিষ্ট।
বহু-বিকল্পের পছন্দে L0-এর একাধিক prefill প্রয়োজন, কারণ এটি rotation মূল্যায়ন করে। অন্যদিকে L2 একটি prompt ব্যবহার করে এবং নির্দিষ্ট একটি intermediate block-এ থামে, ফলে প্রকাশিত Qwen3 পরীক্ষায় এটি সম্পূর্ণ forward pass-এর চেয়ে কম ব্যয়বহুল।
প্রধান বৈশিষ্ট্য
- টাইপযুক্ত
choice,noul, এবংscoreপ্রশ্ন। - কোনো text generation বা answer parsing নেই।
- option-position এবং label-prior প্রভাবের জন্য zero-label L0 সংশোধন।
- কয়েকশ লেবেলসহ L1 temperature calibration।
- gradient বা model fine-tuning ছাড়াই কয়েক সেকেন্ডে ফিট করা L2 closed-form head।
level="auto"-এর মাধ্যমে L2, L1, বা L0 স্বয়ংক্রিয় নির্বাচন।observe-এর মাধ্যমে ক্রমবর্ধমানভাবে লেবেল সংগ্রহ।- একটি প্রশ্ন ও বহু state-এর জন্য batch decision।
- ছোট JSON artifact, যা পরবর্তী serving-এর জন্য সংরক্ষণ ও লোড করা যায়।
ইনস্টলেশন ও সেটআপ
Hugging Face backend ইনস্টল করুন
Hugging Face integration-সহ AnyJev ইনস্টল করুন:
pip install "anyjev[hf]"বর্তমান release Transformers-ভিত্তিক anyjev.backends.hf backend-এর মাধ্যমে সব সিদ্ধান্ত স্তর পরিবেশন করে। vLLM এবং SGLang সমর্থন roadmap-এ রয়েছে এবং এই release-এ উপলভ্য নয়।
একটি decider তৈরি করুন
মূল API ইমপোর্ট করে একটি open model দিয়ে HFBackend ইনিশিয়ালাইজ করুন:
from anyjev import Decider, Question
from anyjev.backends.hf import HFBackend

decider = Decider(HFBackend("Qwen/Qwen3-8B"))
প্রদত্ত L2 head পাঁচটি Qwen3 model সমর্থন করে: 1.7B, 4B, 8B, 30B-A3B, এবং 32B। L2 head তার base model এবং question-এর জন্য নির্দিষ্ট থাকে, তাই একটি model বা question-এর জন্য ফিট করা head অন্যটির জন্য স্বয়ংক্রিয়ভাবে পুনর্ব্যবহার করা যায় না।
টাইপযুক্ত প্রশ্ন সংজ্ঞায়িত করুন
একটি প্রশ্ন output type, বৈধ response এবং একটি স্থিতিশীল নাম বর্ণনা করে। একই application state-এর বিরুদ্ধে আপনি একাধিক ধরনের প্রশ্ন মূল্যায়ন করতে পারেন।
route = Question.choice(
    "Which team should handle this?",
    ["billing", "technical", "sales", "other"],
    name="route",
)

risky = Question.noul(
    "Is this tool call destructive or irreversible?",
    name="risky",
)

done = Question.score(
    "How complete is the task?",
    bins=5,
    name="done",
)
শ্রেণিভিত্তিক সিদ্ধান্তের জন্য choice, true-or-false সিদ্ধান্তের জন্য noul, এবং ভাগ করা numerical score-এর জন্য score ব্যবহার করুন। letter-token readout বর্তমানে সর্বাধিক 26টি option সমর্থন করে।
একটি মৌলিক L0 সিদ্ধান্ত নিন
L0 ডিফল্ট এবং এর জন্য কোনো labeled example প্রয়োজন হয় না। প্রশ্নগুলোর জন্য প্রয়োজনীয় তথ্যসহ একটি state তৈরি করুন, তারপর decide কল করুন:
state = {
    "conversation": [
        {"role": "user", "content": "I was charged twice."}
    ],
    "tool_call": {
        "name": "refund_payment",
        "arguments": {"payment_id": "pay_123"},
    },
}

result = decider.decide(state, [route, risky, done])

print(result["route"].distribution)
print(result["risky"].p_true)
print(result["done"].value)
print(result.level)
একটি representative route distribution প্রতিটি সরবরাহ করা option-কে একটি probability-এর সঙ্গে ম্যাপ করতে পারে। Boolean decision-এ p_true, আর score decision-এ value প্রকাশ করা হয়। উচ্চতর স্তরের কোনো artifact না থাকলে সামগ্রিক ফলাফলে L0 রিপোর্ট করা হয়।
Probability তাদের স্তর অনুযায়ী ব্যাখ্যা করা উচিত। L0 স্থিতিশীলতা বাড়ায় এবং আনুমানিক label bias সংশোধন করে, তবে uncertainty-কে সম্পূর্ণভাবে ক্যালিব্রেটেড করে না।
L1 ক্যালিব্রেশন যোগ করুন
কোনো প্রশ্নের জন্য আপনার কাছে আনুমানিক 100–500টি labeled state থাকলে, L1 temperature ফিট করতে calibrate কল করুন:
decider.calibrate(risky, states, labels)L1 L0-এর ওপর উৎপন্ন probability ক্যালিব্রেট করে। কোন উত্তর প্রথমে rank করবে তা পরিবর্তন করে না, তবে confidence threshold-কে আরও অর্থবহ করে তুলতে পারে।
L2 Closed-Form Head ফিট করুন
আরও নির্ভুলতার জন্য, প্রায় ১০০–৩০০টি লেবেলযুক্ত উদাহরণ ব্যবহার করে প্রশ্ন-নির্দিষ্ট L2 হেড ফিট করুন:
decider.fit_head(route, states, labels)

decider.save_artifacts("qwen3-8b.json")
ফিটিং উদাহরণগুলোর ওপর একবার মডেল চালায় এবং এরপর ক্লোজড ফর্মে হেড সমাধান করে। এটি গ্রেডিয়েন্ট ব্যবহার করে না এবং ভাষা মডেলের ওজন পরিবর্তন করে না। প্রকল্প অনুযায়ী, একটি হেড সাধারণত প্রায় ১০০ KB হয় এবং সমর্থিত ছোট Qwen3 মডেলগুলোর জন্য কয়েক সেকেন্ডে সমাধান করা যায়।
পরবর্তী কোনো প্রসেসে সংরক্ষিত আর্টিফ্যাক্ট লোড করুন, তারপর স্বয়ংক্রিয় লেভেল নির্বাচন অনুরোধ করুন:
decider.load_artifacts("qwen3-8b.json")

result = decider.decide(state, [route], level="auto")
print(result["route"].level)
level="auto" ব্যবহার করলে, প্রশ্নটি রাউট করতে সক্ষম সামঞ্জস্যপূর্ণ হেড থাকলে AnyJev L2 ব্যবহার করে। অন্যথায়, ক্যালিব্রেশন উপলভ্য থাকলে L1-এ, তারপর L0-এ ফিরে যায়।
ক্রমশ লেবেল সংগ্রহ করুন
রিভিউ কিউ, পর্যবেক্ষিত ফলাফল বা অন্য কোনো ফিডব্যাক উৎস থেকে লেবেল আসার সঙ্গে সঙ্গে AnyJev সেগুলো গ্রহণ করতে পারে:
decider.observe(route, state, correct_label)প্রকল্পটির স্বয়ংক্রিয় লুপ ৩০টি পর্যবেক্ষণের পর একটি হেড সমাধান করে, তারপর ৬০, ১২০ এবং পরবর্তী মাইলস্টোনে সেটি পুনরায় সমাধান করে। এর ফলে এমন একটি ডিপ্লয়মেন্ট লাইফসাইকেল সম্ভব হয়, যেখানে নতুন প্রশ্ন L0 থেকে শুরু করে পর্যাপ্ত ফিডব্যাক জমার পর L2-এ অগ্রসর হয়।
ব্যাচ ইনফারেন্স
একটি প্রশ্ন বহু স্টেটে প্রয়োগ করার সময় বারবার decide কল না করে ব্যাচ API ব্যবহার করুন:
results = decider.decide_batch(states, route)একটি টাইপড প্রশ্নের বিপরীতে বহু ইনপুট প্রক্রিয়াকরণের জন্য এটিই নির্ধারিত ইন্টারফেস।
প্যাকেজ করা ডেমো চেষ্টা করুন
রিপোজিটরির একটি চেকআউট থেকে মডেল ডাউনলোড না করেই সিন্থেটিক ডেমো চালান:
python -m demo.jev_mode --backend fakeডিপ্লয়মেন্ট লাইফসাইকেল অনুকরণ করতে লাইফসাইকেল অপশন যোগ করুন:
python -m demo.jev_mode --backend fake --lifecycleশিপ করা হেডসহ বাস্তব Qwen3 ডেমো চালাতে --backend fake সরিয়ে দিন।
উন্নত ডিপ্লয়মেন্ট টিপস
প্রশ্নের পরিচয় স্থিতিশীল রাখুন
L2 প্রতি প্রশ্ন ও মডেলের জন্য আলাদাভাবে ফিট করা হয়। নতুন অপশন সেটের জন্য নতুন লেবেল ও নতুন হেড প্রয়োজন। একই প্রশ্নের ভাষা নতুনভাবে লেখা বা একই অপশনগুলোর ক্রম পরিবর্তন করলে বিদ্যমান হেডে রাউট করা যেতে পারে।
ভাষার অভিযোজনের জন্য আনলেবেলযুক্ত ট্রাফিক ব্যবহার করুন
নতুনভাবে লেখা প্রশ্নের ক্ষেত্রে, প্রায় ৩০টি আনলেবেলযুক্ত অনুরোধ ব্যবহার করে AnyJev হেডের ফিচার গড় ও স্কেল পুনরায় কেন্দ্রায়িত করতে পারে। এই অভিযোজন প্রশ্নের ভাষা ও অপশনের ক্রমে প্রযোজ্য; এটি অ্যাপ্লিকেশনের স্টেটগুলোর নিজস্ব পরিবর্তন শনাক্ত করে না।
বাস্তব ডেটার ড্রিফট পর্যবেক্ষণ করুন
স্টেটের বণ্টনে পরিবর্তন পুনরায় কেন্দ্রায়ন প্রক্রিয়ার কাছে অদৃশ্য থাকায়, নিয়মিত লেবেলযুক্ত একটি মূল্যায়ন স্লাইস সংরক্ষণ করুন এবং নমুনাভিত্তিক পারফরম্যান্স যাচাই করুন। উৎপাদন পর্যবেক্ষণের বিকল্প হিসেবে ভাষার অভিযোজনকে বিবেচনা করবেন না।
সিদ্ধান্তের লেভেল অনুযায়ী অ্যাকশন নিয়ন্ত্রণ করুন
প্রতিটি সিদ্ধান্তের সঙ্গে তার লেভেল থাকে। সংবেদনশীল অ্যাকশন চালানোর আগে ডাউনস্ট্রিম সিস্টেমগুলো এটি পরীক্ষা করতে পারে, এবং প্রকল্পটি require= ব্যবহার করে লেভেল প্রয়োগ করাও সমর্থন করে। এর ফলে ক্যালিব্রেটেড বা L2 সিদ্ধান্তের জন্য তৈরি কোনো ওয়ার্কফ্লো নিঃশব্দে কোনো ফলব্যাক ফলাফলের ওপর কাজ করা থেকে সুরক্ষিত থাকে।
যাচাইয়ের পরেই থ্রেশহোল্ড নির্বাচন করুন
ক্যালিব্রেশনের প্রধান সুবিধা হলো উচ্চ-আস্থার কেসগুলো অটোমেশনে পাঠানো এবং অনিশ্চিত কেসগুলো এসকেলেট করা। প্রতিনিধিত্বশীল লেবেলযুক্ত ডেটায় থ্রেশহোল্ড নির্বাচন করুন এবং প্রদর্শিত সম্ভাব্যতাকে স্বয়ংক্রিয়ভাবে নির্ভরযোগ্য ধরে না নিয়ে ফলস্বরূপ ত্রুটি ও কভারেজ পরিমাপ করুন।
গুরুত্বপূর্ণ সীমাবদ্ধতা
- L2 হেড ভিন্ন প্রশ্ন বা বেস মডেলে স্থানান্তর করা যায় না।
- বর্তমান প্রকল্প রিলিজে শুধু Qwen3 হেড সরবরাহ করা হয়।
- L2-এর জন্য হিডেন স্টেটে অ্যাক্সেস প্রয়োজন, যা বর্তমানে Transformers ব্যাকএন্ডের মাধ্যমে দেওয়া হয়।
- ক্যালিব্রেশন এমন কোনো কাজ সমাধান করাতে পারে না, যার উত্তর মডেল মৌলিকভাবেই দিতে পারে না।
- একটি লেবেল ব্যাচের প্রায়োরে শক্তভাবে প্রাধান্য পেলে L0 নির্ভুলতা কমাতে পারে।
- বর্তমান লেটার রিডআউট সর্বোচ্চ ২৬টি অপশন সমর্থন করে।
- প্রতিবেদিত ৫% ঝুঁকি কভারেজের হিসাব ৩০০টি উদাহরণের ওপর ভিত্তি করে, তাই এতে ভ্যারিয়েন্স বেশি।
- প্রকাশিত টাইপড-ডিসিশন নির্ভুলতা স্বাধীনভাবে প্রতিষ্ঠিত গ্রাউন্ড ট্রুথের পরিবর্তে একটি শিক্ষক LLM-এর সঙ্গে সামঞ্জস্য পরিমাপ করে।
- প্রতিবেদিত সিদ্ধান্তগুলো সম্পূর্ণ এজেন্ট লুপের ভিতরে নয়, বিচ্ছিন্নভাবে মূল্যায়ন করা হয়েছে।
উপসংহার
AnyJev শূন্য-লেবেলযুক্ত টাইপড সিদ্ধান্ত থেকে ক্যালিব্রেটেড সম্ভাব্যতা এবং দক্ষ হিডেন-স্টেট হেড পর্যন্ত একটি ব্যবহারিক অগ্রগতি প্রদান করে। L0 দিয়ে শুরু করুন, বাস্তব লেবেল সংগ্রহ করুন, ক্যালিব্রেশন অগ্রাধিকার হলে L1 যোগ করুন, এবং আরও নির্ভুল প্রশ্ন-নির্দিষ্ট সিদ্ধান্তপথের প্রয়োজন হলে L2 ফিট করুন। রিপোর্ট করা লেভেল সংরক্ষণ করুন, থ্রেশহোল্ড যাচাই করুন এবং উৎপাদন ডেটা পরিবর্তিত হওয়ার সঙ্গে সঙ্গে লেবেলযুক্ত নমুনা পর্যবেক্ষণ করুন।
বাস্তবায়নের বিবরণ ও বর্তমান পরিকল্পনার জন্য AnyJev রিপোজিটরি, এর লেভেলস কনট্র্যাক্ট, বেঞ্চমার্ক ডকুমেন্টেশন এবং রোডম্যাপ দেখুন।