

WeMM-Embedding কী?
WeMM-Embedding হলো WeChat Vision দলের তৈরি সার্বজনীন মাল্টিমোডাল এমবেডিং মডেলের একটি পরিবার। এটি টেক্সট, ছবি, ভিডিও, ভিজ্যুয়াল ডকুমেন্ট এবং আন্তঃসংযুক্ত মাল্টিমোডাল ইনপুটকে একীভূত ভেক্টর উপস্থাপনায় রূপান্তর করে। এই ভেক্টরগুলো বিভিন্ন মোডালিটির কনটেন্ট উপস্থাপন ও তুলনা করার প্রয়োজন হয় এমন কর্মপ্রবাহে সহায়তা করতে পারে।
প্রতিটি মডেল নির্দিষ্ট <embedding> টোকেন অবস্থানে শেষ স্তরের হিডেন স্টেট থেকে এমবেডিং সংগ্রহ করে এবং এরপর L2 নর্মালাইজেশন প্রয়োগ করে। অডিও ইনপুট বর্তমানে সমর্থিত নয়।
মূল বৈশিষ্ট্য
- একীভূত মাল্টিমোডাল উপস্থাপনা: একই মডেল পরিবার টেক্সট, ছবি, ভিডিও, ভিজ্যুয়াল ডকুমেন্ট এবং আন্তঃসংযুক্ত ইনপুট পরিচালনা করে।
- একাধিক মডেল আকার: 2B, 4B এবং 9B প্যারামিটার ভ্যারিয়েন্টের মধ্যে বেছে নিন।
- Matryoshka Representation Learning: স্টোরেজ বা রিট্রিভাল দক্ষতা গুরুত্বপূর্ণ হলে সমর্থিত ছোট ভেক্টর ডাইমেনশন ব্যবহার করুন।
- দুটি ইনফারেন্স ইন্টারফেস: Transformers এবং Sentence Transformers উভয়ের জন্য উদাহরণ দেওয়া হয়েছে।
- প্রোডাকশন সার্ভিং: রিপোজিটরিতে vLLM এবং SGLang-এর জন্য কনফিগারেশন ও র্যাপার স্ক্রিপ্ট রয়েছে।
- মূল্যায়ন টুলিং: অন্তর্ভুক্ত MMEB-v3 পাইপলাইন সিঙ্গেল-নোড ও মাল্টি-নোড ইনফারেন্স সমর্থন করে।
মডেল ও ডাইমেনশন বেছে নিন
Hugging Face-এ মডেল জুড়ে তিনটি ভ্যারিয়েন্ট রয়েছে। আপনার উপলব্ধ কম্পিউট এবং প্রয়োজনীয় পূর্ণ এমবেডিং আকার অনুযায়ী একটি মডেল নির্বাচন করুন।
- WeMM-Embedding-2B: 64, 128, 256, 512, 1024 এবং 2048 ডাইমেনশন সমর্থন করে।
- WeMM-Embedding-4B: 64, 128, 256, 512, 1024 এবং 2560 ডাইমেনশন সমর্থন করে।
- WeMM-Embedding-9B: 64, 128, 256, 512, 1024, 2048 এবং 4096 ডাইমেনশন সমর্থন করে।
সমর্থিত ছোট ডাইমেনশন ভেক্টর স্টোরেজ ও পরবর্তী কম্পিউটেশন কমায়। উদাহরণস্বরূপ, README-তে জানানো হয়েছে যে 256 ডাইমেনশনের 2B মডেলটি MMEB-v2-এ পূর্ণ ডাইমেনশনের ইমেজ ও ভিডিও কর্মদক্ষতার 98.7% বজায় রাখে।
ইনস্টলেশন ও সেটআপ
1. রিপোজিটরি ও মডেল সংগ্রহ করুন
রিপোজিটরির একটি স্থানীয় কপি নিয়ে কাজ করুন, এরপর এর Hugging Face পৃষ্ঠা থেকে একটি মডেল ডাউনলোড করুন অথবা সমর্থিত হলে Hugging Face মডেল আইডেন্টিফায়ার ব্যবহার করার জন্য সংশ্লিষ্ট উদাহরণ কনফিগার করুন।
2. নির্ভরতা ইনস্টল করুন
প্রকল্পে ঘোষিত সংস্করণগুলো ইনস্টল করুন:
pip install -r requirements.txt3. পুনরুৎপাদনযোগ্যতার জন্য Transformers সংস্করণ নির্দিষ্ট করুন
ইনফারেন্স ও পুনরুৎপাদনযোগ্যতার জন্য প্রকল্পটি transformers==5.2.0 ব্যবহারের পরামর্শ দেয়, কারণ নতুন সংস্করণগুলোর প্রিপ্রসেসিং আচরণ ভিন্ন হতে পারে।
pip install transformers==5.2.0উদাহরণ চালানোর আগে আপনার মডেল, পরীক্ষার ছবি এবং পরীক্ষার ভিডিওর পাথ প্রস্তুত করুন।
Transformers দিয়ে প্রাথমিক ব্যবহার
Transformers উদাহরণটি টেক্সট, ছবি ও ভিডিও ইনপুটের জন্য স্বতন্ত্র এমবেডিং তৈরি করে। স্থানীয় মডেল পাথ এবং সমর্থিত আউটপুট ডাইমেনশন দিয়ে এটি চালান:
python examples/transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
  --dimension 2048
প্লেসহোল্ডার পাথগুলো আপনার সিস্টেমের ফাইল দিয়ে প্রতিস্থাপন করুন। 2B মডেলের জন্য 2048 হলো পূর্ণ ভেক্টর আকার। স্পষ্টভাবে উল্লেখ না করে মডেলের পূর্ণ এমবেডিং ডাইমেনশন চাইতে --dimension বাদ দিন:
python examples/transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4
Sentence Transformers দিয়ে প্রাথমিক ব্যবহার
Sentence Transformers উদাহরণটি SentenceTransformer.encode()-এর মাধ্যমে টেক্সট, ছবি ও ভিডিও ইনপুট পাঠায়। এটি --dimension-এর মাধ্যমে Matryoshka ডাইমেনশন নির্বাচনও সমর্থন করে।
python examples/sentence_transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
  --dimension 2048
SentenceTransformer সরাসরি মডেল লোড করতে পারে, তাই আপনি স্থানীয় পাথের পরিবর্তে Hugging Face মডেল আইডেন্টিফায়ার ব্যবহার করতে পারেন:
python examples/sentence_transformers_inference.py \
  --model tencent/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
  --dimension 2048
Matryoshka এমবেডিং সঠিকভাবে ব্যবহার করুন
Matryoshka এমবেডিং আপনাকে একটি পূর্ণ ভেক্টরকে নির্বাচিত মডেল সমর্থিত ডাইমেনশনগুলোর একটিতে ছোট করতে দেয়। চূড়ান্ত অক্ষটি ছাঁটাই করুন এবং এরপর ছোট করা ভেক্টরটি আবার নর্মালাইজ করুন:
embedding = torch.nn.functional.normalize(
    embedding[..., :d],
    dim=-1
)
আপনার মডেলের তালিকাভুক্ত কোনো ডাইমেনশনেই কেবল d সেট করুন। ছাঁটাই ভেক্টরের নর্ম পরিবর্তন করে বলে দ্বিতীয় নর্মালাইজেশন ধাপটি গুরুত্বপূর্ণ। সরবরাহ করা কমান্ড-লাইন উদাহরণ ব্যবহার করার সময় --dimension দিয়ে পছন্দের Matryoshka ডাইমেনশন নির্বাচন করুন।
vLLM দিয়ে মডেল সার্ভ করুন
রিপোজিটরিতে vLLM 0.27.0 দিয়ে পরীক্ষার কথা জানানো হয়েছে। একটি পুলিং সার্ভার চালু করুন এবং মডেলের এমবেডিং চ্যাট টেমপ্লেট দিন:
MODEL_PATH=/path/to/WeMM-Embedding-2B
vllm serve "$MODEL_PATH" \
  --runner pooling \
  --chat-template "$MODEL_PATH/embedding_chat_template.jinja"
একটি সমতুল্য র্যাপার scripts/serve_vllm.sh-এ রয়েছে।
SGLang দিয়ে মডেল সার্ভ করুন
প্রকল্পের নথিভুক্ত পরীক্ষিত সংস্করণ হলো SGLang 0.5.9। এমবেডিং সার্ভার চালু করার আগে সরবরাহ করা ভিডিও প্যাচ প্রয়োগ করুন:
MODEL_PATH=/path/to/WeMM-Embedding-2B
python scripts/patch_sglang_video.py
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --is-embedding \
  --enable-precise-embedding-interpolation
রিপোজিটরিতে এক-কমান্ডের র্যাপার হিসেবে scripts/serve_sglang.sh-ও রয়েছে।
MMEB-v3 মূল্যায়ন চালান
mmeb_v3_eval/ ডিরেক্টরিতে প্রতিবেদিত MMEB-v3 ফলাফলের জন্য ব্যবহৃত মূল্যায়ন কোড রয়েছে। এটি অফিসিয়াল VLM2Vec পাইপলাইনের ওপর ভিত্তি করে তৈরি এবং এতে WeMM-Embedding ব্যাকবোন, সামঞ্জস্যপূর্ণ ডেটাসেট নির্দেশনা, ব্যাচভিত্তিক ইনফারেন্স, মাল্টি-নোড মাল্টি-GPU এক্সিকিউশন এবং 64-ফ্রেম ভিডিও স্যাম্পলিং যুক্ত হয়েছে।
প্রথমে মূল্যায়ন ডিরেক্টরিতে প্রবেশ করে ডেটা ডাউনলোড করুন:
cd mmeb_v3_eval
DATA_ROOT=/path/to/MMEB-V3 bash scripts/download_data.sh
এরপর আপনার মডেল, ডেটাসেট এবং আউটপুট পাথ দিয়ে মূল্যায়ন চালান:
MODEL_PATH=/path/to/WeMM-Embedding-2B \
DATA_BASEDIR=/path/to/MMEB-V3 \
OUTPUT_DIR=exps/wemm_embedding \
bash scripts/run_eval.sh
নথিভুক্ত ডেটা সেটআপ এবং সিঙ্গেল-নোড বা মাল্টি-নোড কমান্ডের জন্য mmeb_v3_eval/README.md দেখুন।
উন্নত টিপস
- মডেলের সঙ্গে মাত্রা মিলিয়ে নিন: 2B মডেলের জন্য 2560 মাত্রা বা 4B মডেলের জন্য 4096 মাত্রা অনুরোধ করবেন না। নির্বাচিত চেকপয়েন্টের জন্য তালিকাভুক্ত মাত্রাগুলোই ব্যবহার করুন।
- ছাঁটা ভেক্টর পুনরায় নর্মালাইজ করুন: সম্পূর্ণ এমবেডিং নিজে সংক্ষিপ্ত করলে পরে অবশ্যই L2 নর্মালাইজেশন প্রয়োগ করুন।
- প্রিপ্রসেসিং পুনরুৎপাদনযোগ্য রাখুন: ফলাফল পুনরুৎপাদনের সময় প্রস্তাবিত Transformers সংস্করণ ব্যবহার করুন, কারণ রিলিজভেদে প্রিপ্রসেসিং পরিবর্তিত হতে পারে।
- উপযুক্ত লোডিং পদ্ধতি ব্যবহার করুন: নথিভুক্ত Transformers কমান্ডে একটি মডেল পাথ ব্যবহার করা হয়, অন্যদিকে Sentence Transformers উদাহরণে
tencent/WeMM-Embedding-2Bসরাসরি লোড করা যায়। - অসমর্থিত অডিও বিবেচনায় রাখুন: মডেলগুলো বর্তমানে অডিও গ্রহণ করে না, তাই প্রতিবেদিত MMEB-v3 অডিও স্কোর শূন্য।
- সুবিধার জন্য সার্ভিং র্যাপার ব্যবহার করুন:
scripts/-এর শেল স্ক্রিপ্টগুলো নথিভুক্ত vLLM এবং SGLang লঞ্চ কনফিগারেশন একত্রে প্যাকেজ করে।
পারফরম্যান্সের প্রেক্ষাপট
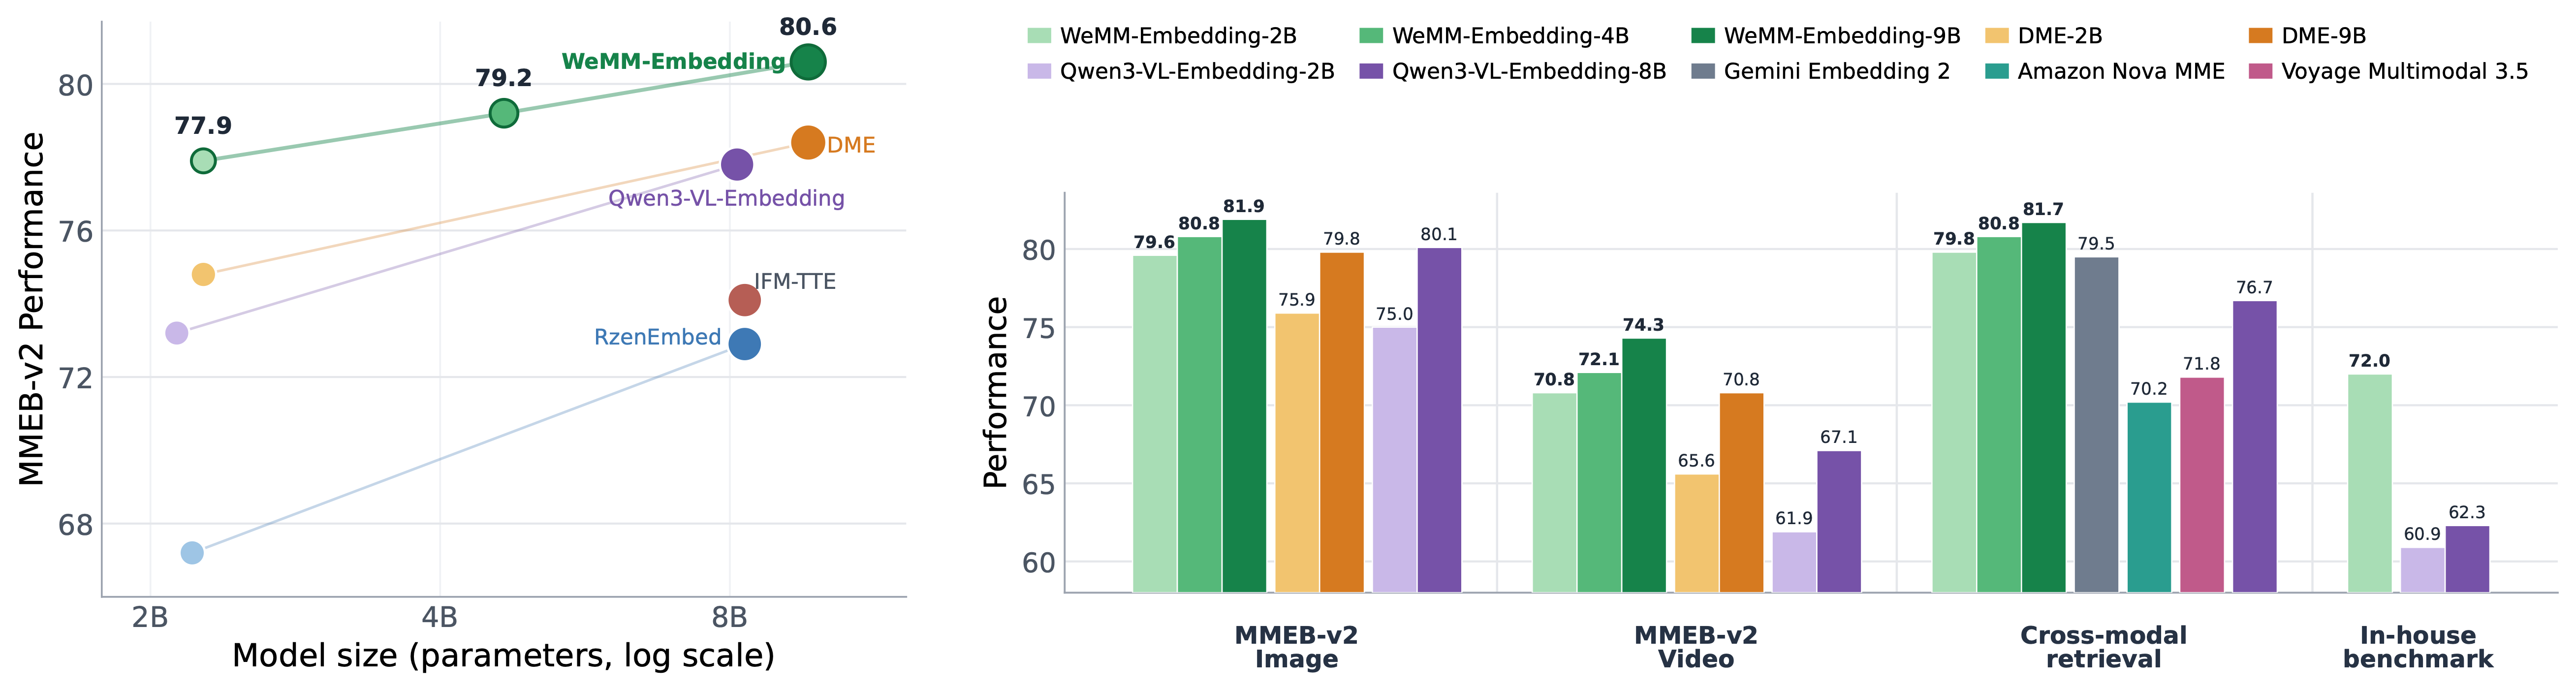
README-তে 78টি MMEB-v2 ডেটাসেট এবং সব 190টি MMEB-v3 টাস্কের ফলাফল প্রতিবেদন করা হয়েছে। MMEB-v2-তে 2B, 4B এবং 9B ভ্যারিয়েন্টের গড় স্কোর যথাক্রমে 77.9, 79.2 এবং 80.6। MMEB-v3-তে তাদের প্রতিবেদিত সামগ্রিক স্কোর 56.0, 58.2 এবং 59.5। টাস্ক গ্রুপ অনুযায়ী মেট্রিক ভিন্ন: ইমেজ ও ভিডিও টাস্কে Hit@1, ভিজ্যুয়াল-ডকুমেন্ট ও টেক্সট টাস্কে NDCG@5, এবং এজেন্ট, MCMR ও অডিও টাস্কে Hit@1 ব্যবহার করা হয়।
নথিভুক্ত টাস্ক কভারেজ বিবেচনায় রেখে বেঞ্চমার্ক স্কোর ব্যাখ্যা করা উচিত। MMEB-v3 অসমর্থিত টাস্কে শূন্য স্কোর নির্ধারণ করে, যার মধ্যে WeMM-Embedding-এর অডিওও রয়েছে।
উপসংহার
WeMM-Embedding বিভিন্ন ভিজ্যুয়াল ও টেক্সট ইনপুট ধরনের জন্য নর্মালাইজড রিপ্রেজেন্টেশন তৈরি করতে একটি একক মডেল পরিবার সরবরাহ করে। 2B চেকপয়েন্ট এবং সরবরাহ করা ইনফারেন্স উদাহরণ দিয়ে শুরু করুন, কমপ্যাক্ট ভেক্টর উপযোগী হলে সমর্থিত Matryoshka মাত্রা নির্বাচন করুন, এবং সার্ভিং বা মূল্যায়নের প্রয়োজন হলে vLLM, SGLang অথবা MMEB-v3 পাইপলাইনে যান। অন্যথায় উল্লেখ না থাকলে Tencent-রচিত রিপোজিটরি কোড Apache License 2.0-এর অধীনে প্রকাশিত।