

DeepInfer-SM80 কী?
DeepInfer-SM80 হলো অপ্টিমাইজ করা Python, Triton এবং TileLang মডিউলের একটি সংগ্রহ, যা vLLM V1 ইঞ্জিনের মাধ্যমে NVIDIA Ampere GPU-তে DeepSeek-V4.1 চালানোর জন্য তৈরি। এটি NVIDIA Blackwell-এর জন্য তৈরি DeepSeek-এর DeepInfer-এর মূল ধারণাগুলো পোর্ট করে এবং Ampere হার্ডওয়্যারের সক্ষমতাকে কেন্দ্র করে গুরুত্বপূর্ণ এক্সিকিউশন পাথটি নতুনভাবে নকশা করে।
tcgen05 warp-group instruction, Tensor Memory, হার্ডওয়্যার UE8M0 scale instruction এবং প্রতি streaming multiprocessor-এ 228 KB shared memory-এর মতো শুধু-Blackwell বৈশিষ্ট্যের ওপর নির্ভর করার পরিবর্তে, এই প্রকল্প Ampere-এর mma.sync.aligned.m16n8k16 Tensor Core, SM-সচেতন scheduling, integer-bitshift UE8M0 decoding এবং YOCO shared-KV reuse ব্যবহার করে।
প্রকল্পটি A100 ও A800-এর মতো data-center SM80 GPU এবং RTX 3090, RTX 3090 Ti, RTX A6000, A40, A10 ও A30-সহ SM86 ডিভাইস সমর্থন করে। এর kernel-গুলো প্রতি CTA-তে সর্বোচ্চ 48 KB shared memory ব্যবহার করে, ফলে SM86 ডিভাইসের কম shared-memory সীমার মধ্যেও এগুলো চালানো যায়।
কেন এটি ব্যবহার করবেন?
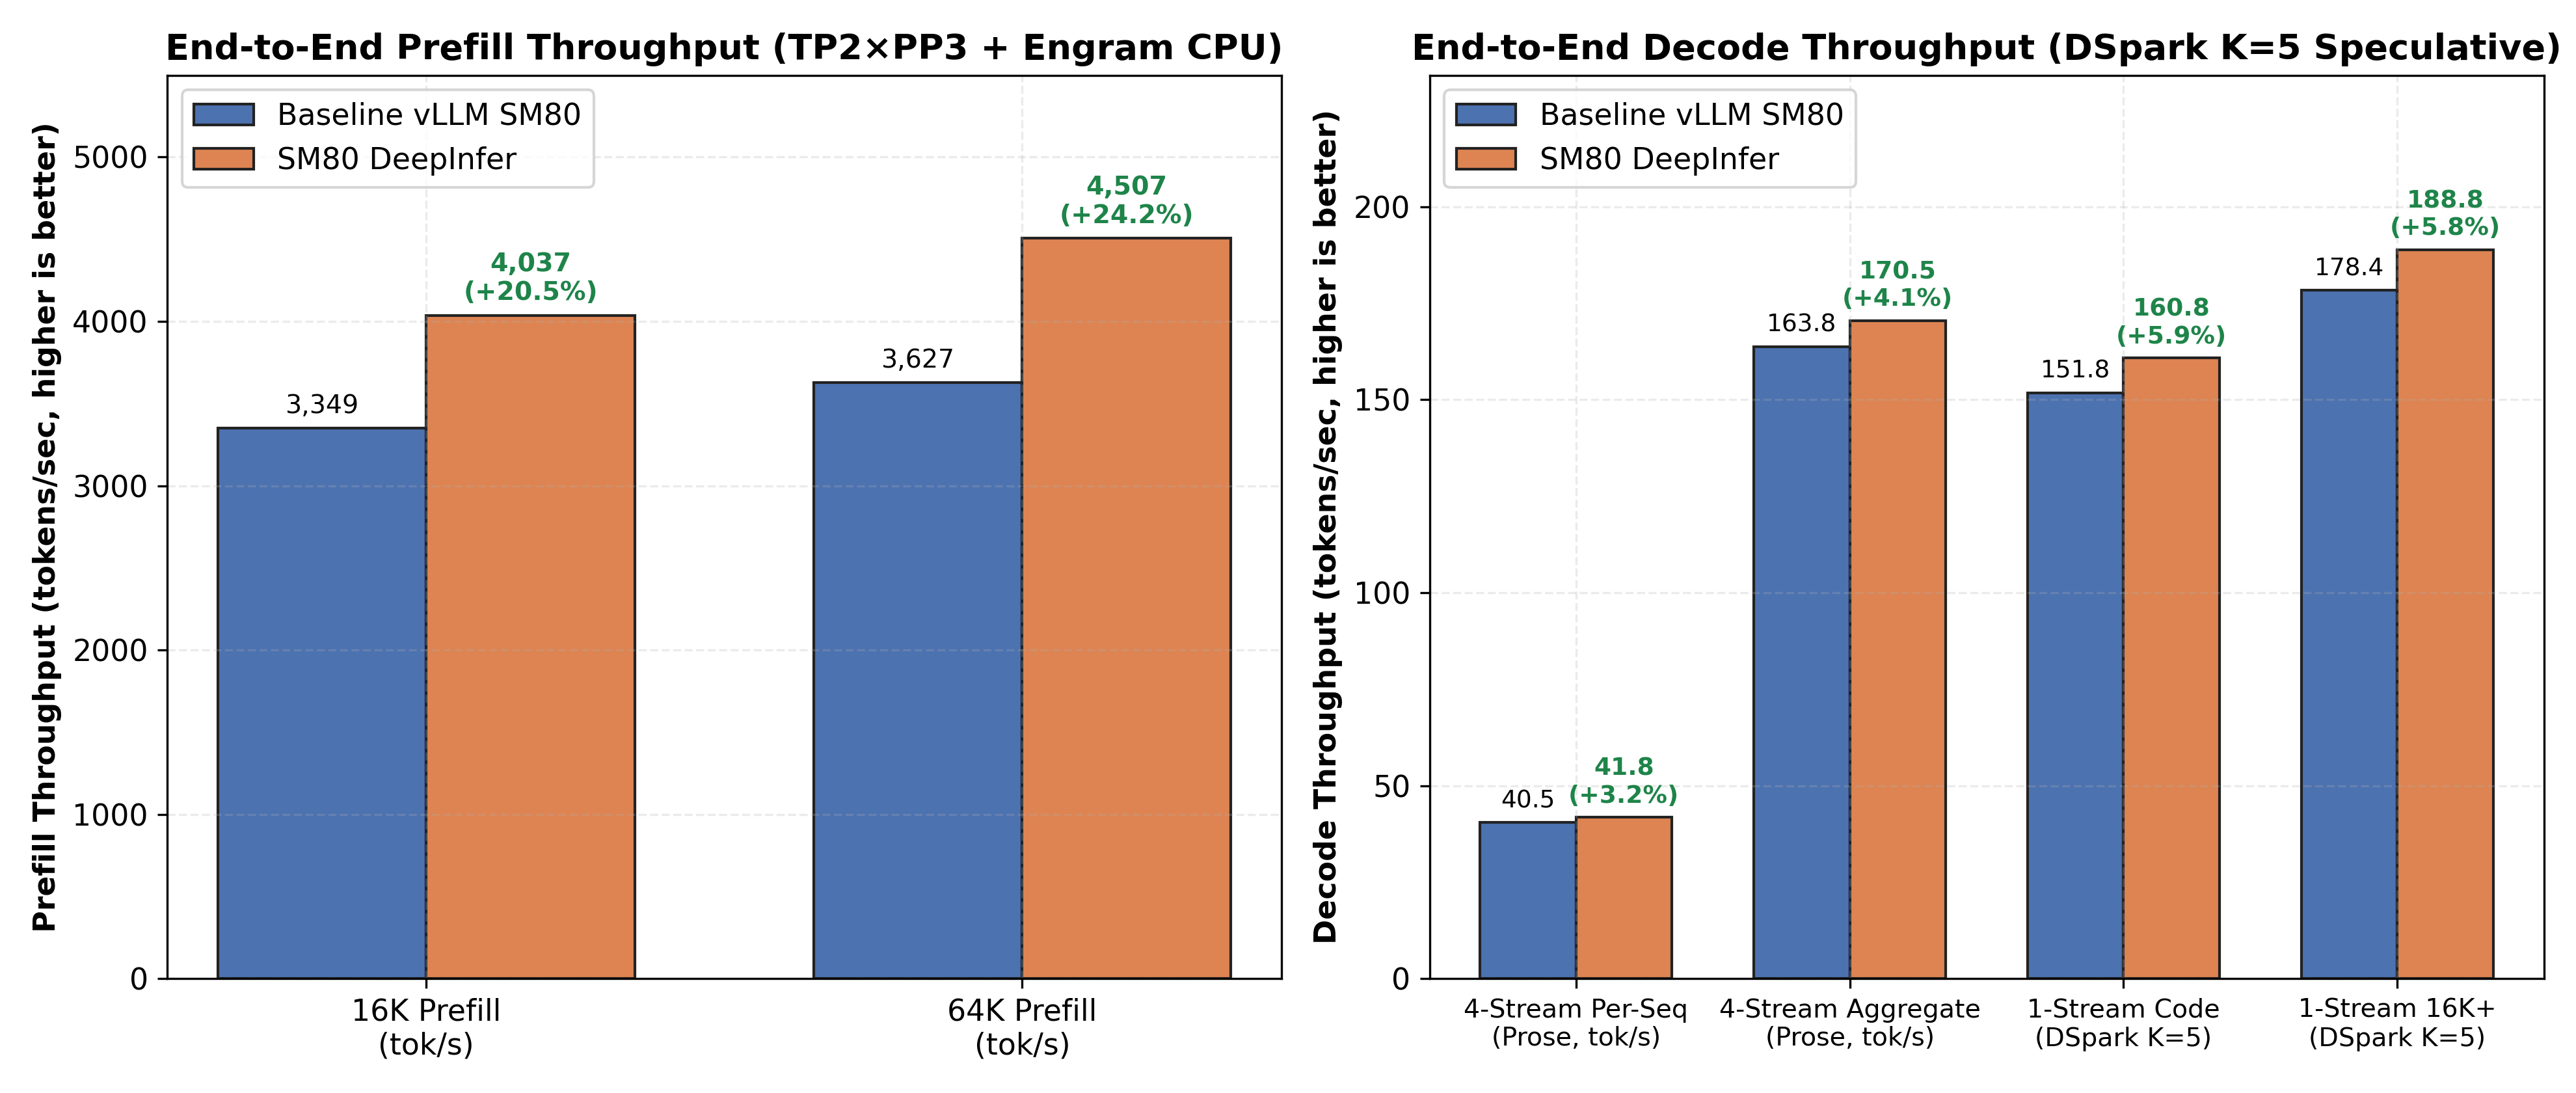
DeepInfer-SM80 DeepSeek-V4.1 prefill, sparse attention, KV-cache access, residual routing এবং long-context inference-এর ব্যয়বহুল কাজগুলোর ওপর গুরুত্ব দেয়। repository-তে ছয়টি GA100 64 GB GPU, TP2 × PP3, K=5-সহ DSpark speculative decoding এবং 1,048,576 token-এর সর্বোচ্চ context length ব্যবহার করা production configuration থেকে নিচের ফলাফল জানানো হয়েছে:
- 16K cold prefill: প্রতি সেকেন্ডে 4,037.0 token, যা আগে ছিল 3,349.4 token।
- 64K cold prefill: প্রতি সেকেন্ডে 4,506.8 token, যা আগে ছিল 3,627.3 token।
- 64K time to first token: 10.7 সেকেন্ড, যা আগে ছিল 13.2 সেকেন্ড।
- Four-stream speculative decode: সমষ্টিগতভাবে প্রতি সেকেন্ডে 170.5 token, যেখানে তুলনামূলক ফল 163.8 token।
- Single-stream Python-code decode: প্রতি সেকেন্ডে 160.8 token, যেখানে তুলনামূলক ফল 151.8 token।
- GPU-resident KV capacity: 4,648,480 token, baseline-এর তুলনায় অতিরিক্ত VRAM overhead ছাড়াই।
এই পরিমাপগুলো repository-তে পরীক্ষিত হার্ডওয়্যার ও serving configuration বর্ণনা করে। অন্যান্য Ampere GPU, model configuration, workload অথবা vLLM environment-এ ফলাফল ভিন্ন হতে পারে।
মূল অপ্টিমাইজেশন
ইউনিফায়েড 512-ডাইমেনশনের Sparse MLA
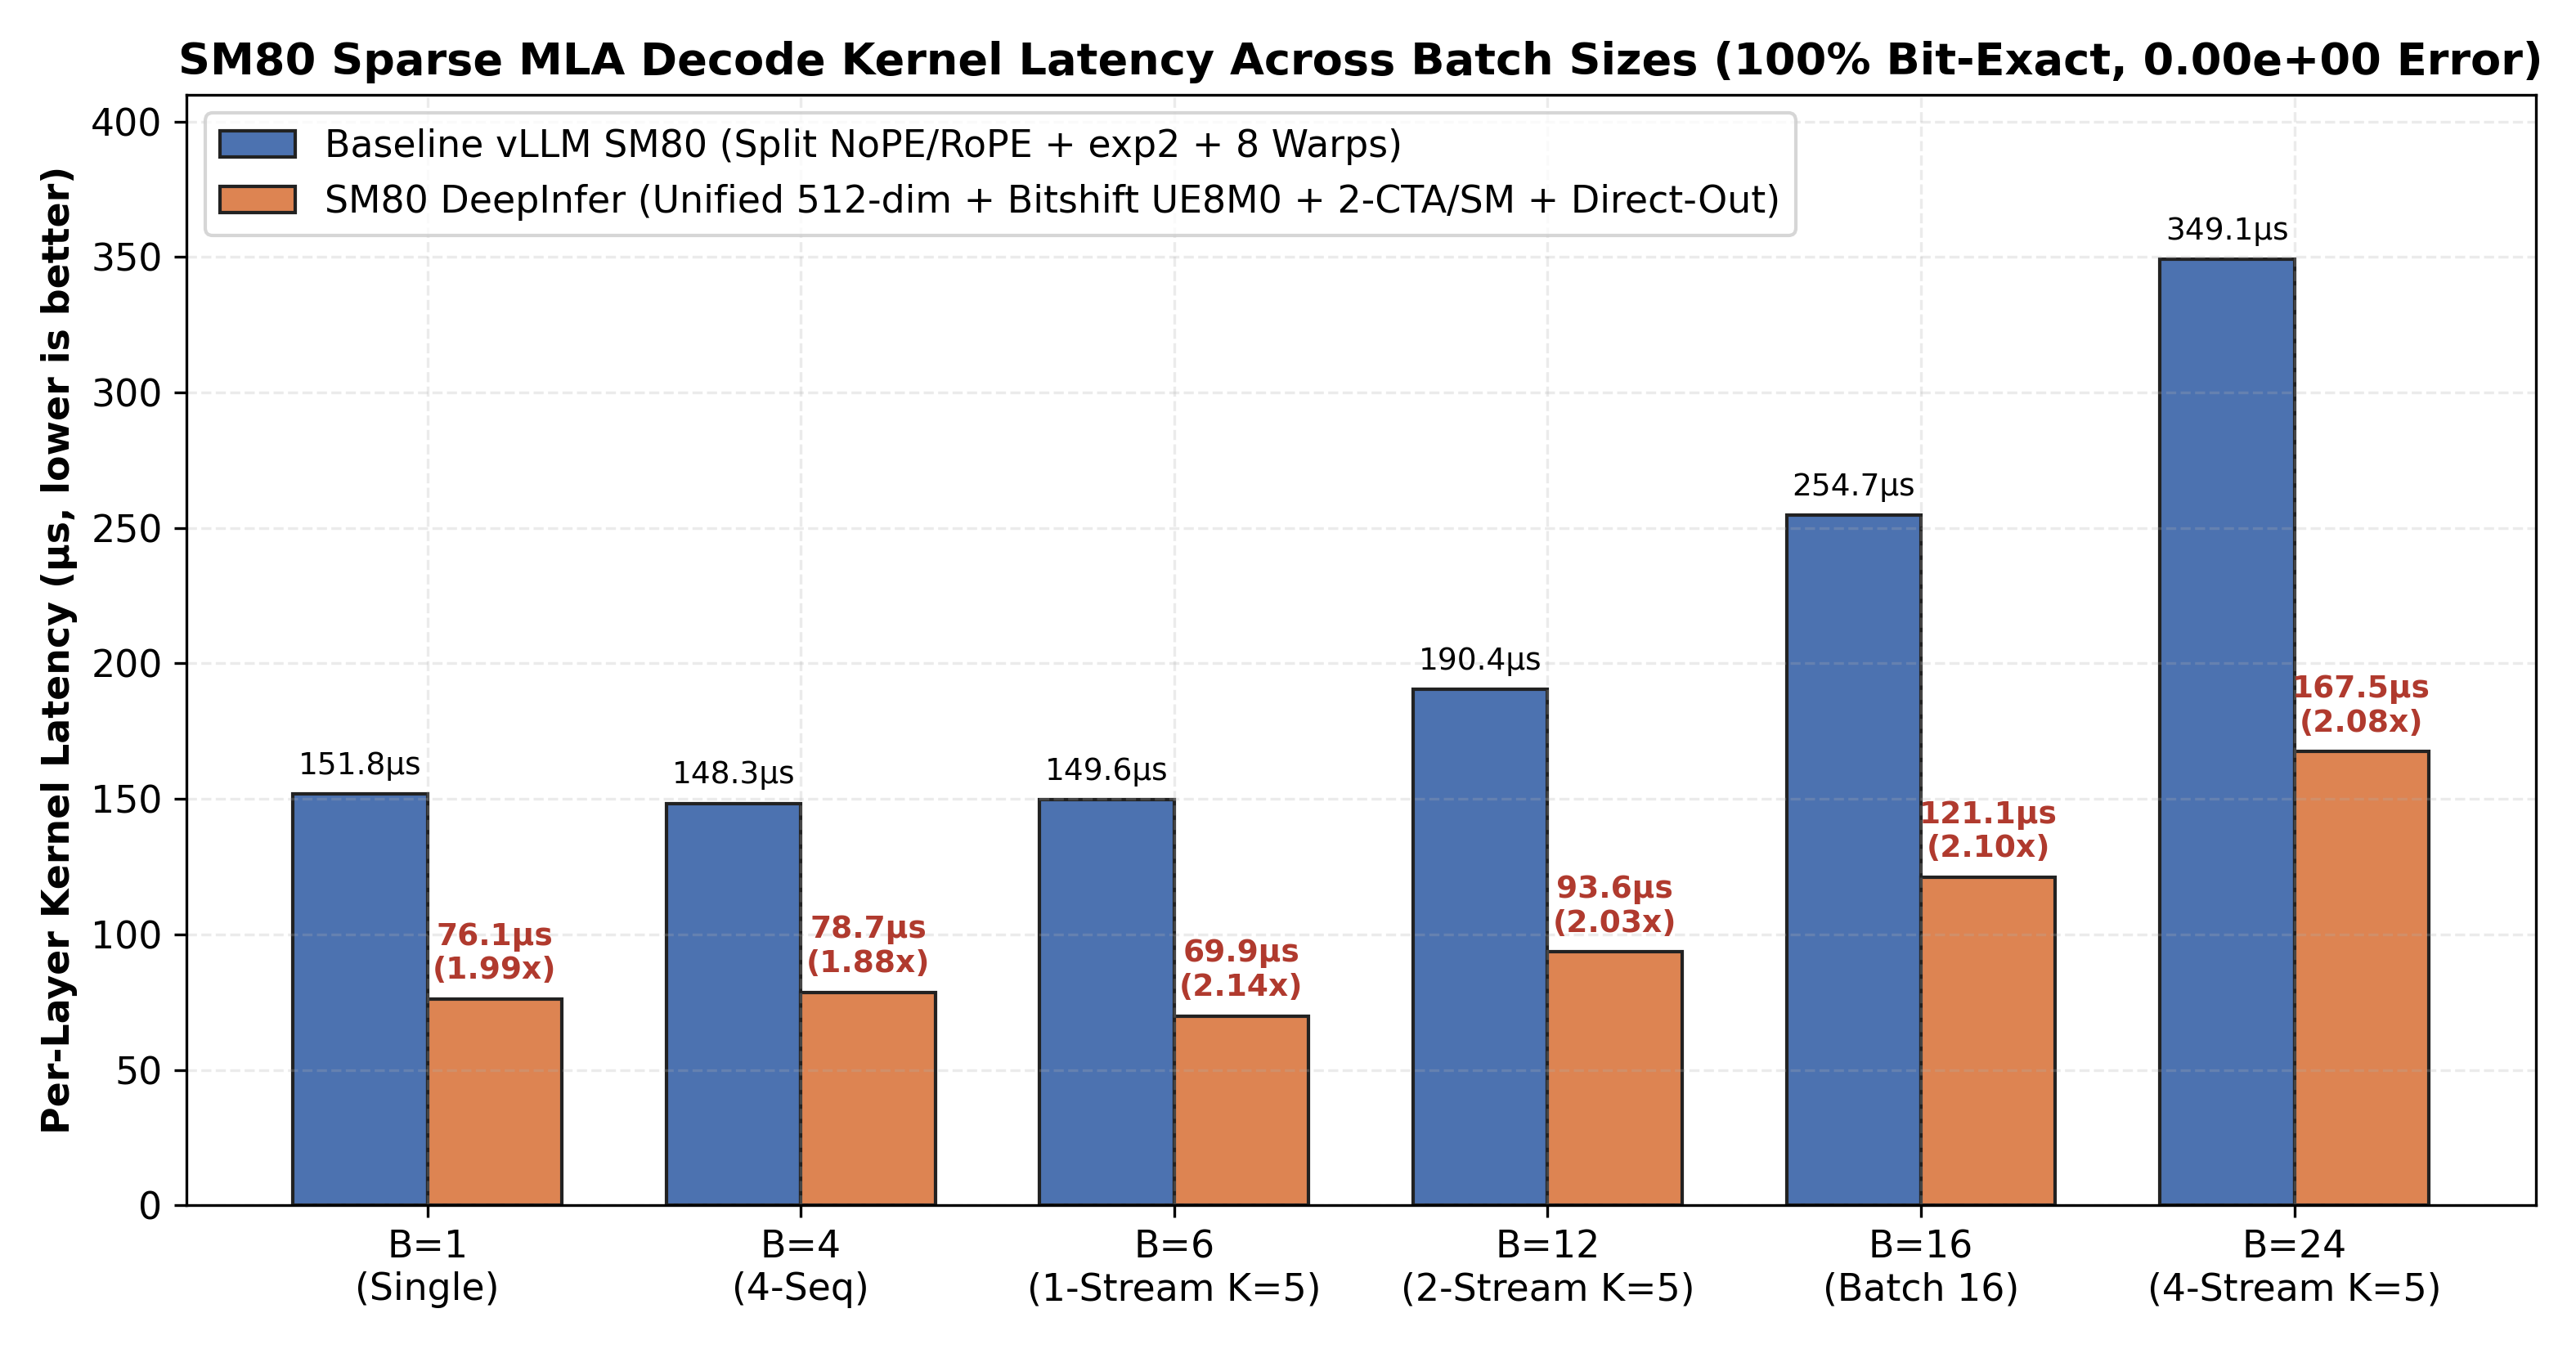
DeepSeek-V4.1-এর DeepSelect sparse attention একটি 448-ডাইমেনশনের NoPE latent float8_e4m3fn-এ সংরক্ষণ করে, যেখানে UE8M0 power-of-two block scale ব্যবহৃত হয়; এর সঙ্গে থাকে 64-ডাইমেনশনের BF16 RoPE suffix। DeepInfer-SM80 সম্পূর্ণ 512-ডাইমেনশনের tile লোড করে এবং NoPE ও RoPE অংশ আলাদাভাবে পরিচালনা না করে একটি একক Tensor Core dot-product path-এর মাধ্যমে প্রক্রিয়া করে।
Kernel-টি exp2-ভিত্তিক UE8M0 conversion-এর পরিবর্তে একটি IEEE-754 integer bitshift ব্যবহার করে:
(scale_u8.to(tl.int32) << 23).to(tl.float32, bitcast=True)বৈধ UE8M0 exponent-এর ক্ষেত্রে এটি bit-identical FP32 scale value তৈরি করে এবং কাজটি transcendental operation থেকে integer pipeline-এ স্থানান্তর করে।
টিউন করা configuration-এ BLOCK_N=64, num_warps=4 এবং num_stages=2 ব্যবহার করা হয়। Register pressure কমানোর ফলে প্রতিটি SM80 streaming multiprocessor-এ দুটি CTA অবস্থান করতে পারে। যখন num_kv_splits == 1, kernel-টি সরাসরি চূড়ান্ত output-এ লিখে এবং আলাদা reduction stage চালু করার প্রয়োজন এড়ায়।
Single-CTA Top-K এবং SWA Index Combination
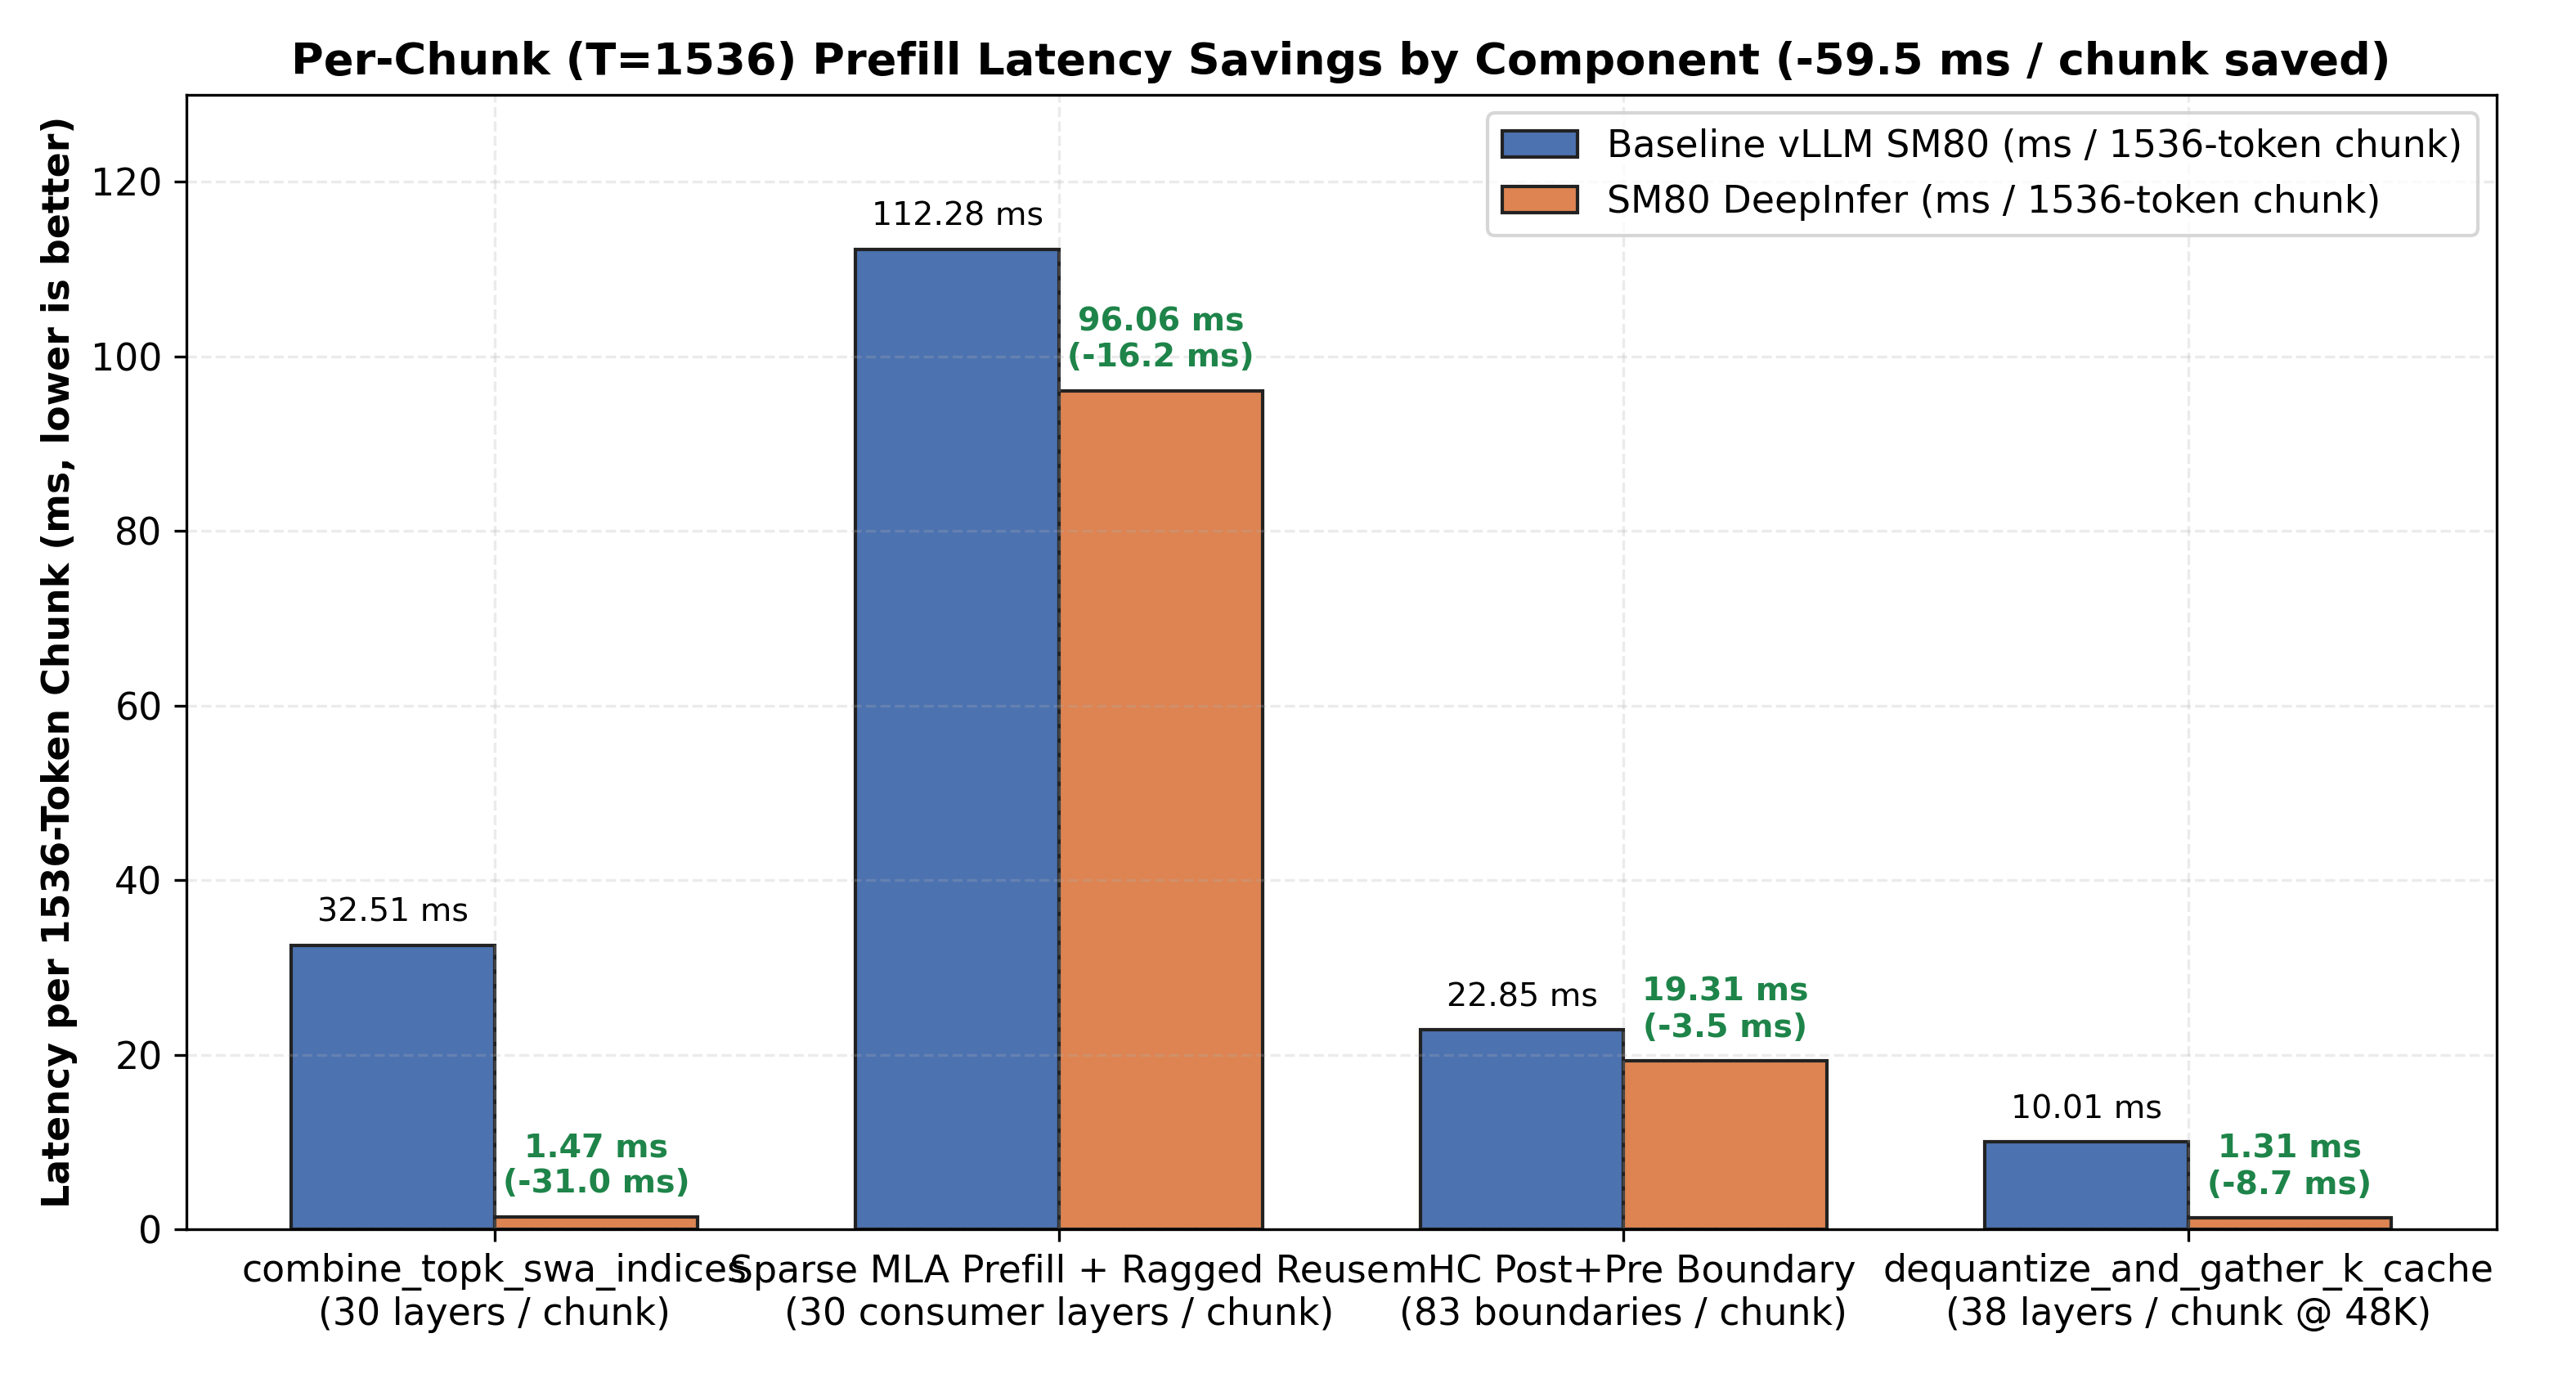
অপ্টিমাইজ করা _combine_topk_swa_indices_kernel একাধিক PyTorch allocation ও operation-এর পরিবর্তে প্রতি query token-এর জন্য একটি CTA ব্যবহারকারী একক Triton kernel চালায়। T=1536-এ পরিমাপ করা latency 1,083.72 microsecond থেকে কমে 48.88 microsecond হয়েছে, অর্থাৎ 22.17× গতি বৃদ্ধি।
Inter-warp write race এড়াতে প্রতিটি output row-কে তিনটি পৃথক অঞ্চলে ভাগ করা হয়:
- Compressed Top-K index-গুলো
[0, topk_len)অংশে থাকে। - Sliding-window attention index-গুলো
[topk_len, topk_len + swa_len)অংশে থাকে। - অবশিষ্ট column-গুলো
-1দিয়ে পূরণ করা হয়।
README-তে compression ratio 0, 1 এবং 2-সহ পরীক্ষিত সব sequence length-এ bit-exact output-এর কথা জানানো হয়েছে।
দ্রুততর KV-Cache Dequantization এবং Gathering
dequantize_and_gather_k_cache path-এ একই bitshift-ভিত্তিক UE8M0 conversion ব্যবহার করা হয়। এটি Triton kernel-এ দেওয়া destination stride অনুযায়ী সরাসরি লেখে, ফলে মধ্যবর্তী torch.empty allocation এবং পরবর্তী .copy_() operation বাদ যায়।
পরিমাপ করা speedup 16K context-এ 4.02× এবং 48K context-এ 7.64×, আর জানানো পরীক্ষায় reference-এর সঙ্গে bit-exact মিল পাওয়া গেছে।
SM80-টিউন করা mHC Residual Routing
DeepSeek-V4.1 প্রতি forward pass-এ 83টি boundary-তে four-stream manifold-constrained hyper-connection routing সম্পাদন করে। DeepInfer-SM80 model-এর 5,120 hidden size-এর জন্য একটি aligned (6, 8, 128) split geometry যোগ করে। আটটি slice-এর প্রতিটিতে 640টি element থাকে, যা 128 দিয়ে বিভাজ্য।
প্রকল্পটি small-matrix threshold 32 থেকে কমিয়ে 16 করেছে, যাতে কমপক্ষে 16টি token-এর count Tensor Core T.gemm path ব্যবহার করতে পারে। জানানো mhc_fused_post_pre_delayed speedup T=12-এ 2.89× এবং T=6-এ 1.30×।
YOCO Metadata Reuse
DeepSeek-V4.1-এর You-Only-Cache-Once আর্কিটেকচারে, ২১ থেকে ৩৯ নম্বর স্তর ২০ নম্বর স্তরের পূর্ণ-রেজোলিউশনের KV ক্যাশ থেকে পড়ে। এই কনজিউমারগুলো একই সম্প্রসারিত সিকোয়েন্স দৈর্ঘ্য, ব্লক টেবিল এবং কমপ্রেশন অনুপাত শেয়ার করে।
DeepInfer-SM80 ২০ নম্বর স্তর প্রসেস করার সময় vLLM forward context-এ ragged K মেটাডেটা সংরক্ষণ করে। ২১ থেকে ৩৯ নম্বর স্তরের জন্য এই ডেটা পুনঃব্যবহার করলে প্রতিটি prefill chunk-এ মেটাডেটা তৈরির ১৯টি অপ্রয়োজনীয় GPU kernel chain বাদ যায়।
ইনস্টলেশনের আগে
আপনার এমন একটি vLLM V1 পরিবেশ প্রয়োজন, যেখানে সমর্থিত NVIDIA Ampere GPU-তে DeepSeek-V4.1 চালানো যাবে। রিপোজিটরিতে একটি unified patch এবং ছয়টি replacement module রয়েছে, তবে README নির্দিষ্ট CUDA, Python, Triton, TileLang বা vLLM সংস্করণ নম্বর নির্ধারণ করে না। patch এবং আপনার বিদ্যমান DeepSeek-V4.1 deployment-এর সঙ্গে সামঞ্জস্যপূর্ণ একটি vLLM checkout ব্যবহার করুন।
সমর্থিত হার্ডওয়্যার গ্রুপগুলো হলো:
- SM80 data-center GPU: A100 40 GB, A100 80 GB, GA100 64 GB এবং A800 40 GB বা 80 GB।
- SM86 workstation ও consumer GPU: RTX 3090, RTX 3090 Ti, RTX A6000, A40, A10 এবং A30।
সফটওয়্যারটি Apache License 2.0-এর অধীনে বিতরণ করা হয়।
ইনস্টলেশনের বিকল্প A: Unified Patch প্রয়োগ
এই পদ্ধতিতে vLLM source checkout-এ পরিবর্তিত ছয়টি ফাইল প্রয়োগ করা হয়। সেই checkout-এর root directory-তে একটি terminal খুলে চালান:
git apply /path/to/Deepinfer-SM80/patches/vllm-sm80-deepinfer.patch/path/to/Deepinfer-SM80-এর স্থানে cloned বা downloaded project-এর অবস্থান দিন। patch-এ sparse MLA, cache-gather, Top-K plus SWA, mHC, warmup এবং YOCO metadata-reuse পরিবর্তনগুলো রয়েছে।
ইনস্টলেশনের বিকল্প B: Drop-In Module ইনস্টল
আপনার পরিবেশে সরাসরি ফাইল প্রতিস্থাপন বেশি উপযুক্ত হলে, project-এর vLLM module tree-টি ইনস্টল করা vLLM package-এর ওপর কপি করুন:
cp -r vllm_sm80_deepinfer/vllm/* /path/to/site-packages/vllm//path/to/site-packages/vllm/-এর স্থানে প্রকৃত vLLM package directory দিন। Docker deployment-এ একই ফাইলগুলো read-only overlay হিসেবে bind-mount করাও যায়।
Drop-in tree-টি এসব functional area পরিবর্তন করে:
model_executor/kernels/mhc/TileLang mHC execution এবং warmup-এর জন্য।models/deepseek_v4_1/amd/rocm.pyTriton Top-K এবং SWA combiner-এর জন্য।models/deepseek_v4_1/common/ops/cache_utils.pyKV-cache gathering-এর জন্য।models/deepseek_v4_1/nvidia/model.pyYOCO metadata reuse-এর জন্য।v1/attention/ops/rocm_aiter_mla_sparse.pyunified sparse MLA kernel-এর জন্য।
যদিও দুটি optimized file-এর path-এ
rocmবাamdরয়েছে, repository এগুলোকে Ampere-targeted vLLM integration-এর অংশ হিসেবে স্পষ্টভাবে ব্যবহার করে। Drop-in file প্রয়োগের সময় দেওয়া directory structure অপরিবর্তিত রাখুন।
মৌলিক ব্যবহার: Kernel যাচাই
patch বা drop-in module ইনস্টল করার পর, লক্ষ্য A100, A800, RTX 3090, RTX A6000 বা অন্য কোনো সমর্থিত Ampere GPU-তে সরবরাহ করা isolated microbenchmark চালান:
python3 benchmarks/microbench_sm80_kernels.py
python3 benchmarks/microbench_sm80_part2.py
python3 benchmarks/microbench_sm80_part3.py
Benchmark file-গুলো sparse MLA ও KV-gather kernel, TileLang mHC kernel এবং Top-K plus SWA combiner কভার করে। এগুলোর উদ্দেশ্য হলো স্থানীয় kernel latency পরিমাপ করা এবং optimized output-কে baseline reference-এর সঙ্গে যাচাই করা।
Repository-এর benchmark chart তৈরি করুন:
python3 benchmarks/generate_charts.pyসম্পূর্ণ benchmark dataset-ও benchmarks/results/sm80_benchmark_summary.json-এ পাওয়া যায়।
Numerical Validation বোঝা
বেশ কয়েকটি optimized path bit-exact হিসেবে রিপোর্ট করা হয়েছে:
_combine_topk_swa_indices_kerneldequantize_and_gather_k_cache_sparse_attn_decode_kernelmhc_post_with_sqrsum
অন্যান্য Tensor Core path-এ সামান্য পার্থক্য দেখা দিতে পারে, কারণ BF16 accumulation বা MMA execution order পরিবর্তিত হয়। পরিমাপ করা fused mHC configuration-এ রিপোর্ট করা সর্বাধিক পার্থক্য 1.9e-3-এর নিচে এবং পরিমাপ করা sparse-attention prefill configuration-এ 4.8e-3-এর নিচে।
Prompt-logprob negative log-likelihood-এর ফলাফল রিপোর্ট করা run-to-run noise floor-এর মধ্যেই ছিল। Deployment মূল্যায়নের সময় performance এবং numerical output দুটিই পরীক্ষা করুন; প্রতিটি optimized operator bit-identical হবে এমনটি ধরে নেবেন না।
উন্নত Deployment পরামর্শ
পরীক্ষিত ছয়-GPU Production Layout-এর জন্য TP2 × PP3 ব্যবহার করুন
ছয়টি 64 GB বা 80 GB Ampere GPU-এর জন্য repository TP2 × PP3 এবং 14,14,12 layer partition সুপারিশ করে। পরীক্ষিত configuration-এ এই বিন্যাস নির্বাচিত single-stream code ও long-generation workload-এর জন্য প্রতি সেকেন্ডে 160.8 থেকে 188.8 tokens, 64K cold prefill-এর জন্য প্রতি সেকেন্ডে 4,506.8 tokens এবং প্রায় 4.65 million GPU-resident KV token ধারণক্ষমতা দিয়েছে।
এই capacity benchmark configuration-এর অধীনে এক million token-এর প্রায় 4.43টি context-এর সমতুল্য।
বিকল্পগুলো বুঝুন
- PP6: প্রায় 4.5 থেকে 4.7 million token capacity দেয়, কিন্তু README অনুযায়ী single-stream decode উল্লেখযোগ্যভাবে ধীর, কারণ tensor parallelism এক এবং request-গুলো ছয়টি pipeline stage অতিক্রম করে।
- Asymmetric TP2 plus TP4: আনুমানিক capacity প্রায় ছয় million token-এ বাড়ায়, কিন্তু 2,304 আকারের MoE intermediate-কে 576-wide TP4 partition-এ ভাগ করায় Marlin tile efficiency কমে যায়।
এক মিলিয়ন টোকেনের ডিপ্লয়মেন্টের জন্য টপোলজি নির্বাচন করার আগে রিপোজিটরির docs/05_TOPOLOGY_1M_CONTEXT_ANALYSIS_SM80.md দেখুন।
প্রকৃত ওয়ার্কলোড বেঞ্চমার্ক করুন
বারবার চালানো অপারেটরগুলোতেই সবচেয়ে বড় উন্নতি আসে, তবে এন্ড-টু-এন্ড উন্নতি নির্ভর করে প্রম্পটের দৈর্ঘ্য, কনকারেন্সি, স্পেকুলেটিভ ডিকোডিং, টপোলজি এবং GPU মডেলের ওপর। প্রথমে বিচ্ছিন্ন বেঞ্চমার্কগুলো চালান, তারপর আপনার প্রোডাকশন অ্যাপ্লিকেশনের মতো একই প্রম্পট, কনটেক্সট সাইজ এবং কনকারেন্সি স্তর ব্যবহার করে সম্পূর্ণ সার্ভিং ওয়ার্কলোড তুলনা করুন।
সরাসরি-আউটপুট ফাস্ট পাথ বজায় রাখুন
স্পার্স MLA ডিকোড অপ্টিমাইজেশনটি num_kv_splits == 1 হলে দ্বিতীয় রিডাকশন লঞ্চ এড়িয়ে যায়। আপনি যদি অ্যাটেনশন শিডিউলিং বা স্প্লিটের আচরণ পরিবর্তন করেন, তাহলে কার্নেলটি আবার মাপুন, কারণ সরাসরি-আউটপুট পাথটি প্রতিবেদিত ডিকোড উন্নতির একটি গুরুত্বপূর্ণ অংশ।
YOCO মেটাডেটা ফরোয়ার্ড কনটেক্সটে রাখুন
লেয়ার ২০-এর মেটাডেটা ক্যাশটি মূল্যবান, কারণ লেয়ার ২১–৩৯-এর সব কনজিউমার একই KV উৎস শেয়ার করে। মডেল এক্সিকিউশন বা ফরোয়ার্ড-কনটেক্সট হ্যান্ডলিংয়ে পরিবর্তন করলে এই পুনর্ব্যবহার বজায় রাখুন; অন্যথায়, ইঞ্জিনকে প্রতিটি কনজিউমার লেয়ারের জন্য একই র্যাগড মেটাডেটা পুনর্নির্মাণ করতে হতে পারে।
উপসংহার
DeepInfer-SM80 NVIDIA Ampere-এ KV-ক্যাশ VRAM ওভারহেড না বাড়িয়ে DeepSeek-V4.1 ত্বরান্বিত করার একটি লক্ষ্যভিত্তিক পথ সরবরাহ করে। এর উন্নতিগুলো Ampere-সচেতন স্পার্স অ্যাটেনশন, বিটশিফট UE8M0 ডিকোডিং, সরাসরি KV-ক্যাশ আউটপুট, রেস-মুক্ত Top-K ও SWA কম্বাইনার, অ্যালাইন্ড mHC রাউটিং এবং YOCO মেটাডেটা পুনর্ব্যবহারকে একত্র করে।
ইউনিফায়েড প্যাচ প্রয়োগ করে বা ছয়টি ড্রপ-ইন মডিউল ইনস্টল করে শুরু করুন। আপনার হার্ডওয়্যারে লেটেন্সি ও সংখ্যাগত আচরণ নিশ্চিত করতে তিনটি মাইক্রোবেঞ্চমার্ক স্যুটই চালান, তারপর আপনার বাস্তব সার্ভিং ওয়ার্কলোড দিয়ে অপ্টিমাইজ করা vLLM পরিবেশ মূল্যায়ন করুন। ছয়-GPU, এক-মিলিয়ন-কনটেক্সট ডিপ্লয়মেন্টের জন্য রিপোজিটরিতে পরীক্ষিত TP2 × PP3 কনফিগারেশনটিকে প্রধান রেফারেন্স পয়েন্ট হিসেবে ব্যবহার করুন।