

AIBuildAI LLM-Post-Train Agent কী?
AIBuildAI LLM-Post-Train Agent হলো বড় ভাষা মডেলের স্বয়ংক্রিয় ও কাস্টমাইজড পোস্ট-ট্রেনিংয়ের জন্য একটি পুনরাবৃত্তিমূলক, স্ব-উন্নয়নশীল এজেন্ট। একটি নির্দিষ্ট প্রশিক্ষণ পদ্ধতি প্রয়োগ করার পরিবর্তে, এটি একটি কাজ বিশ্লেষণ করে, সম্ভাব্য পোস্ট-ট্রেনিং অ্যালগরিদম তৈরি করে, প্রশিক্ষণ ডেটা সংগ্রহ ও পরিশোধন করে, কোড লেখে, পরীক্ষা চালায়, ফলাফল মূল্যায়ন করে এবং ধাপে ধাপে মডেলটির উন্নতি ঘটায়।
রিপোজিটরিতে এজেন্টটি চালানো, পড়া এবং পরিবর্তন করার সোর্স কোড রয়েছে। এটি এমন প্রতিষ্ঠান ও গবেষকদের জন্য তৈরি, যাদের নিজস্ব ডেটা, মডেল পরিবার, মূল্যায়ন পদ্ধতি এবং ডিপ্লয়মেন্ট লক্ষ্য অনুযায়ী নির্দিষ্ট পোস্ট-ট্রেনিং কৌশল প্রয়োজন।
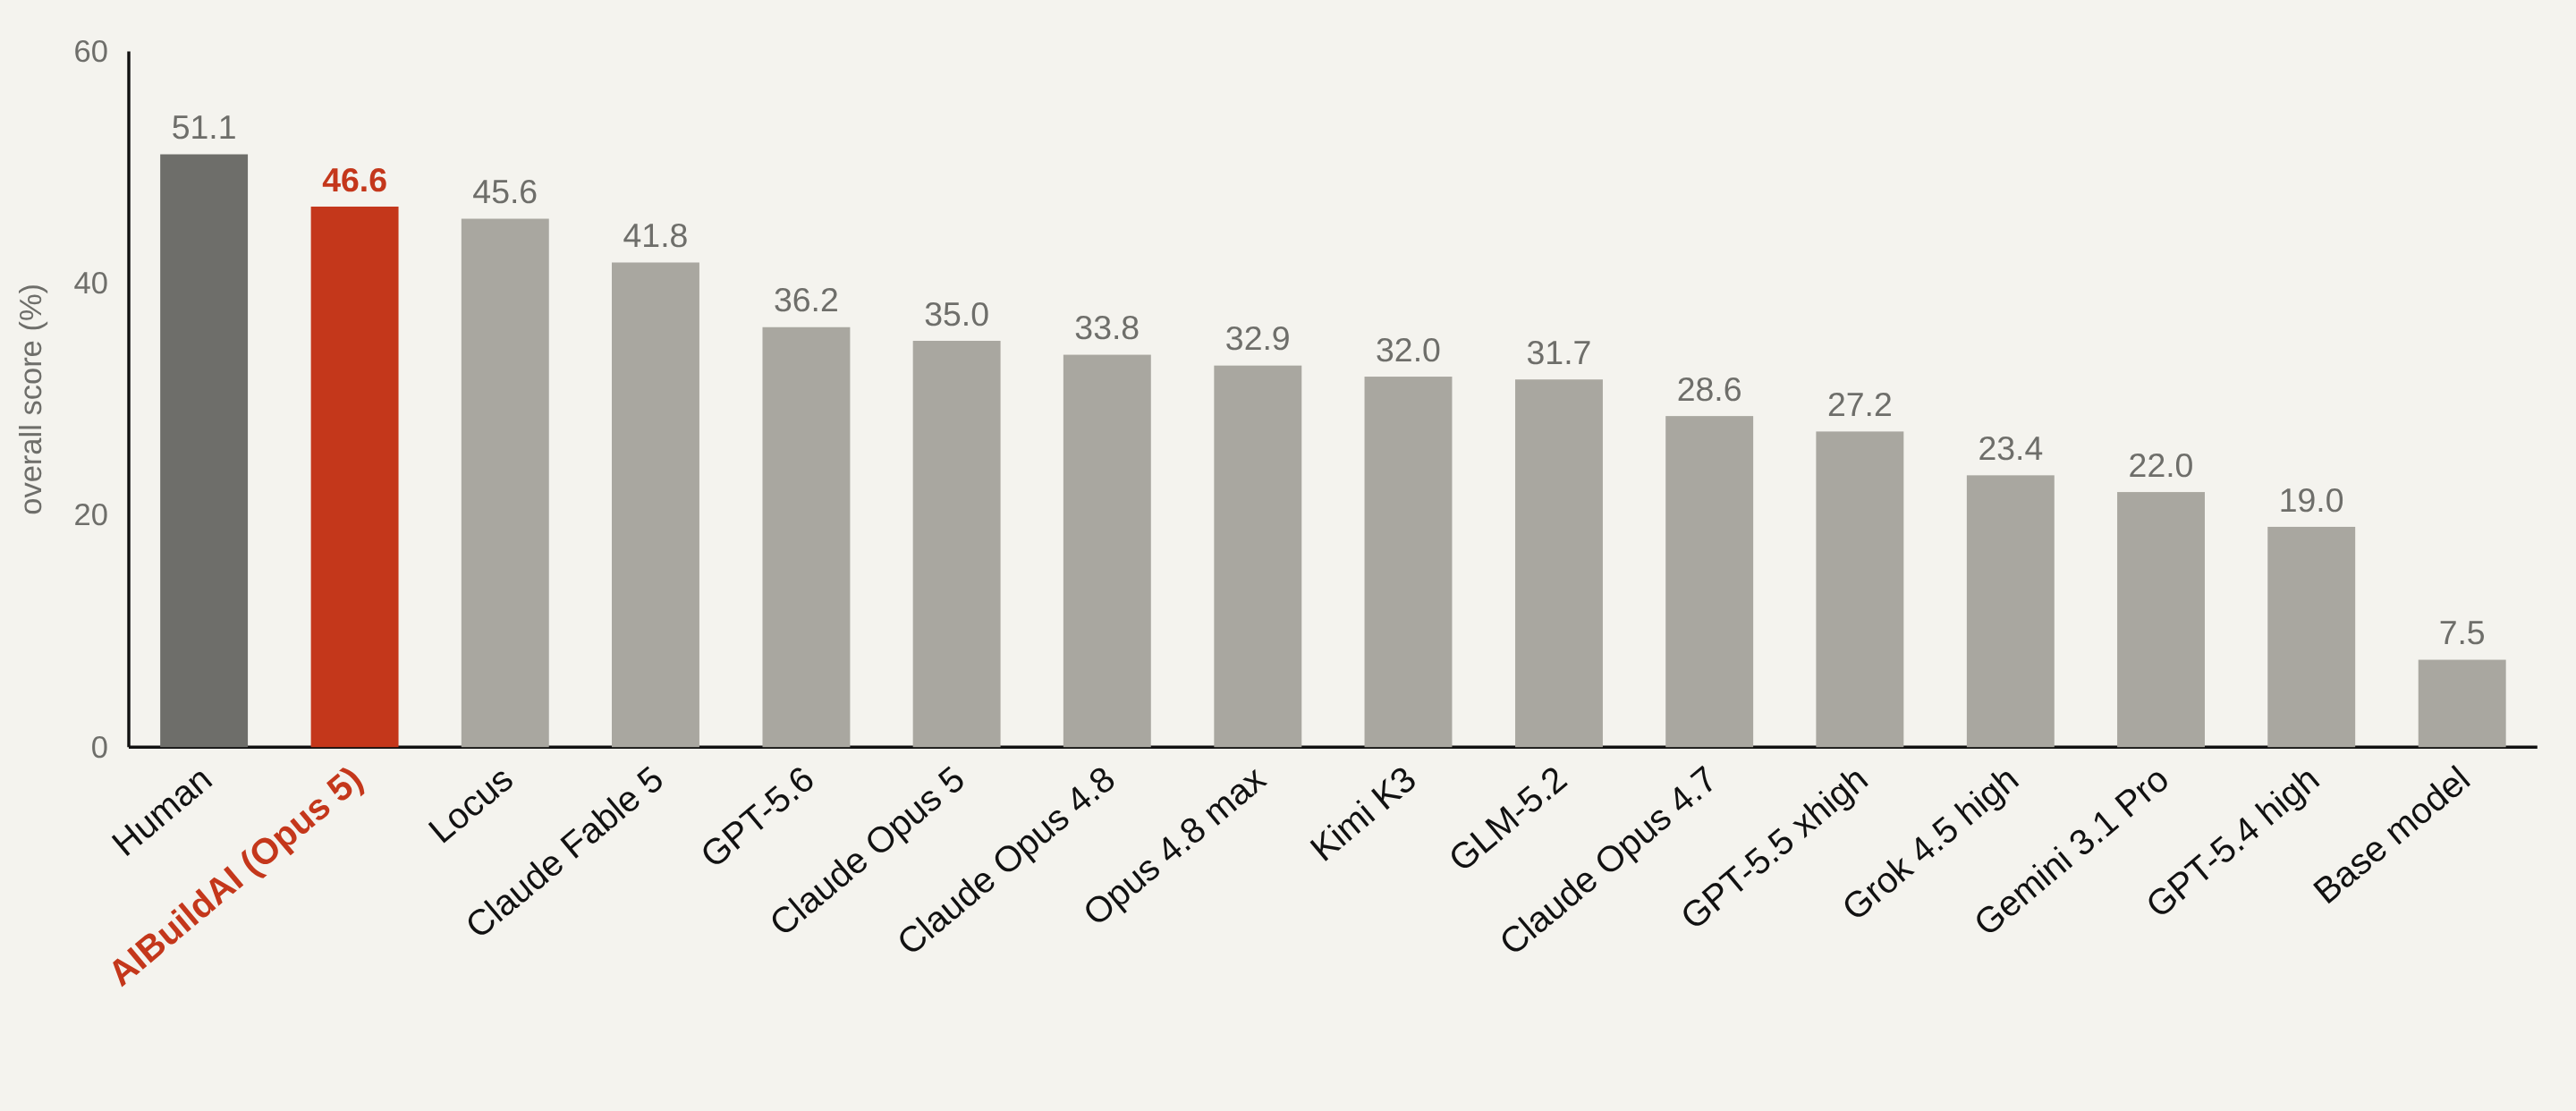
PostTrainBench-এ প্রকল্পটি 46.6% সামগ্রিক স্কোর পেয়েছে। মূল্যায়িত মডেল ও এজেন্টগুলোর মধ্যে এটি প্রথম এবং 51.1% মানব বিশেষজ্ঞের বেসলাইনের পরেই অবস্থান করছে।
এজেন্টটি কীভাবে কাজ করে
একটি রান শুরু হয় একটি কাজ এবং স্কোর নির্ধারণের পদ্ধতি দিয়ে। সিস্টেমটি একটি অপরিবর্তনীয় কাজের বিবরণ প্রস্তুত করে, বেসলাইন স্থাপন করে, পরীক্ষা চালু করে, একই স্কোর প্রোগ্রাম ব্যবহার করে প্রতিটি সম্পন্ন প্রার্থীকে মূল্যায়ন করে এবং সেরা ফলাফলকে ডেলিভারেবল হিসেবে প্রস্তুত করে।
দুটি সক্ষমতা সিস্টেমটিকে সাধারণ কোডিং এজেন্ট থেকে আলাদা করে:
- জ্ঞান ব্যবস্থা: এজেন্টরা MCP-এর মাধ্যমে AIBuildAI Knowledge Base-এ অনুসন্ধান করতে পারে। এর নির্বাচিত দক্ষতা-সংক্রান্ত নথিগুলো পোস্ট-ট্রেনিং ওয়ার্কফ্লো, পদ্ধতি, ডেটাসেট এবং ফ্রেমওয়ার্ক কভার করে।
- মেটা সার্চ: একটি মেটা এজেন্ট কাজটি বিশ্লেষণ করে পূর্বনির্ধারিত পরীক্ষার কাঠামো চালানোর পরিবর্তে কাজ-নির্দিষ্ট সার্চ প্রোগ্রাম লিখতে পারে।
প্রতিটি রান একটি লাইভ ওয়েব ওয়ার্কস্পেস, স্থায়ী এক্সিকিউশন গ্রাফ, জার্নালভুক্ত কাজের ইউনিট, স্যান্ডবক্স করা সাবপ্রসেস এবং রিসোর্স নিয়ন্ত্রণও পায়। রান-সংক্রান্ত ইভেন্টগুলো ~/.aibuildai/postgresql-এর অধীনে একটি ব্যক্তিগত PostgreSQL ক্লাস্টারে সংরক্ষিত হয়, যা রান পুনরায় চালু ও পুনরায় প্লে করার সুবিধা দেয়।
প্রধান বৈশিষ্ট্য
- LLM পোস্ট-ট্রেনিং পরীক্ষার স্বয়ংক্রিয় নকশা ও পরিচালনা।
- মেটা সার্চ এবং বিভিন্ন নির্দিষ্ট সার্চ পদ্ধতিসহ কাজ-নির্দিষ্ট সার্চ কৌশল।
- পদ্ধতি, ডেটাসেট, ফ্রেমওয়ার্ক এবং ওয়ার্কফ্লো-সংক্রান্ত সিদ্ধান্তের জন্য জ্ঞান পুনরুদ্ধার।
- টাইপযুক্ত এজেন্ট, নির্ধারিত ফলদায়ী প্রোগ্রাম এবং নেস্টেড সার্চ।
- কাজ-নির্ধারিত গ্রেডিং এবং প্রার্থীদের সামঞ্জস্যপূর্ণ র্যাঙ্কিং।
- স্থানীয় ওয়ার্কস্পেস সার্ভিসের মাধ্যমে লাইভ ব্রাউজার-ভিত্তিক পর্যবেক্ষণ।
- মেমরি ও প্রসেসের জন্য Bubblewrap স্যান্ডবক্স এবং cgroup-v2 সীমা।
- পূর্ববর্তী রান থেকে তৈরি স্থানীয় মেমরি।
- অ্যাগ্রিগেশনের পর ঐচ্ছিক পেপার খসড়া তৈরি ও PDF কম্পাইল।
- Claude এবং Anthropic-সামঞ্জস্যপূর্ণ এন্ডপয়েন্টের মাধ্যমে উন্মুক্ত অন্যান্য মডেলের সমর্থন।
সিস্টেমের প্রয়োজনীয়তা
প্রকল্পটি ইনস্টল করার আগে নিশ্চিত করুন যে হোস্ট সিস্টেমটি এই প্রয়োজনীয়তাগুলো পূরণ করে:
- systemd user session-সহ x86_64 Linux।
- Python 3.11 থেকে 3.13।
gccএবংmake-সহ একটি C toolchain।- zlib এবং readline-এর ডেভেলপমেন্ট হেডার।
bubblewrapপ্যাকেজের মাধ্যমে সরবরাহ করাbwrap, যেখানে unprivileged user namespace সক্রিয় থাকতে হবে।- GitHub releases এবং
ftp.postgresql.org-এ নেটওয়ার্ক অ্যাক্সেস। - Claude Code লগইন, Anthropic API key, অথবা Anthropic-সামঞ্জস্যপূর্ণ এন্ডপয়েন্টের মাধ্যমে উপলভ্য অন্য কোনো মডেল।
- CUDA GPU সুপারিশ করা হয়, তবে এজেন্টগুলো উপলভ্য হার্ডওয়্যার শনাক্ত করে ব্যবহার করে।
প্রথম রানটি অফিসিয়াল সোর্স টারবল থেকে একটি ব্যক্তিগত PostgreSQL ইনস্টলেশন তৈরি করে। এটি ~/.cache/aibuildai-এ ruff, tectonic, micromamba, caddy এবং PostgreSQL-এর মতো টুলগুলোর নির্দিষ্ট সংস্করণের কপিও ডাউনলোড করে। সিস্টেমটি হোস্টে ইনস্টল করা সমতুল্য টুলের পরিবর্তে নিজস্ব মালিকানাধীন কপিগুলো ব্যবহার করে।
আপনার conda প্রয়োজন নেই। এজেন্টটি নিজস্ব micromamba ইনস্টলেশন দিয়ে Program environment তৈরি করে।
cgroup-v2 delegation পরীক্ষা করুন
একটি রান একটি cgroup-v2 ট্রি দ্বারা সীমাবদ্ধ থাকে। systemd user manager-কে অন্তত memory এবং pids controller delegate করতে হবে। বর্তমান কনফিগারেশন পরীক্ষা করুন:
U=$(id -u)
cat /sys/fs/cgroup/user.slice/user-$U.slice/user@$U.service/cgroup.subtree_control
আউটপুটে memory এবং pids থাকা উচিত। কোনোটি অনুপস্থিত থাকলে একজন প্রশাসককে /etc/systemd/system/user@$U.service.d/-এর অধীনে একটি drop-in-এ Delegate=pids memory cpu যোগ করতে হবে, systemd পুনরায় লোড করতে হবে এবং আপনাকে আবার লগইন করতে হবে।
এজেন্ট ইনস্টল করুন
1. অপারেটিং-সিস্টেম প্যাকেজ ইনস্টল করুন
Debian বা Ubuntu-তে কম্পাইলার, প্রয়োজনীয় হেডার এবং bubblewrap ইনস্টল করুন:
sudo apt-get install build-essential zlib1g-dev libreadline-dev bubblewrap2. রিপোজিটরি ক্লোন করুন
git clone https://github.com/aibuildai-inc/aibuildai-llm-posttrain-agent.git
cd aibuildai-llm-posttrain-agent
3. Python virtual environment তৈরি করুন
python -m venv .venv
source .venv/bin/activate
4. নির্দিষ্ট সংস্করণের dependency ইনস্টল করুন
pip install -r requirements.lock
pip install -e . --no-deps
Editable installation-টি aibuildai কমান্ড সরবরাহ করে। lock file ব্যবহার করুন, কারণ claude-agent-sdk-এর নির্দিষ্ট সংস্করণটিই এই codebase-এর জন্য যাচাই করা হয়েছে।
আপনি যদি রিপোজিটরি পরিবর্তন করে এর quality gate চালানোর পরিকল্পনা করেন, তাহলে ডেভেলপমেন্ট dependency-ও ইনস্টল করুন:
pip install -r requirements-dev.lock5. ঐচ্ছিকভাবে নিজস্ব টুল প্রস্তুত করুন
প্রথমবার চালানোর সময় টুলগুলো ডাউনলোড ও বিল্ড করা যায়। আগে থেকেই প্রস্তুত করতে চালান:
aibuildai setupমডেল অ্যাক্সেস কনফিগার করুন
বিকল্প ১: Claude Code লগইন ব্যবহার করুন
claude auth loginবিকল্প ২: একটি API কী দিন
export AIBUILDAI_API_KEY=sk-ant-...AIBUILDAI_API_KEY সেট করা না থাকলে, অ্যাপ্লিকেশনটি প্রথমে ANTHROPIC_AUTH_TOKEN এবং এরপর ANTHROPIC_API_KEY পরীক্ষা করে।
অন্য Anthropic-সামঞ্জস্যপূর্ণ এন্ডপয়েন্ট ব্যবহার করুন
এন্ডপয়েন্টে AIBUILDAI_BASE_URL সেট করুন এবং এর কী AIBUILDAI_API_KEY-এ রাখুন:
export AIBUILDAI_BASE_URL=https://openrouter.ai/api
export AIBUILDAI_API_KEY=your-key
export AIBUILDAI_SMALL_FAST_MODEL=provider/model-id
deepseek- দিয়ে শুরু হওয়া সরাসরি মডেল শনাক্তকারীগুলো স্বয়ংক্রিয়ভাবে DeepSeek-এর Anthropic-সামঞ্জস্যপূর্ণ এন্ডপয়েন্টে নির্দেশ করে। OpenRouter মডেল শনাক্তকারীতে একটি provider prefix থাকে এবং AIBUILDAI_BASE_URL ও AIBUILDAI_SMALL_FAST_MODEL উভয়ই প্রয়োজন।
কোনো এন্ডপয়েন্টে Claude মডেল স্তরের জন্য ভিন্ন নাম ব্যবহার হলে AIBUILDAI_HAIKU_MODEL, AIBUILDAI_SONNET_MODEL এবং AIBUILDAI_OPUS_MODEL দিয়ে সেগুলোর ম্যাপিং করুন। সাব-এজেন্টদের তাদের ভূমিকার জন্য কনফিগার করা মডেলের বদলে অন্য মডেলে চালাতে হলে AIBUILDAI_SUBAGENT_MODEL ব্যবহার করুন।
ঐচ্ছিক সার্ভিস সেটিংস
AIBUILDAI_KB_BASE_URLজ্ঞানভিত্তিক MCP সার্ভিস নির্বাচন করে। ডিফল্টভাবে, ক্লায়েন্টটি প্রকল্পের সর্বজনীন নির্দিষ্ট স্ন্যাপশট ব্যবহার করে।AIBUILDAI_KB_TOKENজ্ঞান সার্ভিসে প্রমাণীকরণ প্রয়োজন হলে bearer token সরবরাহ করে।AIBUILDAI_WEB_PORTস্থানীয় workspace সার্ভিসের পোর্ট নির্বাচন করে।AIBUILDAI_WEB_NAMEএকই হোস্টে থাকা দ্বিতীয় workspace সার্ভিসের নাম নির্ধারণ করে এবং একটি স্পষ্ট web port প্রয়োজন।
একটি সাধারণ রান তৈরি ও চালু করুন
প্রতিটি রান একটি YAML ফাইল দিয়ে বর্ণিত হয়। ডকুমেন্টেশনসহ একটি প্রাথমিক কনফিগারেশন তৈরি করতে চালান:
aibuildai config > task.yamlতৈরি ফাইলটিতে প্রতিটি কনফিগারেশন ফিল্ড, তার ডিফল্ট মান এবং ডকুমেন্টেশন রয়েছে। প্রয়োজনীয় শীর্ষ-স্তরের বিভাগগুলো হলো run, llm, work_units, search এবং resources; প্রাথমিক ফাইলে সেগুলো পূরণ করা থাকে।
রানটি চালু করুন:
aibuildai run task.yamlকমান্ডটি http://127.0.0.1:<port>/run/<run-id>-এর মতো একটি workspace URL দেখায়। রানটি সরাসরি অনুসরণ করতে এটি খুলুন। ব্রাউজার ঐচ্ছিক; ব্রাউজার ছাড়াও এক্সিকিউশন স্বাভাবিকভাবে চলতে থাকে।
GSM8K উদাহরণ চালান
অন্তর্ভুক্ত উদাহরণটি GSM8K-এর প্রাথমিক স্তরের গণিতের শব্দভিত্তিক সমস্যা সমাধানের জন্য Qwen/Qwen3-1.7B-Base-এর পোস্ট-ট্রেনিং করে। রিপোজিটরি অনুযায়ী, একটি GPU-তে এই উদাহরণ চালাতে প্রায় দুই ঘণ্টা লাগে।
১. টাস্ক ফোল্ডার তৈরি করুন
bash examples/gsm8k-qwen3-1.7b-base/setup.sh ~/gsm8k-exampleসেটআপটি প্রায় 4 GB ডাউনলোড করে, যার মধ্যে বেস মডেলের ওজন এবং GSM8K-এর উভয় split অন্তর্ভুক্ত। এটি ~/gsm8k-example/task/-এ টাস্ক স্টেটমেন্ট ও অপরিবর্তনীয় grader লেখে এবং রানটির নিজস্ব Program environment-এ ইনস্টল হওয়া প্যাকেজগুলোর জন্য pip cache উষ্ণ করে।
ফলস্বরূপ টাস্ক ফোল্ডারে থাকে এজেন্ট যে base weights টিউন করতে পারে, 7,473টি প্রশিক্ষণ সমস্যা, grader এবং সেই grader পড়া 1,319-সমস্যার test split।
২. পোস্ট-ট্রেনিং শুরু করুন
aibuildai run ~/gsm8k-example/task.yamlউদাহরণটি meta search, 90-মিনিটের exploration wall clock এবং সংশ্লিষ্ট per-agent budget ব্যবহার করে। গুরুতর রান হলে README এই budget বাড়ানোর পরামর্শ দেয়।
৩. গ্রেডিং চুক্তি বুঝুন
সাফল্যের সম্পূর্ণ সংজ্ঞা grader-এ রয়েছে। এটি একটি প্রশ্নের পর একটি answer prefix দিয়ে মডেলকে prompt করে, greedy decoding ব্যবহার করে এবং শেষ ####-এর পরের সংখ্যা বের করে। README জানায়, প্রথম 200টি test সমস্যায় base model-এর score 0.105, কারণ tune না করা base model শুরুতে প্রয়োজনীয় answer format অনুসরণ করে না।
৪. চূড়ান্ত মডেল মূল্যায়ন করুন
Deliverable হলো একটি merged model directory। তৈরি হওয়া run directory-এর নাম দিয়ে <run-home> প্রতিস্থাপন করুন এবং রানটির Program environment ব্যবহার করে সব test example মূল্যায়ন করুন:
H=~/gsm8k-example/playground/gsm8k-qwen3-1.7b-base/<run-home>
$H/program-environment/env/bin/python ~/gsm8k-example/task/grade/evaluate.py --model-path $H/deliverable/final_model --limit -1
নিজস্ব টাস্কে এজেন্ট ব্যবহার করুন
examples/gsm8k-qwen3-1.7b-base.yamlকপি করুন, অথবাaibuildai configদিয়ে সম্পূর্ণ প্রাথমিক কনফিগারেশন তৈরি করুন।- রানটি ব্যবহার করতে পারে এমন সবকিছু নিয়ে একটি টাস্ক ফোল্ডার তৈরি করুন।
- প্রয়োজনীয় প্রতিটি data file-এর সঙ্গে একটি পাঠযোগ্য টাস্কের বিবরণ, যেমন README, task statement বা paper, অন্তর্ভুক্ত করুন।
run.data_rootসেই ফোল্ডারে সেট করুন।- মডেল, search, budget, work-unit এবং resource সেটিংস পর্যালোচনা করুন।
aibuildai runদিয়ে YAML ফাইলটি চালু করুন।
সেটআপের সময় সিস্টেমটি পুরো টাস্ক ফোল্ডার পড়ে, statement-টিকে রানের README হিসেবে স্থির করে এবং তা থেকে রানের score program তৈরি করে। তাই টাস্ক ফোল্ডারটি সম্পূর্ণ হওয়া উচিত এবং প্রত্যাশিত deliverable ও মূল্যায়ন পদ্ধতি স্পষ্টভাবে নির্ধারণ করা উচিত।
কনফিগারেশনটি run.setup_from_scratch এবং run.task_prompt-ও সমর্থন করে। এই সেটিংসের মাধ্যমে প্রস্তুত টাস্ক ফোল্ডার দিয়ে শুরু না করে Setup একটি task statement থেকে data ও evaluation সংগ্রহ করতে পারে।
গুরুত্বপূর্ণ কনফিগারেশন নির্বাচন
মডেল নির্বাচন
llm.default.model এজেন্টদের ব্যবহৃত বেস মডেল নির্বাচন করে। effort এবং max_thinking_tokens-এর মতো সেটিংস দিয়ে রিজনিং সমন্বয় করা যায়। পৃথক ভূমিকায় মডেল নির্দিষ্ট করতে llm.by_role ব্যবহার করুন, অথবা ভূমিকাভেদে রাউটারকে মডেল বেছে নিতে দিতে llm.auto ব্যবহার করুন।
সার্চ পদ্ধতি
search.kind পরীক্ষার কৌশল নিয়ন্ত্রণ করে। README-তে বর্ণিত সমর্থিত মানগুলো হলো:
meta, যেখানে একটি মেটা এজেন্ট নির্দিষ্ট কাজের জন্য সার্চ প্রোগ্রাম লেখে।nb_tree, পুরো পরীক্ষাজুড়ে ট্রি সার্চ।nb।tree, সাধারণ স্টার্টারে ডিফল্ট মান।linear।parallel।
search.input-এর বিষয়বস্তু নির্বাচিত কৌশলের ওপর নির্ভর করে। মেটা সার্চে report অপশন গ্রহণ করা হয়, আর নির্দিষ্ট কৌশলগুলো নিজেদের প্যারামিটার ব্যবহার করে এবং এতে parallel ও early_stopping থাকতে পারে।
সময় ও ব্যয়ের সীমা
run.budget.wall_clock_minutes-এর ডিফল্ট মান ১,৪৪০ মিনিট। সীমায় পৌঁছালে নতুন কোনো অনুসন্ধান শুরু হয় না, তবে চলমান কাজ ও ডেলিভারি সম্পন্ন হতে দেওয়া হয়। run.budget.cost_usd রান-স্তরের ঐচ্ছিক নরম ব্যয়সীমা নির্ধারণ করে।
work_units-এর অধীনে থাকা প্রতিটি এন্ট্রির নিজস্ব বাজেট রয়েছে। একটি ওয়ার্ক ইউনিট নির্দিষ্ট মিনিট, গভীরতা অনুযায়ী স্কেল করা সময়, অথবা অতিরিক্ত সময়সহ প্রত্যাশিত সময়কাল ব্যবহার করতে পারে।
রিসোর্সের সীমা
প্রতিটি ওয়ার্ক ইউনিটে কঠোর CPU ও মেমরি সীমা আরোপ করতে resources.work_unit.cpu_max_cores এবং resources.work_unit.memory_max_gb ব্যবহার করুন। প্রতিটি ইউনিট মেমরি ও প্রসেসের ওপর cgroup সীমাসহ bubblewrap স্যান্ডবক্সে চলে, আর টাস্ক ফোল্ডারটি শুধু-পাঠযোগ্যভাবে মাউন্ট করা থাকে।
উন্নত টিপস
জ্ঞান পুনরুদ্ধার চালু করুন
এজেন্টদের AIBuildAI Knowledge Base পরামর্শ করতে দিতে kb MCP কনফিগারেশন যোগ করুন। ক্লায়েন্টটি স্কিল খোঁজা, কোনো স্কিল লোড করা এবং রেফারেন্স পড়ার সরঞ্জাম উন্মুক্ত করে। কর্পাসে ওয়ার্কফ্লো নির্দেশিকা, মেথডোলজি কার্ড, ডেটাসেট কার্ড এবং ফ্রেমওয়ার্ক কার্ড রয়েছে।
ডিফল্ট পাবলিক সার্ভিসটি একটি নির্দিষ্ট কর্পাস স্ন্যাপশট। নিজস্ব সংস্করণ হোস্ট করতে ওপেন-সোর্স knowledge-base রিপোজিটরি ডিপ্লয় করুন এবং AIBUILDAI_KB_BASE_URL সেট করে সেটির দিকে নির্দেশ করুন।
কাজ-নির্দিষ্ট টপোলজির জন্য মেটা সার্চ বেছে নিন
নির্দিষ্ট ট্রি সার্চ স্বাভাবিকভাবে প্রতিটি ওয়ার্কফ্লো প্রকাশ করতে পারে না, যেমন প্রশিক্ষণের আগে একটি সুইপ চালানো, পরে একটি টুর্নামেন্ট আয়োজন করা, অথবা একাধিক মডেল একত্র করা। search.kind: meta ব্যবহার করলে একটি মেটা এজেন্ট কাজটি বিশ্লেষণ করে, পাইলট চালাতে পারে, অন্তর্ভুক্ত ডিজাইন স্কিল ও knowledge base পরামর্শ করতে পারে এবং একটি Python সার্চ প্যাকেজ লিখতে পারে।
উৎপন্ন প্যাকেজটি তিনটি প্রিমিটিভ দিয়ে গঠিত:
- এজেন্ট: সরঞ্জাম, নীতি এবং টাইপ করা আউটপুটসহ একটি LLM সেশন।
- প্রোগ্রাম: নির্দিষ্ট রিসোর্স সীমাসহ পরিচালিত ওয়ার্কারে সম্পাদিত একটি নির্ধারিত গণনা।
- সার্চ: টাইপ করা ইনপুট ও আউটপুট ব্যবহার করে এজেন্ট, প্রোগ্রাম এবং নেস্টেড সার্চ তৈরি ও সমন্বয় করতে পারে এমন একটি অর্কেস্ট্রেটর।
প্যাকেজটি যাচাই করা হয় এবং চাইলে LaTeX ডিজাইন রিপোর্ট দিয়ে পর্যালোচনা করা যায়। এরপর এটি একই জার্নালভুক্ত রানে একটি চাইল্ড সার্চ হিসেবে চলে। টপোলজি যাই হোক, রানের মূল্য যেকোনো নোডের অর্জিত সেরা স্কোরই নির্ধারণ করে।
পুনর্ব্যবহারযোগ্য স্থানীয় মেমরি তৈরি করুন
কোনো কাজের জন্য একাধিক রান জমা হলে, সেগুলোর শিক্ষা একটি সম্পাদনাযোগ্য স্থানীয় মেমরি নথিতে একত্র করুন:
aibuildai memorize task.yamlপ্রতিটি এজেন্টে সেই স্থানীয় মেমরি যুক্ত করতে memory.enable সেট করুন। আপনার রান থেকে শেখা জ্ঞান আপনার মেশিনেই থাকে এবং দূরবর্তী knowledge base-এ যোগ হয় না।
বাহ্যিক সরঞ্জাম নিয়ন্ত্রণ করুন
প্রতিটি ভূমিকাকে নির্বাচিত বিল্ট-ইন সরঞ্জাম ব্যবহার করা থেকে বিরত রাখতে disallowed_tools ব্যবহার করুন। উদাহরণস্বরূপ, মূল্যায়নের নিয়মে অফলাইন ওয়ার্কফ্লো প্রয়োজন হলে কোনো কাজ WebSearch এবং WebFetch নিষিদ্ধ করতে পারে।
MCP ইন্টিগ্রেশন যোগ করুন
mcps কনফিগারেশন knowledge base, Kaggle প্রতিযোগিতায় সাবমিশন অথবা কাস্টম MCP সার্ভার চালু করতে পারে। Kaggle ইন্টিগ্রেশন submission.max_submissions-এর অধীনে সর্বোচ্চ সাবমিশন নির্ধারণ সমর্থন করে।
একটি পেপার তৈরি করুন
অ্যাগ্রিগেশনের পর একটি পেপারের খসড়া তৈরি করতে writer.enable চালু করুন, অথবা সম্পন্ন রানের ডিরেক্টরিতে পেপার কমান্ড চালান:
aibuildai write-paper <run-dir>কমান্ডটি সম্পন্ন রান থেকে একটি পেপারের খসড়া তৈরি করে এবং সেটিকে PDF-এ কম্পাইল করে।
সোর্স পরিবর্তন যাচাই করুন
এই প্রকল্প লাইনে কোনো টেস্ট স্যুট নেই। রিপোজিটরির গেট হলো:
./check.shগেটটি pyright, ruff, semgrep এবং লক-ফাইলের পরিবর্তন যাচাই চালায়। এটি ব্যবহারের আগে requirements-dev.lock ইনস্টল করুন।
রানের আউটপুট বুঝুন
প্রতিটি রান কনফিগার করা playground root-এর অধীনে একটি হোম ডিরেক্টরি তৈরি করে:
{playground_root}/<task-name>/<timestamp>_<run-id>/
  run_config.json
  public/
  private/
  deliverable/
  workspace/
  program-environment/
resource_samples.jsonlrun_config.json-এ পুনরায় চালুর জন্য ব্যবহৃত চূড়ান্ত কনফিগারেশন ও রান ID থাকে।public/-এ প্রার্থীদের জন্য Setup প্রস্তুত করা স্থির README ও ডেটা থাকে।private/-এ স্কোর প্রোগ্রাম, মেট্রিক ম্যানিফেস্ট, বেসলাইন প্রচেষ্টা এবং বিজয়ীর রেকর্ড থাকে।deliverable/-এ চালানো যায় এমন মডেল প্যাকেজ বা কাজ-নির্ধারিত অন্য ফলাফল থাকে।workspace/-এ প্রচেষ্টা, আর্টিফ্যাক্ট, অস্থায়ী ডেটা এবং প্রতিটি সার্চের কাজের ডিরেক্টরি থাকে।program-environment/-এ রানের বিচ্ছিন্ন Program পরিবেশ থাকে।resource_samples.jsonl-এ সম্পাদনের সময় সংগৃহীত হোস্ট রিসোর্স পরিমাপের রেকর্ড থাকে।
উপসংহার
AIBuildAI LLM-Post-Train Agent মডেল পোস্ট-ট্রেনিং ওয়ার্কফ্লো ডিজাইন, চালানো, মূল্যায়ন এবং পরিমার্জনের জন্য একটি শুরু থেকে শেষ পর্যন্ত সিস্টেম প্রদান করে। ইনস্টলেশন যাচাই করতে এবং রান কাঠামো শিখতে সরবরাহকৃত GSM8K উদাহরণ দিয়ে শুরু করুন। এরপর একটি স্পষ্ট টাস্ক ফোল্ডার ও গ্রেডার নির্ধারণ করুন, উপযুক্ত সার্চ কৌশল নির্বাচন করুন, বাস্তবসম্মত বাজেট ও রিসোর্স সীমা সেট করুন এবং ফলস্বরূপ পরীক্ষাগুলো অনুসরণ করতে লাইভ ওয়ার্কস্পেস ব্যবহার করুন।
আরও গভীর আর্কিটেকচার-সংক্রান্ত তথ্যের জন্য রিপোজিটরির আর্কিটেকচার ডকুমেন্টেশন দেখুন। প্রকল্পটি Apache License 2.0-এর অধীনে বিতরণ করা হয়।