

NamiGPT কী
NamiGPT হলো চীনা ভাষার শিক্ষানবিশদের জন্য তৈরি একটি বড় ভাষা মডেলভিত্তিক মৌলিক টিউটোরিয়াল। এটি PyTorch ব্যবহার করে শূন্য থেকে GPT-2 বাস্তবায়ন করে, প্রস্তুত Transformer মডিউল ব্যবহার না করেই, এবং OpenAI-এর সরকারি প্রাক-প্রশিক্ষিত ওজন লোড করে ইনফারেন্স ও টেক্সট জেনারেশন সম্পন্ন করতে পারে।
প্রকল্পটির প্রধান লক্ষ্য প্রশিক্ষণের দক্ষতা নয়, বরং বোঝাপড়া: মূল মডেলটি gpt2/model.py-এ রয়েছে এবং কোড 200 লাইনেরও কম; টিউটোরিয়ালটি “বিড়াল মাছ খায়” এই তিন-শব্দের উদাহরণ ধরে টোকেনাইজেশন, ভেক্টর, অ্যাটেনশন ম্যাট্রিক্স এবং চূড়ান্ত জেনারেশন প্রক্রিয়াকে ধাপে ধাপে ব্যাখ্যা করে।
NamiGPT নামটি Karpathy-এর nanoGPT-এর প্রতি শ্রদ্ধা জানায়। এটি চীনা ভাষায় শূন্য-ভিত্তির শিক্ষাদানে বেশি গুরুত্ব দেয় এবং ক্ষুদ্র উদাহরণের মাধ্যমে GPT-2-এর প্রতিটি ধাপ ব্যাখ্যা করে।
আপনি যা শিখবেন
- Tokenizer কীভাবে টেক্সটকে token ID-তে রূপান্তর করে।
- Embedding ও positional encoding কীভাবে মডেলের ইনপুট তৈরি করে।
- Self-Attention এবং Multi-Head Attention কীভাবে গণনা করা হয়।
- Residual connection, LayerNorm, FFN এবং activation function-এর পৃথক ভূমিকা কী।
- একাধিক Transformer Block কীভাবে স্তরে স্তরে সাজিয়ে GPT-2 তৈরি করা হয়।
- OpenAI-এর সরকারি ওজন কীভাবে হাতে লেখা মডেলে লোড করা যায়।
- Greedy, temperature এবং top-k কৌশল ব্যবহার করে কীভাবে টেক্সট জেনারেট করা যায়।
- পরীক্ষার মাধ্যমে হাতে লেখা বাস্তবায়নটি HuggingFace বাস্তবায়নের সঙ্গে সামঞ্জস্যপূর্ণ কি না কীভাবে যাচাই করা যায়।
প্রকল্পের প্রধান বৈশিষ্ট্য
মূল কম্পোনেন্ট শূন্য থেকে বাস্তবায়ন
NamiGPT সরাসরি কোনো প্রস্তুত Transformer মডিউল ব্যবহার করে না। মডেলের মধ্যে LayerNorm, Attention, FFN, Block এবং GPT-এর মতো কম্পোনেন্ট রয়েছে, তাই ডেটা ও টেনসর কীভাবে প্রবাহিত হয় তা লাইন ধরে পড়া যায়।
অধ্যায়ের স্ক্রিপ্ট আলাদাভাবে চালানো যায়
ইনফারেন্স অংশটি ধারাবাহিকভাবে এগোনো 15টি বিষয় নিয়ে গঠিত, যার মধ্যে রয়েছে tokenizer, Embedding, positional encoding, self-attention, multi-head attention, residual connection, layer normalization, feed-forward network, activation function, Transformer Block, stacking, weight loading, text generation এবং interpretability। প্রতিটি শিক্ষামূলক বিষয়ের সঙ্গে একটি সংশ্লিষ্ট চালানো যায় এমন স্ক্রিপ্ট রয়েছে।
ইন্টার্যাক্টিভ ভিজ্যুয়ালাইজেশন
প্রকল্পটি Transformer architecture-এর অ্যানিমেটেড ডায়াগ্রাম এবং সম্পূর্ণ inference matrix-এর ভিজ্যুয়ালাইজেশন সরবরাহ করে। কোড বা সূত্র বোঝা কঠিন হলে “বিড়াল মাছ খায়” উদাহরণের ম্যাট্রিক্সের উপাদানগুলো কীভাবে একে একে গণনা হয় তা দেখা যায়।
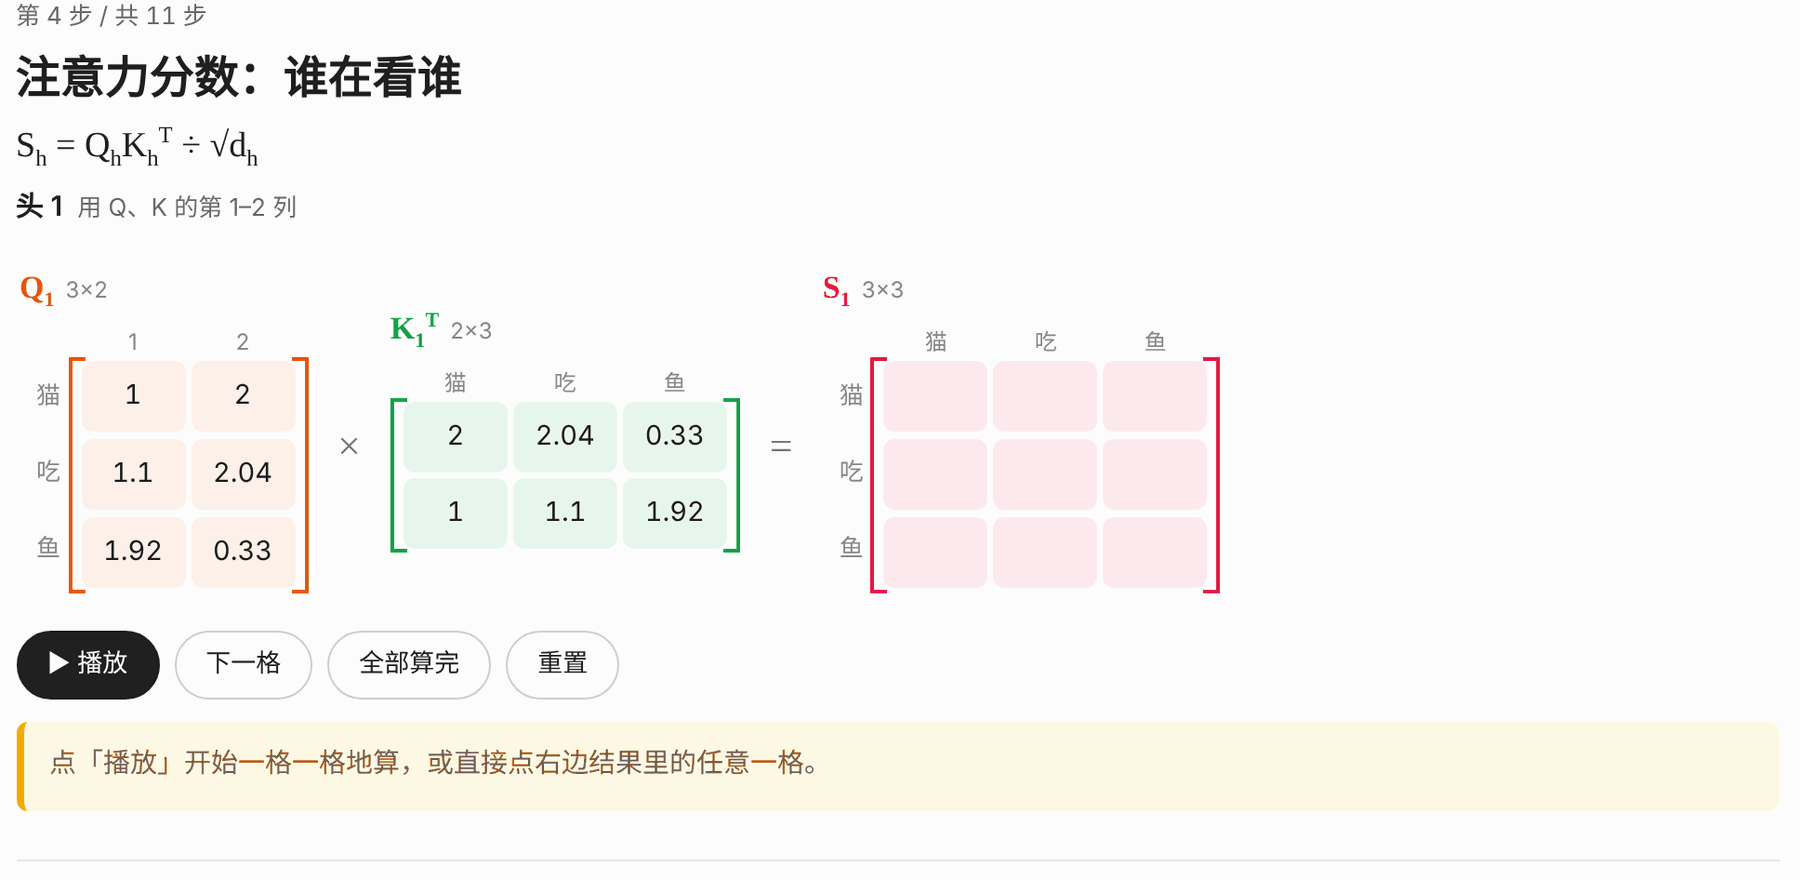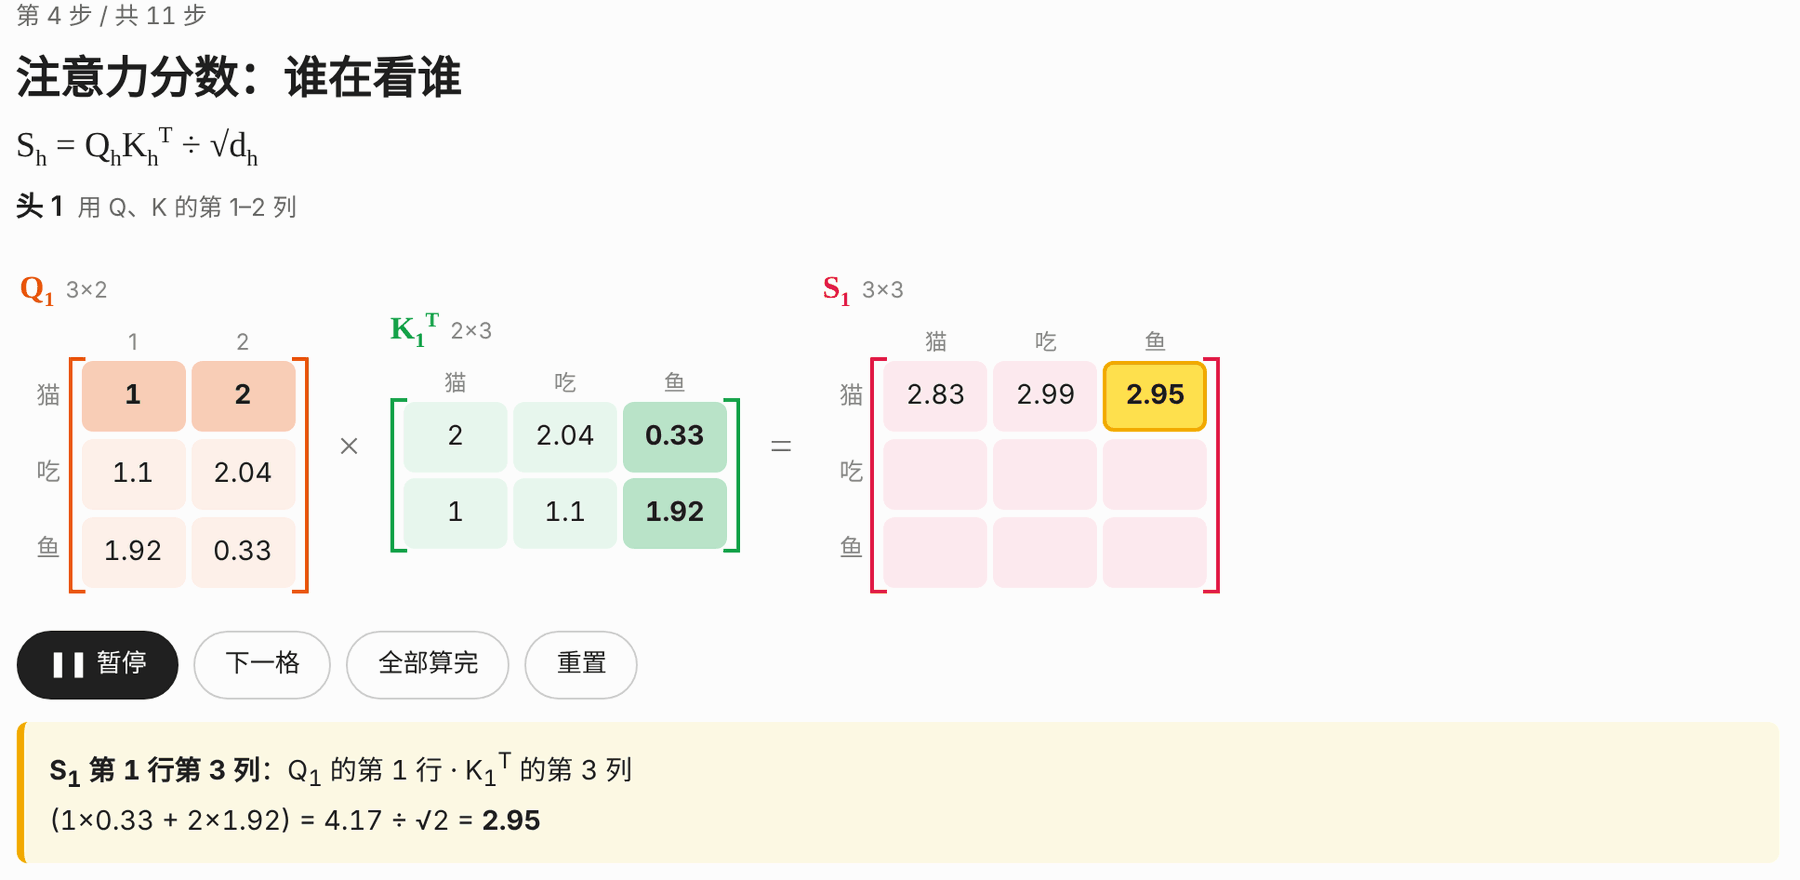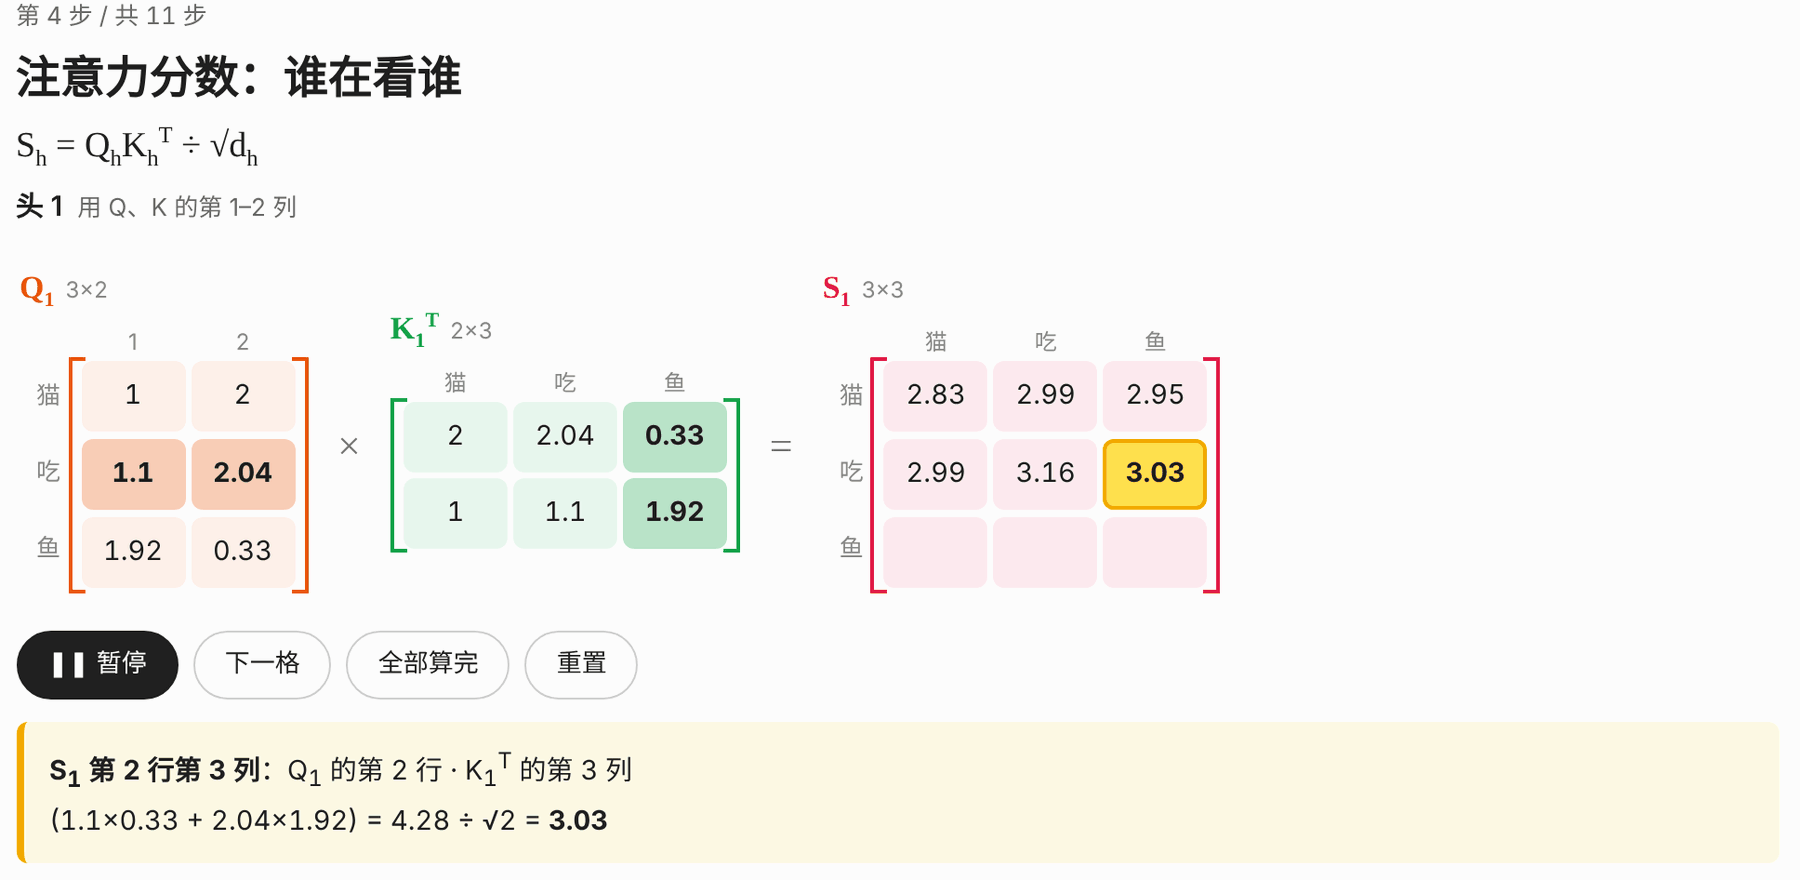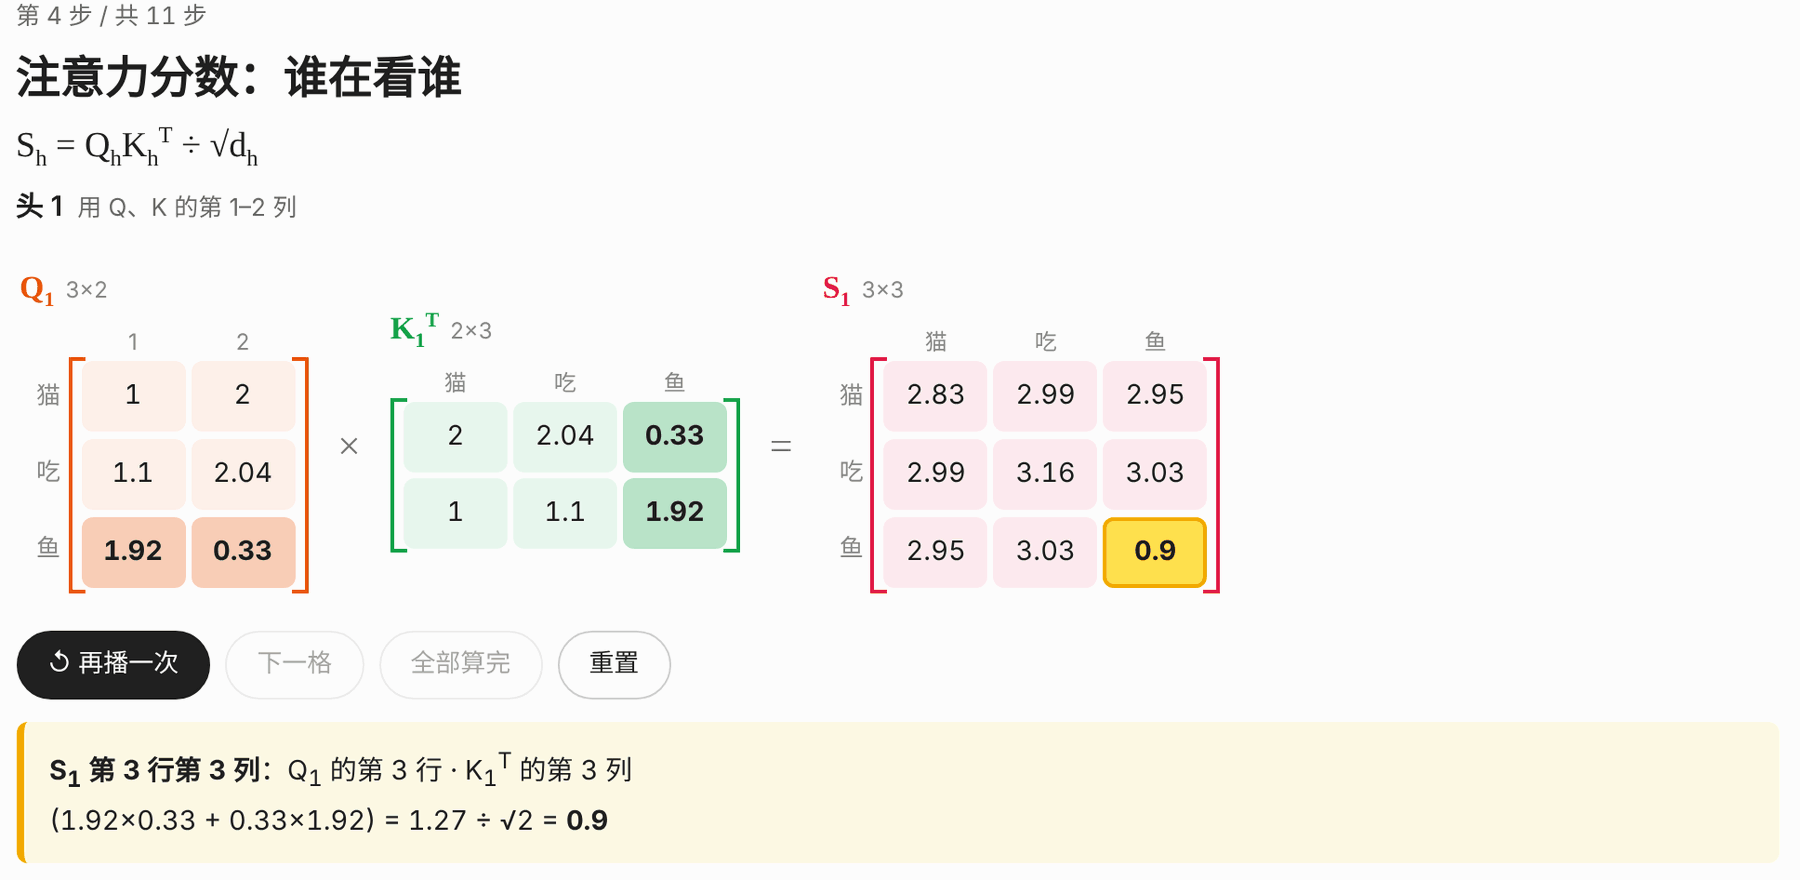
প্রথমে একটি ছবিতে Transformer বোঝা দেখুন, তারপর অধ্যায়ের কোডের সঙ্গে মিলিয়ে দেখতে বড় ভাষা মডেলের ইনফারেন্স ভিজ্যুয়ালাইজেশন ব্যবহার করুন।
HuggingFace ফলাফলের সঙ্গে সামঞ্জস্য
রিপোজিটরিতে shape check এবং HuggingFace-এর সরকারি বাস্তবায়নের সঙ্গে সামঞ্জস্য যাচাইয়ের পরীক্ষা রয়েছে। এলোমেলো ওজন ব্যবহার করে দ্রুত তুলনা করার পাশাপাশি, অতিরিক্ত যাচাইয়ের জন্য প্রকৃত GPT-2 ওজনও ডাউনলোড করা যায়।
ইনস্টলেশনের আগে প্রস্তুতি
শুরু করার আগে প্রাথমিক Python কোড পড়ার সক্ষমতা এবং matrix multiplication-এর মতো মৌলিক linear algebra ধারণা থাকা প্রয়োজন। প্রকল্পে নির্ধারিত রানটাইম পরিবেশ হলো Python 3.9 বা তার পরের সংস্করণ এবং PyTorch 2.x।
প্রথমে রিপোজিটরি ক্লোন করে প্রকল্প ডিরেক্টরিতে প্রবেশ করুন এবং নির্ভরতা ইনস্টল করুন:
git clone https://github.com/aa1143/NamiGPT.git
cd NamiGPT
pip install -r requirements.txt
HuggingFace থেকে সরকারি ওজন ডাউনলোড করার সময় নেটওয়ার্ক সীমাবদ্ধতা থাকলে, বর্তমান টার্মিনালে একটি mirror address সেট করতে পারেন:
export HF_ENDPOINT=https://hf-mirror.comএই mirror কেবল সরকারি ওজন ডাউনলোডের জন্য ব্যবহৃত হয়। পরে from_pretrained কল করলেও মডেলের কাঠামো NamiGPT-এর হাতে লেখা বাস্তবায়ন থেকেই আসবে।
প্রথম ধাপ: অধ্যায় ধরে GPT-2 বোঝা
শিক্ষানবিশদের জন্য সবচেয়ে উপযোগী পদ্ধতি হলো সঙ্গে সঙ্গে সম্পূর্ণ মডেল না পড়ে inference data flow অনুসরণ করে অধ্যায় ধরে শেখা:
- ইনপুট ধাপ: প্রথমে Tokenizer, Embedding এবং positional encoding আয়ত্ত করুন।
- অ্যাটেনশন ধাপ: Self-Attention বুঝে Multi-Head Attention-এ এগিয়ে যান।
- মডিউল ধাপ: residual connection, LayerNorm, FFN এবং activation function শিখুন।
- মডেল ধাপ: কম্পোনেন্টগুলো একত্র করে Transformer Block তৈরি করুন এবং স্তরে স্তরে সাজিয়ে সম্পূর্ণ GPT-2 বানান।
- প্রয়োগ ধাপ: সরকারি ওজন লোড করুন, টেক্সট জেনারেট করুন এবং interpretability-এর ফলাফল দেখুন।
প্রতিটি স্ক্রিপ্ট আলাদাভাবে চালানো যায়। উদাহরণস্বরূপ, multi-head attention অধ্যায় চালাতে:
python chapters/01-inference/ep06_multi_head_attention.pyসম্পূর্ণ চিত্রসহ লেখা NamiGPT চিত্রভিত্তিক টিউটোরিয়াল-এ দেখা যাবে; রিপোজিটরির মূল খসড়া রয়েছে docs/01-inference/-এ।
দ্বিতীয় ধাপ: GPT-2 লোড করে টেক্সট জেনারেট করা
ইনস্টলেশন সম্পন্ন হলে NamiGPT-এর দেওয়া মডেল লোডিং ও জেনারেশন ইন্টারফেস সরাসরি ইমপোর্ট করা যায়। নিচের উদাহরণে GPT-2 tokenizer ব্যবহার করে ইংরেজি prompt-কে token ID-তে এনকোড করা হয়, তারপর হাতে লেখা মডেল ও সরকারি 124M ওজন লোড করা হয়:
import tiktoken, torch
from gpt2 import from_pretrained, generate

enc = tiktoken.get_encoding("gpt2")
model = from_pretrained("gpt2")

ids = torch.tensor([enc.encode("The cat sat on the")])
out = generate(
    model,
    ids,
    max_new_tokens=30,
    temperature=0.8,
    top_k=50,
)
print(enc.decode(out[0].tolist()))
কোড সম্পাদনের ধাপ
tiktoken.get_encoding("gpt2")GPT-2-এ ব্যবহৃত encoder সংগ্রহ করে।enc.encode(...)prompt টেক্সটকে token ID-তে রূপান্তর করে।torch.tensorID-গুলোকে মডেলের প্রয়োজনীয় batch tensor-এ আবদ্ধ করে।from_pretrained("gpt2")হাতে লেখা GPT-2 তৈরি করে এবং সরকারি 124M ওজন লোড করে।generateprompt টেক্সটের পরে সর্বোচ্চ 30টি নতুন token জেনারেট করে।enc.decodeআউটপুট token ID-কে আবার টেক্সটে রূপান্তর করে।
সতর্কতা: GPT-2 কথোপকথনের জন্য fine-tune করা নয়। এটি প্রশ্নের উত্তর দেওয়ার চেয়ে বিদ্যমান বিষয়বস্তুর ধারাবাহিকতা লিখতে বেশি দক্ষ। এর প্রশিক্ষণ ডেটা মূলত ইংরেজিভিত্তিক, তাই শুরুতে ইংরেজি prompt ব্যবহার করার পরামর্শ দেওয়া হয়।
তৃতীয় ধাপ: জেনারেশন প্যারামিটার বোঝা
উদাহরণটিতে দুটি গুরুত্বপূর্ণ sampling parameter ব্যবহার করা হয়েছে:
temperature=0.8: সম্ভাব্য token-গুলোর probability distribution সামঞ্জস্য করতে ব্যবহৃত হয়। প্রকল্পের generation module temperature strategy সমর্থন করে।top_k=50: কেবল সম্ভাবনা বেশি এমন প্রথম 50টি সম্ভাব্য token থেকে নির্বাচন করে। প্রকল্পটি greedy generation এবং top-k generation দুটিই সমর্থন করে।
শেখার সময় prompt টেক্সট অপরিবর্তিত রেখে শুধু temperature বা top-k পরিবর্তন করে continuation-এর ফলাফল তুলনা করতে পারেন। এতে generation strategy কীভাবে output-কে প্রভাবিত করে তা সরাসরি দেখা যায়, তবে নির্দিষ্ট parameter আপনার পরীক্ষার লক্ষ্য অনুযায়ী নির্বাচন করা উচিত।
চতুর্থ ধাপ: Gradio ওয়েব ডেমো চালু করা
ব্রাউজারে prompt লিখে continuation-এর ফলাফল এবং প্রতিটি ধাপে সম্ভাব্য শব্দের probability দেখতে চাইলে Gradio ইনস্টল করে রিপোজিটরির demo program চালাতে পারেন:
pip install gradio
python demo/app.py
ওয়েব ডেমো মডেলের প্রতিটি ধাপের prediction পর্যবেক্ষণের জন্য উপযোগী, আর অধ্যায়ের স্ক্রিপ্ট পৃথক কম্পোনেন্টের গণনাপ্রক্রিয়া বোঝার জন্য বেশি উপযোগী। দুটিকে একসঙ্গে ব্যবহার করলে চূড়ান্ত টেক্সটের সঙ্গে অভ্যন্তরীণ probability পরিবর্তনের সম্পর্ক দেখা যায়।
পঞ্চম ধাপ: পরীক্ষা চালানো
attention, weight loading বা generation logic পরিবর্তনের পর পরীক্ষা চালানোর পরামর্শ দেওয়া হয়। ডিফল্ট পরীক্ষায় এলোমেলো ওজন ব্যবহার করে তুলনা করা হয়, তাই pretrained model ডাউনলোডের প্রয়োজন নেই এবং সাধারণত দ্রুত শেষ হয়:
pytest tests/ -vপ্রকৃত GPT-2 ওজন ব্যবহার করে অতিরিক্ত সামঞ্জস্য পরীক্ষা করতে চাইলে চালান:
TEST_PRETRAINED=1 pytest tests/ -vদ্বিতীয় কমান্ডটি অতিরিক্তভাবে প্রকৃত ওজন ডাউনলোড করবে, তাই প্রথমবার চালানোর সময় ডাউনলোড শেষ হওয়া পর্যন্ত অপেক্ষা করতে হবে।
রিপোজিটরির কাঠামো এক নজরে
gpt2/config.py: মডেল কনফিগারেশন; এতে 124M, 355M, 774M এবং 1.5B specification রয়েছে।gpt2/model.py: LayerNorm, Attention, FFN, Block এবং GPT মডেলের মূল কাঠামো।gpt2/load_weights.py: সরকারি ওজন হাতে লেখা মডেলে লোড করে।gpt2/generate.py: greedy, temperature এবং top-k generation logic।chapters/01-inference/: প্রতিটি টিউটোরিয়াল অধ্যায়ের সংশ্লিষ্ট demo script।docs/01-inference/: টিউটোরিয়াল প্রবন্ধের মূল খসড়া।demo/app.py: Gradio ওয়েব ডেমো।tests/: shape check এবং HuggingFace সামঞ্জস্য পরীক্ষা।
উন্নত কৌশল: HuggingFace-এর সঙ্গে সামঞ্জস্যের 3টি গুরুত্বপূর্ণ বিষয়
1. Causal mask সঠিকভাবে প্রয়োগ করা
GPT-2 একটি autoregressive language model। sequence-এর প্রতিটি শব্দ কেবল নিজেকে এবং তার আগের শব্দগুলো পড়তে পারে; পরের token আগে থেকে দেখতে পারে না। causal mask বাদ পড়লে সরকারি ওজন সফলভাবে লোড করলেও মডেলের output ভুল হবে।
2. ওজন স্থানান্তরের সময় transpose পরিচালনা করা
GPT-2-এর মূল বাস্তবায়নে Conv1D ব্যবহার করা হয় এবং এর weight shape হলো [in, out]; PyTorch-এর nn.Linear ব্যবহার করে [out, in]। তাই সরকারি parameter হাতে লেখা linear layer-এ লোড করার সময় অবশ্যই transpose করতে হবে।
এছাড়াও c_attn Query, Key এবং Value-এর parameter একসঙ্গে জুড়ে দেয়। হাতে লেখা বাস্তবায়নের সঙ্গে সামঞ্জস্য করতে হলে আগে এগুলোকে সংশ্লিষ্ট 3টি অংশে ভাগ করে সঠিক স্থানে বসাতে হবে।
3. tanh-ভিত্তিক GELU approximation ব্যবহার করা
GPT-2 GELU-এর tanh approximation version ব্যবহার করে, আর PyTorch-এর nn.GELU() ডিফল্টভাবে exact version ব্যবহার করে। একে একে সামঞ্জস্য করতে হলে সেট করুন:
nn.GELU(approximate="tanh")এই 3টি বিষয় দেখতে ছোট হলেও হাতে লেখা মডেলটি সরকারি বাস্তবায়নের ফলাফল পুনরুৎপাদন করতে পারবে কি না, তাতে সরাসরি প্রভাব ফেলে। ত্রুটি শনাক্ত করার সময় mask, parameter shape এবং activation function version পরপর পরীক্ষা করতে পারেন।
প্রস্তাবিত শেখা ও debugging পদ্ধতি
- প্রথমে architecture animation-এর মাধ্যমে বুঝুন যে GPT-2 কেবল Transformer decoder অংশ ব্যবহার করে।
- বর্তমান অধ্যায়ের script চালিয়ে input, output এবং মধ্যবর্তী tensor-এর shape নথিবদ্ধ করুন।
- attention matrix বোঝা কঠিন হলে অনলাইন matrix visualization-এর সঙ্গে মিলিয়ে প্রতিটি ঘর পরীক্ষা করুন।
- কোনো একটি component শেষ করার পর
gpt2/model.py-এর সংশ্লিষ্ট implementation পড়ুন। - implementation পরিবর্তনের পর প্রথমে random weight test চালান, তারপর প্রয়োজনে real weight test চালান।
- সবশেষে text generation example এবং Gradio page ব্যবহার করে সম্পূর্ণ মডেলের আচরণ পর্যবেক্ষণ করুন।
এই ক্রম architecture diagram, matrix calculation, অধ্যায়ের code, সম্পূর্ণ model এবং final output-কে একসূত্রে যুক্ত করে; ফলে শুরুতেই সম্পূর্ণ GPT-2-এর বহুস্তরীয় কাঠামোতে বিভ্রান্ত হতে হয় না।
সারসংক্ষেপ
NamiGPT মৌলিক ম্যাট্রিক্স গণনা থেকে সম্পূর্ণ GPT-2 ইনফারেন্স পর্যন্ত একটি শেখার পথ প্রদান করে। আপনি প্রথমে প্রতিটি উপাদান বোঝার জন্য স্বতন্ত্র অধ্যায়ের স্ক্রিপ্ট চালাতে পারেন, তারপর OpenAI-এর অফিসিয়াল ওজন লোড করে ইংরেজি পাঠ্য সম্পূর্ণ করতে পারেন, এবং শেষে ভিজ্যুয়ালাইজেশন ও HuggingFace সামঞ্জস্য পরীক্ষা ব্যবহার করে নিজের বোঝাপড়া ও পরিবর্তন যাচাই করতে পারেন।
প্রকল্পের কোড MIT লাইসেন্সের অধীনে প্রকাশিত; docs/ ডিরেক্টরির নিবন্ধগুলো CC BY-NC 4.0 লাইসেন্সের অধীনে প্রকাশিত, পুনঃপ্রকাশের সময় উৎস উল্লেখ করতে হবে এবং বাণিজ্যিক ব্যবহার নিষিদ্ধ।