
LLaMA Factory (বর্তমানে LlamaFactory নামে পরিচিত) বৃহৎ ভাষা মডেলের জন্য একটি সমন্বিত ফাইন-টিউনিং ফ্রেমওয়ার্ক। প্রকল্পটি বেইহাং বিশ্ববিদ্যালয়ের ড. ঝেং ইয়াওয়েইয়ের দল শুরু করে এবং ACL 2024-এর গবেষণাপত্র এর একাডেমিক ভিত্তি প্রদান করে। ফ্রেমওয়ার্কটি “জিরো-কোড CLI + Web UI” নকশা অনুসরণ করে, যার লক্ষ্য ফাইন-টিউনিং প্রক্রিয়া সহজ করা। GitHub-এ LlamaFactory মোট 72 000-এর বেশি Stars পেয়েছে এবং বৃহৎ মডেল ফাইন-টিউনিং ক্ষেত্রে একটি রেফারেন্স বাস্তবায়নে পরিণত হয়েছে।
>
১. প্রকল্পের সারসংক্ষেপ
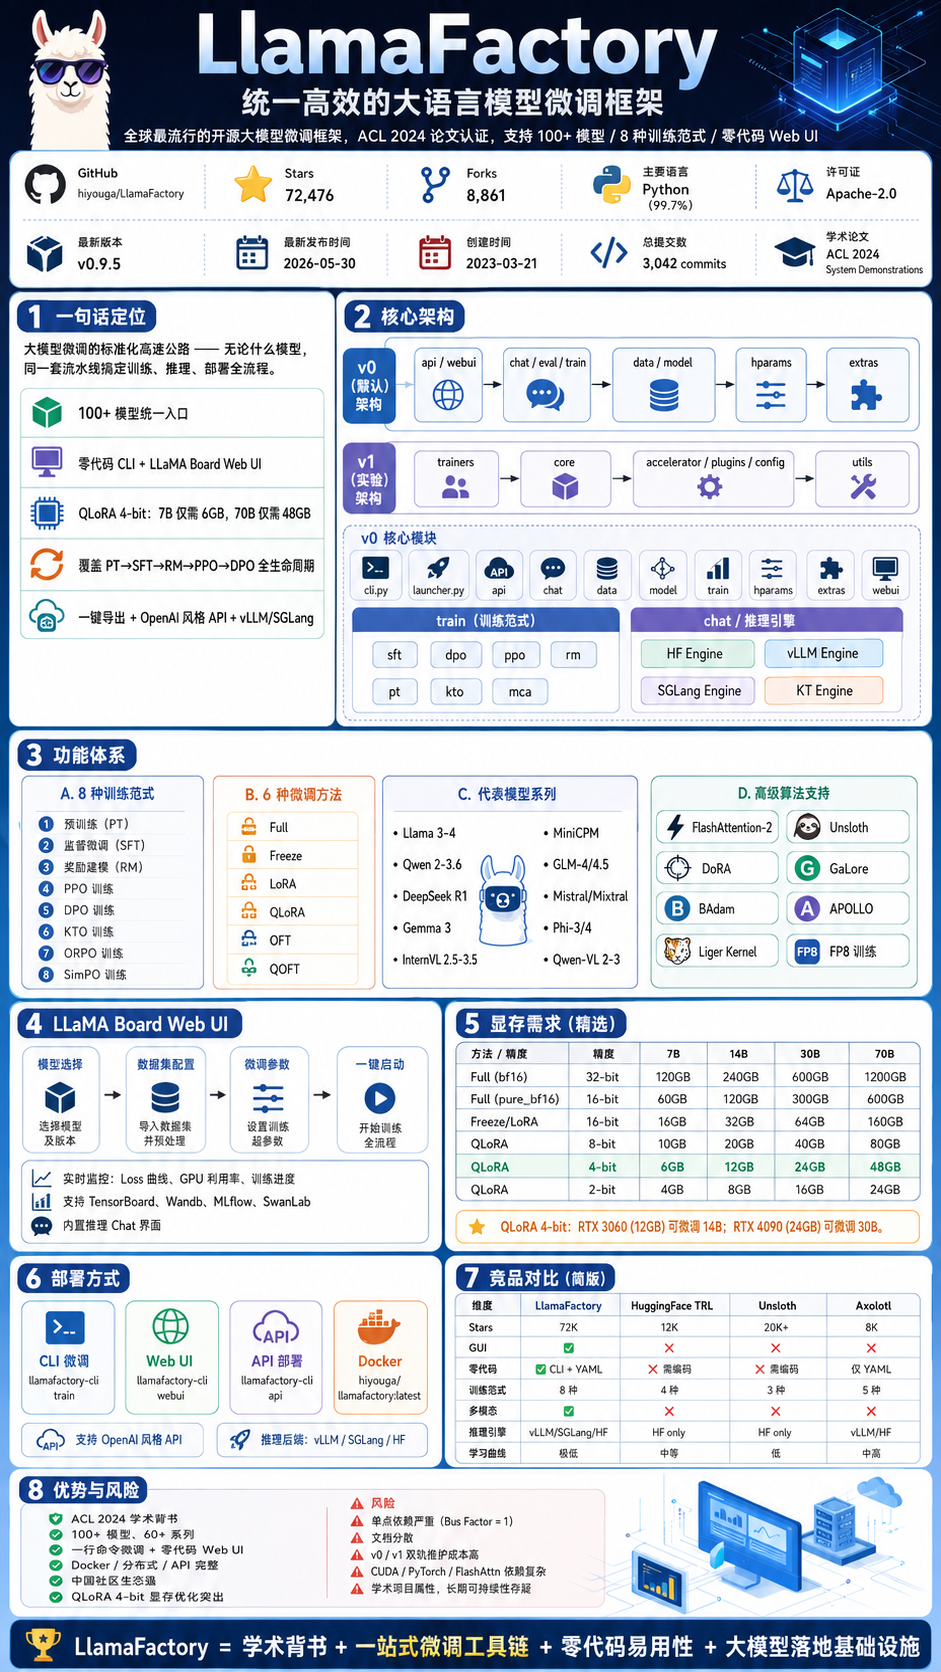
মাত্রা|বিস্তারিত
প্রকল্পের পূর্ণ নাম|LlamaFactory (পূর্বনাম LLaMA-Factory)
GitHub ঠিকানা|github.com/hiyouga/LlamaFactory
Stars|72,476 ⭐
Forks|8,861
প্রধান ভাষা|Python (99.7%)
লাইসেন্স|Apache-2.0
তৈরির তারিখ|2023-03-21
সর্বশেষ সংস্করণ|v0.9.5 (2026-05-30)
মোট কমিট|3,042 commits
মূল অবদানকারী|hiyouga (ঝেং ইয়াওয়েই, 2,188 commits, মোট কমিটের 72%)
একাডেমিক গবেষণাপত্র|ACL 2024 System Demonstrations
রিপোজিটরির আকার|~412.9 MB
Open Issues|57
প্রতিষ্ঠাতা ঝেং ইয়াওয়েই (hiyouga) বেইহাং বিশ্ববিদ্যালয়ের একজন পিএইচডি শিক্ষার্থী। তিনি প্রথম লেখক হিসেবে ACL, CVPR, WWW-সহ একাধিক আন্তর্জাতিক শীর্ষ সম্মেলনে গবেষণাপত্র প্রকাশ করেছেন এবং AAAI, EMNLP-সহ বিভিন্ন সম্মেলনে পর্যালোচক হিসেবে দায়িত্ব পালন করেছেন। তাঁর পুরস্কারের মধ্যে রয়েছে হুয়াওয়ে কাপ, ব্লু ব্রিজ কাপের জাতীয় প্রথম পুরস্কার, বেইহাং বিশ্ববিদ্যালয়ের বর্ষসেরা শিক্ষার্থী এবং Ascend ইকোসিস্টেম ওপেন সোর্স অসাধারণ অবদান পুরস্কার। সহযোগী দলের সদস্যদের মধ্যে রয়েছেন বেইহাং বিশ্ববিদ্যালয়ের অধ্যাপক ঝাং রিচং, ঝাং জুনহাও, ইয়েং ইয়ানহান, লুও ঝেয়ান, ফেং ঝাংচি, মা ইয়ংচিয়াং প্রমুখ।
২. প্রকল্পের অবস্থান ও মূল মূল্য
2.1 এক বাক্যে অবস্থান
মানসম্মত বৃহৎ মডেল ফাইন-টিউনিং পাইপলাইন: যেকোনো মডেলের জন্য একীভূত প্রক্রিয়া, যাতে ডেটা প্রস্তুতি, মডেল প্রশিক্ষণ, ইনফারেন্স যাচাই এবং ডিপ্লয়মেন্টসহ সম্পূর্ণ কার্যপ্রবাহ অন্তর্ভুক্ত।
2.2 সমাধান করা মূল সমস্যাগুলো
সমস্যা|LLaMA Factory-এর সমাধান
বিভিন্ন মডেলের ফাইন-টিউনিং প্রক্রিয়া আলাদা, পরিবর্তনের খরচ বেশি|অ্যালগরিদম-মডেল-ডেটা “ডিকাপলিং” নকশা, 100+ মডেলের জন্য একীভূত প্রবেশপথ
ফাইন-টিউনিং কোডের প্রবেশ-সীমা বেশি, গভীর শিক্ষার পটভূমি প্রয়োজন|জিরো-কোড CLI + LLaMA Board Web UI (Gradio)
ভিডিও মেমরি কম, ভোক্তা-শ্রেণির GPU-তে বৃহৎ মডেল প্রশিক্ষণ সম্ভব নয়|QLoRA 4-bit: 7B-এর জন্য মাত্র 6GB, 70B-এর জন্য মাত্র 48GB
ওপেন সোর্স কমিউনিটিতে এক-জায়গার টুলচেইনের অভাব|PT→SFT→RM→PPO→DPO সম্পূর্ণ জীবনচক্রে সমর্থন
ইনফারেন্স ডিপ্লয়মেন্ট জটিল|এক-ক্লিক এক্সপোর্ট + OpenAI-ধাঁচের API + vLLM/SGLang
2.3 নকশার দর্শন: অ্যালগরিদম-মডেল-ডেটা “ডিকাপলিং”
একটি সাক্ষাৎকারে ঝেং ইয়াওয়েই মডেল ইনফারেন্স প্রক্রিয়াকে মানসম্মত মহাসড়কে চলা গাড়ির সঙ্গে তুলনা করেন। মডেল নিজেই বিভিন্ন ধরনের গাড়ির সমতুল্য, আর ডেটা হলো গাড়িতে বহন করা পণ্যের সমতুল্য। মডেল যতক্ষণ এই মহাসড়কে সঠিকভাবে চলতে পারে, ফাইন-টিউনিং প্রক্রিয়া কেবল প্যারামিটার সমন্বয়ের মাধ্যমে সম্পন্ন করা যায়।
৩. প্রযুক্তিগত স্থাপত্যের গভীর বিশ্লেষণ
3.1 দ্বৈত স্থাপত্যের সমান্তরাল নকশা
LLaMA Factory একই সঙ্গে v0 (স্থিতিশীল সংস্করণ) এবং v1 (পরীক্ষামূলক সংস্করণ) নামে দুটি স্থাপত্য প্রদান করে। পরিবেশ ভেরিয়েবল USE_V1 সেট করে দুটির মধ্যে পরিবর্তন করা যায়।
v0 (ডিফল্ট): api/webui → chat/eval/train → data/model → hparams → extras
v1 (পরীক্ষামূলক): trainers → core → accelerator/plugins/config → utils
v0 স্থাপত্যটি বর্তমানে প্রধান বাস্তবায়ন। এতে সম্পূর্ণ কার্যকারিতা এবং পরিপূর্ণ ডকুমেন্টেশন রয়েছে। v1 স্থাপত্য এখনও পরীক্ষামূলক পর্যায়ে এবং আরও মডুলার স্তরভিত্তিক নকশা অনুসরণ করে।
3.2 v0-এর মূল মডিউলগুলোর বিশদ
src/llamafactory/
├── cli.py              # CLI প্রবেশপথ, llamafactory-cli কমান্ড বিতরণ
├── launcher.py          # লঞ্চার, USE_V1 অনুযায়ী বিতরণ
├── api/                 # OpenAI-ধাঁচের REST API
│   ├── app.py           # FastAPI অ্যাপ্লিকেশন
│   ├── chat.py          # কথোপকথন এন্ডপয়েন্ট
│   └── protocol.py      # প্রোটোকল সংজ্ঞা
├── chat/                # ইনফারেন্স ইঞ্জিন স্তর
│   ├── base_engine.py   # বিমূর্ত বেস ক্লাস
│   ├── hf_engine.py     # HuggingFace নেটিভ ইনফারেন্স
│   ├── vllm_engine.py   # vLLM উচ্চ-কার্যক্ষমতা ইনফারেন্স
│   └── sglang_engine.py # SGLang ইনফারেন্স
├── data/                # ডেটা প্রক্রিয়াকরণ স্তর
│   ├── template.py      # 100+ মডেলের Prompt টেমপ্লেট রেজিস্ট্রেশন
│   ├── mm_plugin.py     # মাল্টিমোডাল (ছবি/ভিডিও/অডিও) প্রক্রিয়াকরণ
│   ├── loader.py        # ডেটাসেট লোডার
│   ├── processor/       # প্রশিক্ষণ পর্যায়ভিত্তিক প্রসেসর
│   └── converter.py     # ফরম্যাট রূপান্তর (Alpaca/ShareGPT)
├── model/               # মডেল স্তর
│   ├── loader.py        # মডেল+টোকেনাইজার লোড, কোয়ান্টাইজেশন, LoRA
│   └── patcher.py       # মডেল সামঞ্জস্য প্যাচ
├── train/               # প্রশিক্ষণ স্তর
│   ├── sft/             # তত্ত্বাবধায়িত ফাইন-টিউনিং
│   ├── dpo/             # DPO পছন্দ অপ্টিমাইজেশন
│   ├── ppo/             # PPO রিইনফোর্সমেন্ট লার্নিং
│   ├── rm/              # পুরস্কার মডেলিং
│   ├── pt/              # প্রি-ট্রেনিং
│   ├── kto/             # KTO প্রশিক্ষণ
│   └── mca/             # Megatron-Core অভিযোজন
├── hparams/              # প্যারামিটার কনফিগারেশন স্তর
│   ├── model_args.py    # মডেল প্যারামিটার
│   ├── data_args.py     # ডেটা প্যারামিটার
│   ├── finetuning_args.py # ফাইন-টিউনিং প্যারামিটার
│   └── training_args.py # প্রশিক্ষণ প্যারামিটার (HF TrainingArguments উত্তরাধিকারী)
├── extras/               # ইউটিলিটি প্যাকেজ
│   ├── constants.py     # গ্লোবাল ধ্রুবক/এনাম
│   └── packages.py      # নির্ভরতা পরীক্ষা
└── webui/                # LLaMA Board Web ইন্টারফেস
    ├── interface.py     # Gradio ইন্টারফেস নির্মাণ
    ├── runner.py        # প্রশিক্ষণ কাজ শুরু
    └── components/      # UI উপাদান
3.3 প্রশিক্ষণ প্রক্রিয়া (v0 Training Flow)
llamafactory-cli train xxx.yaml
  → run_exp() [tuner.py]
    → read_args() → YAML/JSON কনফিগারেশন পার্স
    → get_train_args() → ৪ ধরনের টাইপযুক্ত dataclass তৈরি:
        ModelArguments + DataArguments + FinetuningArguments + TrainingArguments
    → নির্দিষ্ট প্রশিক্ষণ ফাংশনে রাউট:
        run_sft / run_dpo / run_ppo / run_rm / run_pt / run_kto
    → (ঐচ্ছিক) export_model() → LoRA ওজন একত্র করে এক্সপোর্ট
3.4 ইনফারেন্স ইঞ্জিন ম্যাট্রিক্স
ইঞ্জিন|বৈশিষ্ট্য|প্রযোজ্য ক্ষেত্র
HF Engine|নেটিভ HuggingFace, সর্বোচ্চ সামঞ্জস্য|ডেভেলপমেন্ট ডিবাগিং, ছোট আকারের ইনফারেন্স
vLLM Engine|270% ইনফারেন্স ত্বরণ, PagedAttention|উচ্চ-কার্যক্ষমতা অনলাইন ইনফারেন্স
SGLang Engine|RadixAttention, কাঠামোবদ্ধ জেনারেশন|ব্যাচ ইনফারেন্স, জটিল জেনারেশন
KT Engine|জ্ঞান স্থানান্তরের জন্য|মডেল ডিস্টিলেশন
৪. কার্যকারিতা ব্যবস্থা
4.1 সমর্থিত প্রশিক্ষণ প্যারাডাইম (৮ ধরনের × ৬ ধরনের ফাইন-টিউনিং পদ্ধতি = ৪৮টি সমন্বয়)
প্রশিক্ষণ প্যারাডাইম|Full|Freeze|LoRA|QLoRA|OFT|QOFT
প্রি-ট্রেনিং (PT)|✅|✅|✅|✅|✅|✅
তত্ত্বাবধায়িত ফাইন-টিউনিং (SFT)|✅|✅|✅|✅|✅|✅
পুরস্কার মডেলিং (RM)|✅|✅|✅|✅|✅|✅
PPO প্রশিক্ষণ|✅|✅|✅|✅|✅|✅
DPO প্রশিক্ষণ|✅|✅|✅|✅|✅|✅
KTO প্রশিক্ষণ|✅|✅|✅|✅|✅|✅
ORPO প্রশিক্ষণ|✅|✅|✅|✅|✅|✅
SimPO প্রশিক্ষণ|✅|✅|✅|✅|✅|✅
4.2 সমর্থিত মডেল সিরিজ (60+ সিরিজ, 100+ ভেরিয়েন্ট)
নির্বাচিত প্রতিনিধিত্বশীল মডেল:
মডেল সিরিজ|প্যারামিটার স্কেল|বৈশিষ্ট্য
Llama 3-4|1B–402B|Meta-এর ফ্ল্যাগশিপ ওপেন-সোর্স মডেল
Qwen 2-3.6|0.5B–397B|আলিবাবা টংইয়ি কিয়ানওয়েনের সম্পূর্ণ সিরিজ
DeepSeek R1|1.5B–671B|রিজনিং মডেলের ডিস্টিলড সংস্করণ
Gemma 3|270M–27B|Google-এর লাইটওয়েট মডেল
InternVL 2.5-3.5|1B–241B|মাল্টিমোডাল ভিশন-ল্যাঙ্গুয়েজ মডেল
MiniCPM|0.5B–9B|এজ-সাইড ডিপ্লয়মেন্টের জন্য অপ্টিমাইজড
GLM-4/4.5|9B–355B|Zhipu ChatGLM সিরিজ
Mistral/Mixtral|7B–8x22B|MoE বিশেষজ্ঞ মিশ্রণ
Phi-3/4|3.8B–14B|Microsoft-এর ছোট আকারের উচ্চ-ক্ষমতাসম্পন্ন মডেল
Qwen-VL 2-3|2B–235B|ভিশন-ল্যাঙ্গুয়েজ মডেল
4.3 উন্নত অ্যালগরিদম সমর্থন
অ্যালগরিদম|ফাংশন|প্রবর্তিত সংস্করণ
FlashAttention-2|অ্যাটেনশন গণনা ত্বরান্বিত করে|2023-09
Unsloth|170% প্রশিক্ষণ ত্বরণ + 50% মেমরি সাশ্রয়|2023-12
DoRA|ওজন বিভাজন LoRA|2024-02
GaLore|গ্রেডিয়েন্ট লো-র্যাঙ্ক অপ্টিমাইজেশন|2024-03
BAdam|ব্লক কোঅর্ডিনেট ডিসেন্ট অপ্টিমাইজেশন|2024-04
APOLLO|উচ্চতর-ক্রমের অপ্টিমাইজার|2025-Q1
Liger Kernel|Triton কার্নেল ত্বরণ|2025
FP8 প্রশিক্ষণ|Transformer Engine সমর্থন|2025
4.4 LLaMA Board Web UI
Gradio-ভিত্তিক জিরো-কোড ভিজ্যুয়াল ইন্টারফেস
মডেল নির্বাচন → ডেটাসেট কনফিগারেশন → ফাইন-টিউনিং প্যারামিটার → এক ক্লিকে প্রশিক্ষণ শুরু
রিয়েল-টাইম মনিটরিং: Loss কার্ভ, GPU ব্যবহার, প্রশিক্ষণের অগ্রগতি
TensorBoard, Wandb, MLflow, SwanLab-সহ একাধিক ব্যাকএন্ড লগ সমর্থন
অন্তর্নির্মিত ইনফারেন্স Chat ইন্টারফেস, প্রশিক্ষণ শেষেই পরীক্ষা করা যায়
4.5 ডিপ্লয়মেন্ট পদ্ধতি
# CLI ফাইন-টিউনিং (এক লাইনের কমান্ড)
llamafactory-cli train examples/train_lora/qwen3_lora_sft.yaml

# Web UI
llamafactory-cli webui

# OpenAI-ধাঁচের API ডিপ্লয়মেন্ট
API_PORT=8000 llamafactory-cli api examples/inference/qwen3.yaml

# Docker
docker run -it --rm --gpus=all hiyouga/llamafactory:latest
পাঁচ. হার্ডওয়্যার প্রয়োজনীয়তা (ভিডিও মেমরি অনুমান)
পদ্ধতি|নির্ভুলতা|7B|14B|30B|70B
Full (bf16)|32-bit|120GB|240GB|600GB|1200GB
Full (pure_bf16)|16-bit|60GB|120GB|300GB|600GB
Freeze/LoRA|16-bit|16GB|32GB|64GB|160GB
QLoRA|8-bit|10GB|20GB|40GB|80GB
QLoRA|4-bit|6GB|12GB|24GB|48GB
QLoRA|2-bit|4GB|8GB|16GB|24GB
QLoRA 4-bit কোয়ান্টাইজেশন একটি RTX 3060 (12 GB ভিডিও মেমরি) GPU-তে 14 B প্যারামিটারের মডেল এবং একটি RTX 4090 (24 GB ভিডিও মেমরি) GPU-তে 30 B প্যারামিটারের মডেল ফাইন-টিউন করতে পারে।
ছয়. সংস্করণের বিবর্তন
সংস্করণ|তারিখ|মূল পরিবর্তন
v0.1.0|2023-03|প্রাথমিক প্রকাশ, LLaMA ফাইন-টিউনিং সমর্থন
প্রাথমিক পর্যায়|2023|SFT + LoRA/QLoRA, DPO, Web UI, FlashAttention-2, Unsloth
প্রাথমিক পর্যায়|2024 Q1-Q3|DoRA, GaLore, BAdam, FSDP+QLoRA, vLLM, মাল্টিমোডাল LLaVA, গবেষণাপত্র প্রকাশ
v0.9.1|2025 Q1|Llama 3.2 Vision, LLaVA-NeXT, Pixtral, Video-LLaVA
v0.9.2|2025 Q1|MiniCPM-o, SwanLab, APOLLO অপ্টিমাইজার
v0.9.3|2025 Q2|Llama 4, Gemma 3, Qwen3, InternVL3, Qwen2.5-Omni
v0.9.4|2025-12|🔄 রিপোজিটরির নাম LlamaFactory করা হয়েছে, Python 3.9-3.10 বাতিল
v0.9.5|2026-05-30|Qwen3.5/3.6, Gemma 4, Transformers v5 সামঞ্জস্য
v1.x (পরীক্ষামূলক)|2026|নতুন আর্কিটেকচার trainers → core → accelerator, মডিউলার পুনর্লিখন
গুরুত্বপূর্ণ মাইলফলকের ব্যাখ্যা
ACL 2024 গবেষণাপত্র প্রকাশ —— একাডেমিক স্বীকৃতির ফলে Stars ১০ হাজার থেকে দ্রুত ৩০ হাজারের বেশি হয়েছে
2024 সালের দ্বিতীয়ার্ধ —— মাল্টিমোডাল সমর্থন (LLaVA/Video/অডিও) নতুন বাজার উন্মুক্ত করেছে
2025 সাল —— মাসিক আপডেটের গতি বজায় রেখে Qwen3/DeepSeek/Llama4 সমর্থন; চীনের ওপেন-সোর্স কমিউনিটির প্রথম পছন্দে পরিণত
রিপোজিটরির নাম পরিবর্তন —— LLaMA-Factory → LlamaFactory, Meta ব্র্যান্ডের ওপর নির্ভরতা কমানো
v1 পরীক্ষামূলক আর্কিটেকচার —— বড় ধরনের পুনর্গঠন আসন্ন হওয়ার ইঙ্গিত
সাত. কমিউনিটি ইকোসিস্টেম
7.1 প্রকল্প ইকোসিস্টেম ম্যাট্রিক্স
প্রকল্প|বিবরণ|Stars
LlamaFactory|মূল ফাইন-টিউনিং ফ্রেমওয়ার্ক|72K+
EasyR1|VLM রিইনফোর্সমেন্ট লার্নিং (GRPO/DAPO/Reinforce++)|উদীয়মান
FastEdit|দক্ষ মডেল ফ্যাক্ট এডিটিং|আর্কাইভ করা হয়েছে
llamafactory-community|কমিউনিটি যোগাযোগ কেন্দ্র|-
Easy Dataset|সিন্থেটিক ডেটা তৈরির টুল|তৃতীয় পক্ষ
DataFlow|ডেটা প্রসেসিং পাইপলাইন|তৃতীয় পক্ষ
7.2 কমিউনিটির জনপ্রিয়তা
চীনা AI কমিউনিটি: CSDN, Zhihu, বোকেয়ুয়ানে শত শত টিউটোরিয়াল/ব্যবহারিক অভিজ্ঞতা
প্রতিষ্ঠানে গ্রহণ: Alibaba Cloud, Huawei Ascend, Amazon AWS, NVIDIA-এর সরকারি সুপারিশ
শিক্ষাক্ষেত্র: Fudan University-সহ একাধিক বিশ্ববিদ্যালয়ে বড় ভাষা মডেল কোর্সের শিক্ষণ টুল হিসেবে ব্যবহৃত
চীনা ভাষা সমর্থন: ModelScope (মোতা কমিউনিটি) এবং OpenMind Hub মিরর ডাউনলোডের নেটিভ সমর্থন
LLaMA Factory Online: আগে অনলাইন প্ল্যাটফর্ম সেবা দিত, 2026-06-20 বন্ধ হয়েছে
7.3 প্রতিযোগী তুলনা
ফ্রেমওয়ার্ক|Stars|মূল বৈশিষ্ট্য|মডেল সমর্থন|ব্যবহারের সহজতা
LlamaFactory|72K|অল-ইন-ওয়ান GUI/CLI, ACL গবেষণাপত্রের স্বীকৃতি|100+|⭐⭐⭐⭐⭐
HuggingFace TRL|12K|HF-এর সরকারি টুলচেইন, ইকোসিস্টেমের সঙ্গে গভীর সংযুক্তি|সমস্ত HF মডেল|⭐⭐⭐
Axolotl|8K|YAML-চালিত, উন্নত ব্যবহারকারীদের কাস্টমাইজেশন|প্রধানধারার মডেল|⭐⭐⭐
Unsloth|20K+|চূড়ান্ত পারফরম্যান্স অপ্টিমাইজেশন (2-5x ত্বরণ)|LLaMA/Mistral ইত্যাদি|⭐⭐⭐⭐
Firefly|5K|চীনা বড় ভাষা মডেলের অপ্টিমাইজেশন|মূলত চীনা মডেল|⭐⭐⭐
LLaMA-Adapter|6K|একাডেমিক গবেষণাকেন্দ্রিক|LLaMA সিরিজ|⭐⭐
LlamaFactory-এর মূল সুবিধা:
একমাত্র ফ্রেমওয়ার্ক যার একসঙ্গে ACL গবেষণাপত্র + ৭০ হাজার Stars + বাণিজ্যিক প্রয়োগের উদাহরণ + জিরো-কোড GUI রয়েছে
সবচেয়ে বিস্তৃত মডেল সমর্থন (GPT-2 থেকে Llama 4, বিশুদ্ধ টেক্সট থেকে মাল্টিমোডাল পর্যন্ত)
চীনা কমিউনিটি ইকোসিস্টেমে সবচেয়ে শক্তিশালী (HuggingFace মিরর + ModelScope ইন্টিগ্রেশন)
আট. SWOT বিশ্লেষণ
8.1 শক্তি (Strengths)
শক্তি|বিস্তারিত
🔬 একাডেমিক কর্তৃত্ব|ACL 2024 গবেষণাপত্র, 500+ একাডেমিক উদ্ধৃতি
🎯 অত্যন্ত কম প্রবেশ-সীমা|এক লাইনের কমান্ডে ফাইন-টিউনিং, Web UI-তে জিরো-কোড অপারেশন
🌐 সবচেয়ে বিস্তৃত মডেল কভারেজ|100+ মডেল, 60+ সিরিজ, টেক্সট/ভিশন/ভিডিও/অডিও
🇨🇳 চীনা কমিউনিটি ইকোসিস্টেম|ModelScope/OpenMind মিরর, বিপুল চীনা টিউটোরিয়াল
🔧 ইন্ডাস্ট্রিয়াল-গ্রেড টুলচেইন|Docker/ডিস্ট্রিবিউটেড/API ডিপ্লয়মেন্ট সম্পূর্ণ সমর্থিত
💾 চূড়ান্ত ভিডিও মেমরি অপ্টিমাইজেশন|QLoRA 4-bit-এ ভোক্তা-গ্রেড GPU-তে 70B চালানো যায়
8.2 দুর্বলতা (Weaknesses)
দুর্বলতা|বিস্তারিত
👤 একক ব্যক্তিনির্ভরতা গুরুতর|hiyouga 72% কমিট করেছেন (2,188/3,042), Bus Factor = 1
📚 ডকুমেন্টেশন বিচ্ছিন্ন|README অত্যন্ত দীর্ঘ (68KB), Wiki/ReadTheDocs/কমিউনিটি নিবন্ধের তথ্য খণ্ডিত
🐛 Issue জমে আছে|মাত্র 57টি Open Issues হলেও Issue বিভাগে আলোচনার পরিমাণ বিপুল
🏗️ v0/v1 দ্বৈত ধারায় বিভক্ত|দুই আর্কিটেকচার রক্ষণাবেক্ষণের খরচ বেশি, v1 দীর্ঘদিন স্থিতিশীল নয়
📦 প্যাকেজ নির্ভরতা জটিল|CUDA/PyTorch/FlashAttn সংস্করণ ম্যাট্রিক্সে ভুল হওয়ার সম্ভাবনা অত্যন্ত বেশি
🔒 একাডেমিক প্রকল্পের বৈশিষ্ট্য|পূর্ণকালীন পরিচালনাকারী দল নেই, দীর্ঘমেয়াদি স্থায়িত্ব নিয়ে সন্দেহ
8.3 সুযোগ (Opportunities)
সুযোগ|বিস্তারিত
🚀 Agent ফাইন-টিউনিং ক্ষেত্র|Function Calling / Tool Use ফাইন-টিউনিংয়ের চাহিদা দ্রুত বাড়ছে
🎥 মাল্টিমোডাল সম্প্রসারণ|Video/Audio/3D মডেল ফাইন-টিউনিংয়ের নীল সমুদ্রের বাজার
☁️ ক্লাউড-নেটিভ SaaS|LLaMA Factory Online বন্ধ হলেও এন্টারপ্রাইজ-গ্রেড ম্যানেজড সেবার চাহিদা রয়ে গেছে
🏢 এন্টারপ্রাইজ প্রশিক্ষণ বাজার|বড় ভাষা মডেল ফাইন-টিউনিং প্রশিক্ষণ কোর্স ও সার্টিফিকেশন ব্যবস্থা
🔗 MCP ইন্টিগ্রেশন|AI Agent অবকাঠামোর ফাইন-টিউনিং ব্যাকএন্ড হিসেবে ব্যবহার
8.4 হুমকি (Threats)
হুমকি|বিস্তারিত
🏢 বড় প্রতিষ্ঠানের নিজস্ব ফ্রেমওয়ার্ক|Alibaba PAI, Huawei ModelArts সমন্বিত সমাধান দিচ্ছে
🔄 HF-এর সরকারি প্রতিযোগিতা|HuggingFace TRL/peft ইকোসিস্টেম ক্রমশ উন্নত হচ্ছে
📉 ফাইন-টিউনিংয়ের চাহিদা কমে যাওয়া|Prompt Engineering + RAG ফাইন-টিউনিংয়ের কিছু ক্ষেত্র প্রতিস্থাপন করছে
👨🎓 প্রতিষ্ঠাতার স্নাতক হওয়া|ডক্টর Zheng Yaowei স্নাতক হওয়ার পর প্রকল্প রক্ষণাবেক্ষণের মাত্রা কমে যেতে পারে
নয়. ঝুঁকি মূল্যায়ন
ঝুঁকির ধরন|ঝুঁকির স্তর|বিবরণ
Bus Factor|🔴 উচ্চ ঝুঁকি|একজন প্রধান ডেভেলপার ৭২% কমিট করেছেন; তিনি চলে গেলে প্রকল্প স্থবির হয়ে পড়ার ঝুঁকি অত্যন্ত বেশি
প্রযুক্তিগত ঋণ|🟡 মাঝারি ঝুঁকি|v0/v1 দ্বৈত আর্কিটেকচার, 68KB README, ডকুমেন্টেশন খণ্ডিত
নির্ভরতা শৃঙ্খল|🟡 মাঝারি ঝুঁকি|CUDA/PyTorch/FlashAttn সংস্করণ ম্যাট্রিক্স রক্ষণাবেক্ষণের খরচ বেশি
বাণিজ্যিকীকরণ|🟢 কম ঝুঁকি|Apache-2.0 লাইসেন্স, কোনো বাণিজ্যিক সীমাবদ্ধতা নেই
কমিউনিটির স্বাস্থ্য|🟢 সুস্থ|৭২ হাজার Stars, বিশ্বব্যাপী সক্রিয় কমিউনিটি, প্রতিষ্ঠানগুলোতে ব্যাপক ব্যবহার
দশ. প্রযুক্তিগত বৈশিষ্ট্য ও উদ্ভাবন
10.1 "মানসম্মত উচ্চগতির মহাসড়ক" আর্কিটেকচার
প্রচলিত ফাইন-টিউনিংয়ে প্রতিটি মডেলকে আলাদাভাবে অ্যাডাপ্ট করতে হয়। LLaMA Factory টেমপ্লেট রেজিস্ট্রেশন ব্যবস্থা ও monkey‑patch প্রযুক্তি ব্যবহার করে, ফলে অ্যাডাপ্টেশনের খরচ উল্লেখযোগ্যভাবে কমে যায়।
# নতুন মডেল যোগ করতে মাত্র ৩টি ধাপ:
# 1. template.py-এর TEMPLATES ডিকশনারিতে Prompt টেমপ্লেট রেজিস্টার করুন
# 2. patcher.py-তে মডেল-সামঞ্জস্য প্যাচ যোগ করুন (প্রয়োজন হলে)
# 3. mm_plugin.py-তে মাল্টিমোডাল সমর্থন যোগ করুন (প্রয়োজন হলে)
10.2 চার-স্তরীয় প্যারামিটার কনফিগারেশন সিস্টেম
YAML/JSON কনফিগারেশন ফাইল
  → parser.py পার্স করে
    → ModelArguments (মডেল নির্বাচন, কোয়ান্টাইজেশন)
    → DataArguments (ডেটাসেট, টেমপ্লেট, প্রিপ্রসেসিং)
    → FinetuningArguments (LoRA rank/target, ট্রেনিং পদ্ধতি)
    → TrainingArguments (HF থেকে উত্তরাধিকার, ডিস্ট্রিবিউশন/লগ/চেকপয়েন্ট)
10.3 ডেটা পাইপলাইন মানসম্মতকরণ
এই টুলটি Alpaca ও ShareGPT—দুটি প্রধান ডেটা ফরম্যাট সমর্থন করে, ৫০টিরও বেশি পূর্বনির্ধারিত ডেটাসেট স্বয়ংক্রিয়ভাবে রূপান্তর করতে পারে এবং JSON, JSONL, CSV, Parquet, Arrowসহ বিভিন্ন ফাইল ফরম্যাটের সঙ্গে সামঞ্জস্যপূর্ণ।
10.4 ধাপে ধাপে কোয়ান্টাইজেশন সমর্থন
১৬-বিট পূর্ণ নির্ভুলতা থেকে ২-বিট QLoRA পর্যন্ত ছয়টি নির্ভুলতার স্তর সমর্থিত; A100 সার্ভার ক্লাস্টার থেকে সাধারণ ল্যাপটপ—বিভিন্ন হার্ডওয়্যার পরিবেশে এটি ব্যবহার করা যায়।
এগারো. প্রতিযোগী তুলনা ম্যাট্রিক্স
মাত্রা|LlamaFactory|HuggingFace TRL|Unsloth|Axolotl
Stars|72K|12K|20K+|8K
মডেল সমর্থন|100+ সিরিজ|সমস্ত HF|LLaMA/Qwen/Mistral|প্রধান সিরিজ
GUI|✅ LLaMA Board|❌|❌|❌
কোড ছাড়া|✅ CLI + YAML|❌ কোডিং প্রয়োজন|❌ কোডিং প্রয়োজন|শুধু YAML
ট্রেনিং প্যারাডাইম|৮টি|৪টি (SFT/DPO/PPO/GRPO)|৩টি|৫টি
কোয়ান্টাইজেশনের গভীরতা|2-16bit|4-16bit|4-16bit|4-16bit
মাল্টিমোডাল|✅ ছবি/ভিডিও/অডিও|❌|❌|❌
চীনা ইকোসিস্টেম|✅ ModelScope + 魔搭|⚠️ VPN প্রয়োজন|⚠️ VPN প্রয়োজন|❌
একাডেমিক পেপার|ACL 2024|-|-|-
ইনফারেন্স ইঞ্জিন|vLLM/SGLang/HF|শুধু HF|শুধু HF|vLLM/HF
শেখার বক্ররেখা|অত্যন্ত কম|মাঝারি|কম|মাঝারি থেকে বেশি
বারো. ডিপ্লয়মেন্টের ব্যবহারিক বিষয়
12.1 দ্রুত শুরু (৩ ধাপ)
# ধাপ ১: ইনস্টলেশন
git clone --depth 1 github.com/hiyouga/LlamaFactory.git
cd LlamaFactory
pip install -e ".[torch,metrics]"

# ধাপ ২: Web UI চালু করুন
llamafactory-cli webui

# ধাপ ৩: ব্রাউজারে localhost:7860 খুলে মডেল → ডেটাসেট → ট্রেনিং নির্বাচন করুন!
12.2 প্রোডাকশন পরিবেশের পরামর্শ
# Docker ডিপ্লয়মেন্ট (প্রস্তাবিত)
docker run -it --rm --gpus=all \
    -v ./hf_cache:/root/.cache/huggingface \
    -v ./data:/app/shared_data \
    -v ./output:/app/output \
    -p 7860:7860 -p 8000:8000 \
    hiyouga/llamafactory:latest

# API ডিপ্লয়মেন্ট (OpenAI-সামঞ্জস্যপূর্ণ)
API_PORT=8000 llamafactory-cli api \
    examples/inference/qwen3.yaml \
    infer_backend=vllm
12.3 Windows ব্যবহারকারীদের জন্য নোট
PyTorch-এর GPU সংস্করণ হাতে ইনস্টল করতে হবে:
pip install torch torchvision torchaudio --index-url download.pytorch.org/whl/cu126QLoRA-এর জন্য Windows-উপযোগী bitsandbytes প্রি-কম্পাইলড সংস্করণ ইনস্টল করতে হবে
Windows-এ FlashAttention-2 হাতে কম্পাইল করতে হবে
সিরিয়ালাইজেশন ত্রুটি এড়াতে
dataloader_num_workers: 0সেট করুন
তেরো. ভবিষ্যৎ перспективা
v1 আর্কিটেকচার স্থিতিশীলকরণ:পরীক্ষামূলক শাখাটি 2026-2027 সালে প্রধান আর্কিটেকচারে পরিণত হবে বলে প্রত্যাশা করা হচ্ছে; মডিউলারিটি আরও বেশি হবে
Agent ফাইন-টিউনিংয়ের গভীরায়ন:Tool Use / Function Calling ফাইন-টিউনিং একটি মানসম্মত ফিচারে পরিণত হবে
রিজনিং মডেলের ফাইন-টিউনিং:DeepSeek-R1 ডিস্টিলেশন + GRPO ফাইন-টিউনিং (EasyR1 প্রকল্প)
ক্লাউড-নেটিভ হোস্টিং:LLaMA Factory Online বন্ধ হওয়ার পর তৃতীয় পক্ষের হোস্টিং সমাধান দেখা দিতে পারে
মাল্টিমোডাল ট্রেনিং একীকরণ:একই ফ্রেমওয়ার্কে টেক্সট/ছবি/ভিডিও/অডিও ফাইন-টিউনিং
চৌদ্দ. মূল্যায়ন ও সারাংশ
মাত্রা|স্কোর|মন্তব্য
প্রযুক্তিগত আর্কিটেকচার|9.5/10|মডিউলার ডিজাইন, দ্বৈত আর্কিটেকচারের বিবর্তন, সমৃদ্ধ ইঞ্জিন ম্যাট্রিক্স
ফিচারের পূর্ণতা|10/10|৮টি ট্রেনিং প্যারাডাইম × ৬টি ফাইন-টিউনিং পদ্ধতি × 100+ মডেল
ব্যবহারের সহজতা|10/10|এক লাইনের কমান্ডে ফাইন-টিউনিং + কোড ছাড়া Web UI, শিল্পক্ষেত্রে সেরা
ডকুমেন্টেশনের মান|7.5/10|README বিস্তারিত হলেও অতিরিক্ত দীর্ঘ এবং অত্যন্ত খণ্ডিত
কমিউনিটির সক্রিয়তা|9.5/10|72K Stars, চীনা কমিউনিটিতে ব্যাপক জনপ্রিয়তা
প্রোডাকশনের প্রস্তুতি|9.0/10|Docker/API/ডিস্ট্রিবিউশন সম্পূর্ণ, প্রতিষ্ঠানে ব্যাপকভাবে যাচাইকৃত
টেকসই উন্নয়ন|6.5/10|Bus Factor=1, একাডেমিক প্রকল্পের বৈশিষ্ট্য, দীর্ঘমেয়াদি স্থায়িত্ব অনিশ্চিত
উদ্ভাবন|8.5/10|ACL পেপার, টেমপ্লেট রেজিস্ট্রেশন ব্যবস্থা, চার-স্তরীয় প্যারামিটার সিস্টেম
সামগ্রিক স্কোর: 9.
এক বাক্যে সারাংশ
LLaMA Factory একটি ওপেন-সোর্স বড় ভাষা মডেল ফাইন-টিউনিং ফ্রেমওয়ার্ক, যা ACL 2024 পেপারের ভিত্তিতে তৈরি এবং GitHub-এ প্রায় 72 000টি Stars পেয়ে কমিউনিটির স্বীকৃতি অর্জন করেছে। ফ্রেমওয়ার্কটি “অ্যালগরিদম‑মডেল‑ডেটা বিচ্ছিন্নকরণ” নীতিতে তৈরি; এতে কোড ছাড়া কমান্ড-লাইন ইন্টারফেস (CLI) ও Web UI রয়েছে এবং 100টিরও বেশি মডেল ফাইন-টিউনিং সমর্থন করে, ফলে বড় ভাষা মডেল ফাইন-টিউনিংয়ের প্রযুক্তিগত প্রবেশদ্বার উল্লেখযোগ্যভাবে কমে যায়। এটি বড় ভাষা মডেলভিত্তিক অ্যাপ্লিকেশন বাস্তবায়নের অবকাঠামো হিসেবে ব্যবহার করা যেতে পারে।