

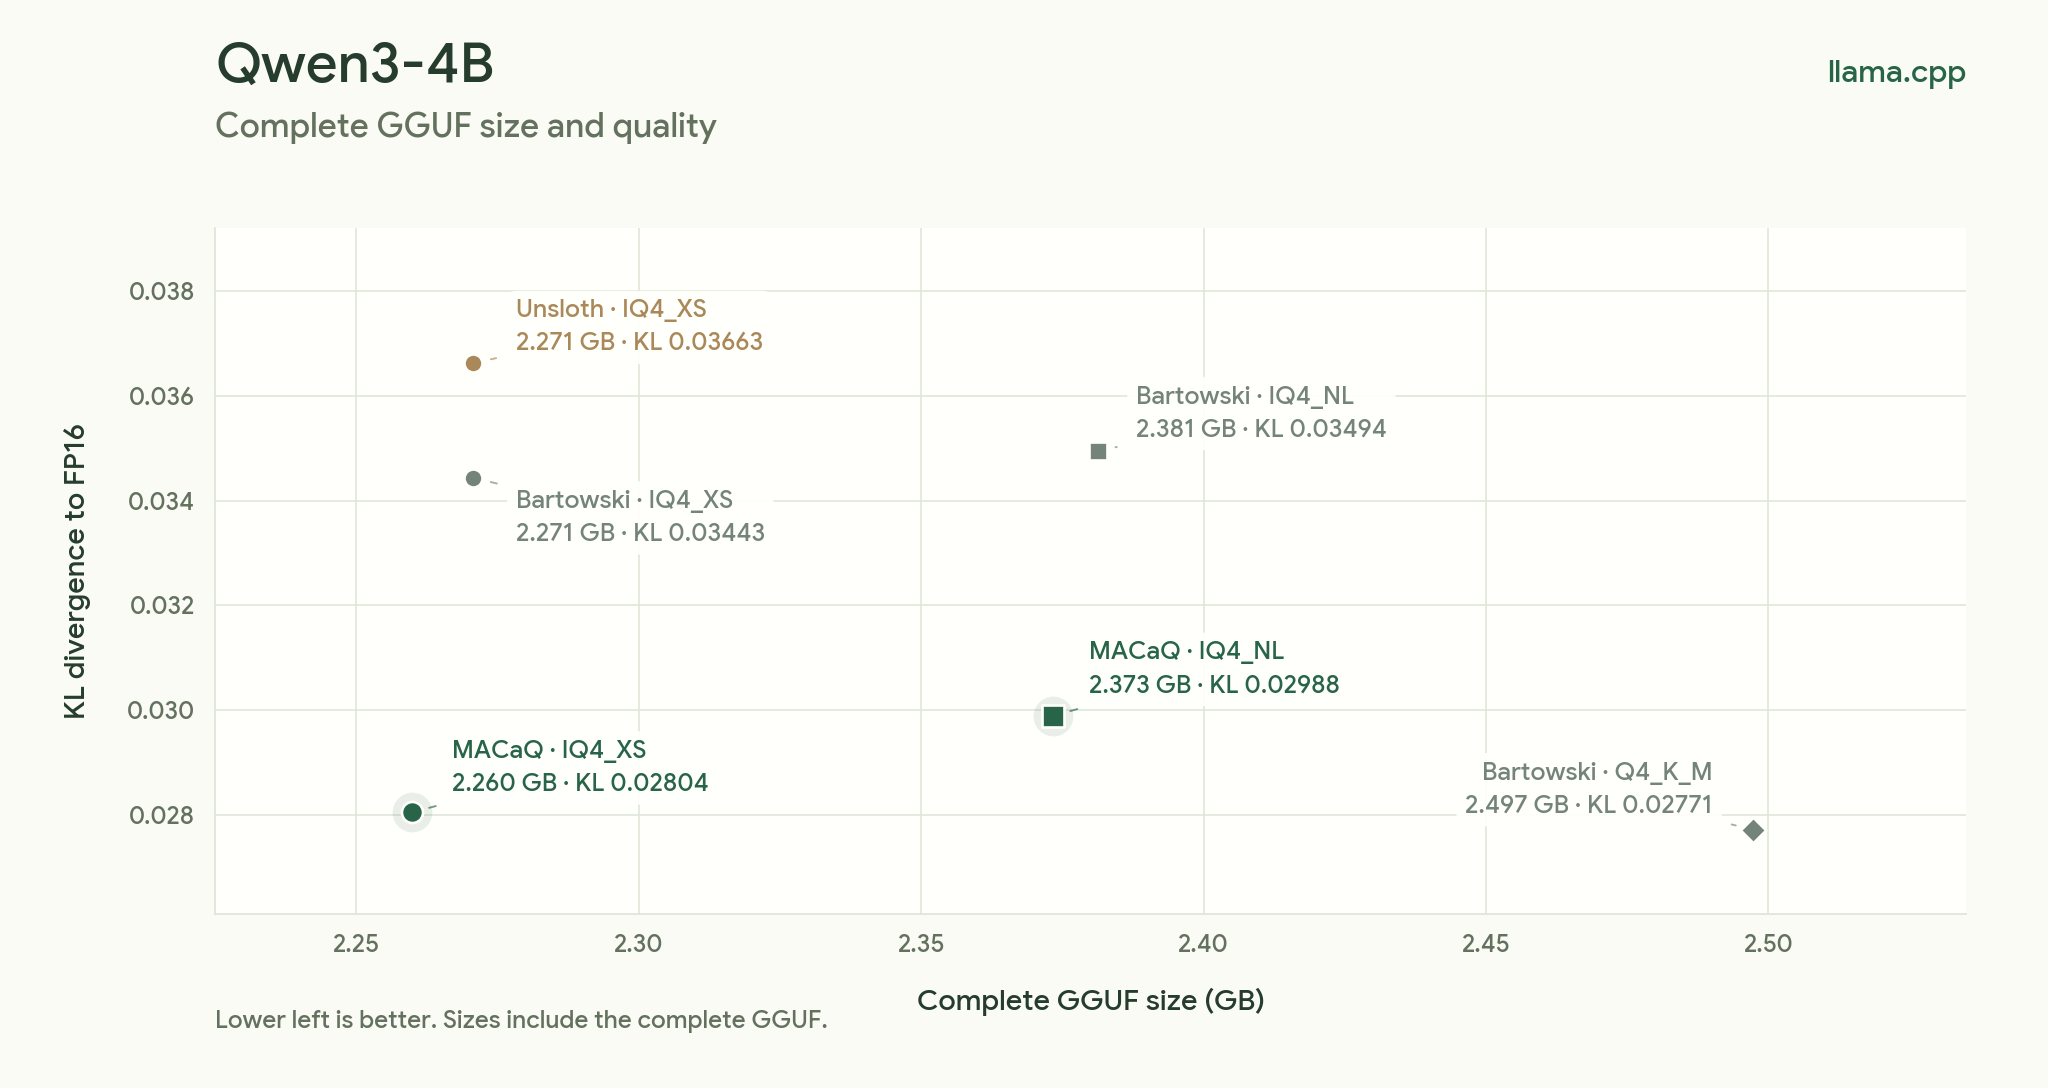
MACaQ হলো মডেল-নিরপেক্ষ ক্যালিব্রেটেড কোয়ান্টাইজেশন প্রকল্প, যা আধুনিক AI মডেলের মেমরি ও কম্পিউটের প্রয়োজন কমানোর জন্য তৈরি। এটি llama.cpp, vLLM, Diffusers এবং PyTorch-এর মাধ্যমে টেক্সট, ছবি, ভিডিও ও অডিও ওয়ার্কফ্লো সমর্থন করে।
প্রকল্পটি ব্যবহারিক ইনফারেন্স সামঞ্জস্য বজায় রেখে ক্যালিব্রেটেড লো-প্রিসিশন ওজন ও অ্যাক্টিভেশনের ওপর গুরুত্ব দেয়। README অনুযায়ী, MACaQ 32.5 GB ডিভাইস মেমরি ব্যবহার করে 64 মিনিটে 122-বিলিয়ন-প্যারামিটারের একটি মডেল কোয়ান্টাইজ করতে পারে। কিছু তুলনায় এটি MR-GPTQ ও DuQuant++-এর চেয়ে কম perplexity দেখায়, অথবা উল্লেখযোগ্যভাবে কম কোয়ান্টাইজেশন সময়ে Llama-3-8B-এর কাছাকাছি perplexity অর্জন করে।
সঠিক MACaQ ব্যাকএন্ড বেছে নিন
আপনার মডেল ও ডিপ্লয়মেন্ট লক্ষ্যের সঙ্গে মেলে এমন ব্যাকএন্ড নির্বাচন করে শুরু করুন। প্রতিটি ব্যাকএন্ডের জন্য আলাদা পরিবেশ এবং Python 3.12 ব্যবহার করুন।
- Diffusers: ছবি, ভিডিও ও অডিও জেনারেশন মডেলকে W4A4 safetensors চেকপয়েন্টে কোয়ান্টাইজ করে।
- llama.cpp: টেক্সট মডেলকে 2-, 3- অথবা 4-বিট GGUF ফাইলে কোয়ান্টাইজ করে এবং CPU-সহ স্থানীয়ভাবে চালায়।
- vLLM: W4A4 অথবা weight-only ফরম্যাট ব্যবহার করে জেনারেশন বা HTTP সার্ভিংয়ের জন্য টেক্সট মডেল কোয়ান্টাইজ করে।
- PyTorch: স্পিচ জেনারেশন মডেলকে W4A4 চেকপয়েন্টে কোয়ান্টাইজ করে এবং WAV অডিও তৈরি করে।
রিপোজিটরিতে প্রতিটি ব্যাকএন্ডের জন্য আলাদা ইনস্টলেশন, ক্যালিব্রেশন, কোয়ান্টাইজেশন ও জেনারেশন নির্দেশনা রয়েছে। শুরু করার আগে নির্বাচিত ব্যাকএন্ডের গাইড খুলুন:
- Diffusers ইনস্টলেশন ও ওয়ার্কফ্লো
- llama.cpp ইনস্টলেশন ও ওয়ার্কফ্লো
- vLLM ইনস্টলেশন ও সার্ভিং
- PyTorch স্পিচ ওয়ার্কফ্লো
আপনার পরিবেশ প্রস্তুত করুন
Python 3.12 ব্যবহার করুন এবং যে ব্যাকএন্ড ব্যবহার করতে চান তার জন্য একটি বিচ্ছিন্ন পরিবেশ তৈরি করুন। পরিবেশ আলাদা রাখলে llama.cpp, vLLM, Diffusers ও PyTorch-এর নির্ভরতার মধ্যে সংঘাত এড়ানো যায়।
MACaQ রিপোজিটরি ক্লোন করে এর ডিরেক্টরিতে প্রবেশ করুন।
নির্বাচিত ব্যাকএন্ডের জন্য একটি Python 3.12 ভার্চুয়াল পরিবেশ তৈরি করুন।
ব্যাকএন্ডটির README অনুসরণ করে এর নির্ভরতা এবং প্রয়োজনীয় রানটাইম ইনস্টল করুন।
ব্যাকএন্ড গাইডে নির্দিষ্ট করা মূল মডেল, ক্যালিব্রেশন ডেটা এবং আউটপুট ডিরেক্টরি প্রস্তুত করুন।
সঠিক ইনস্টলেশন কমান্ড ব্যাকএন্ড ও মডেল পরিবারের ওপর নির্ভর করে। তাই প্রতিটি ওয়ার্কফ্লোতে একটি সাধারণ ইনস্টলেশন কমান্ড প্রয়োগ না করে লিংক করা README ব্যবহার করুন।
Diffusers দিয়ে জেনারেটিভ মডেল কোয়ান্টাইজ করুন
Diffusers ব্যাকএন্ড diffusion transformer পরিচালনা করে এবং কোয়ান্টাইজ করা safetensors চেকপয়েন্ট সংরক্ষণ করে। এটি ছবি, ভিডিও, image-to-video এবং অডিও জেনারেশন সমর্থন করে।
রিপোজিটরিতে black-forest-labs/FLUX.2-klein-4B, Wan-AI/Wan2.2-TI2V-5B-Diffusers এবং ylacombe/stable-audio-1.0-সহ বিভিন্ন মডেলের ওয়ার্কফ্লো রয়েছে। image-to-video মডেলের ক্ষেত্রে ক্যালিব্রেশনে কন্ডিশনিং ছবি ব্যবহার করা যায়, যাতে কোয়ান্টাইজেশন প্রক্রিয়া নির্ধারিত ইনপুট প্যাটার্ন প্রতিফলিত করে।
Diffusers গাইড খুলে ছবি, ভিডিও অথবা অডিও ওয়ার্কফ্লো বেছে নিন।
একটি নির্দিষ্ট Python 3.12 পরিবেশে ব্যাকএন্ডের প্রয়োজনীয়তা ইনস্টল করুন।
উৎস মডেল ডাউনলোড বা শনাক্ত করুন এবং নির্বাচিত রেসিপিতে প্রয়োজনীয় ক্যালিব্রেশন ইনপুট প্রস্তুত করুন।
W4A4 safetensors চেকপয়েন্ট সংরক্ষণ করতে নথিবদ্ধ কোয়ান্টাইজেশন কমান্ড চালান।
ছবি, ভিডিও অথবা অডিও ফলাফল তৈরি করতে সংশ্লিষ্ট জেনারেশন কমান্ড ব্যবহার করুন।
llama.cpp দিয়ে টেক্সট মডেল কোয়ান্টাইজ করুন
llama.cpp ব্যাকএন্ড টেক্সট জেনারেশনের জন্য কমপ্যাক্ট GGUF ফাইল তৈরি করে। এটি 2-বিট, 3-বিট ও 4-বিট GGUF ফরম্যাট সমর্থন করে এবং ফলাফল মডেল থেকে টেক্সট তৈরির জন্য একটি রানটাইম অন্তর্ভুক্ত করে।
রিপোজিটরিতে Qwen/Qwen3-4B-এর মতো dense মডেল, Qwen/Qwen3.8-27B-এর মতো hybrid মডেল এবং Qwen/Qwen3-30B-A3B ও Qwen/Qwen3-Coder-30B-A3B-Instruct-এর মতো mixture-of-experts মডেলের নির্দেশনা রয়েছে। এতে Qwen3.6-35B-A3B এবং Qwen3.8-Flash-Next-এর রেসিপিও রয়েছে।
স্ট্যান্ডার্ড কোয়ান্টাইজেশন ওয়ার্কফ্লো
llama.cpp গাইড খুলে আপনার মডেল আর্কিটেকচারের সঙ্গে মেলে এমন রেসিপি নির্বাচন করুন।
একটি নির্দিষ্ট Python 3.12 পরিবেশে llama.cpp ব্যাকএন্ড ও এর নির্ভরতাগুলো ইনস্টল করুন।
নির্বাচিত রেসিপিতে বর্ণিত মূল Hugging Face মডেল ও ক্যালিব্রেশন টেক্সট প্রস্তুত করুন।
নথিবদ্ধ MACaQ কোয়ান্টাইজেশন ওয়ার্কফ্লো চালিয়ে GGUF আউটপুট সংরক্ষণ করুন।
টেক্সট তৈরি করতে অন্তর্ভুক্ত রানটাইম অথবা সামঞ্জস্যপূর্ণ llama.cpp ইনস্টলেশন ব্যবহার করুন।
মডেল-নির্দিষ্ট তথ্যের জন্য backend README-এর dense, hybrid, mixture-of-experts, অথবা Flash-Next বিভাগ অনুসরণ করুন। এই রেসিপিগুলো মডেল আর্কিটেকচারের পার্থ্যক্য বিবেচনায় রাখে।
একটি GGUF মডেল চালান
একটি GGUF ফাইল তৈরি হয়ে গেলে, llama.cpp কমান্ড-লাইন ক্লায়েন্ট দিয়ে এটি চালান:
llama cli -m models/model-macaq-r.ggufআপনি llama.cpp-এর মাধ্যমে মডেলটি সার্ভও করতে পারেন:
llama serve -m models/model-macaq-r.ggufMACaQ-R দিয়ে বিদ্যমান GGUF ফাইল পরিমার্জন করুন
MACaQ-R একটি বিদ্যমান quantized GGUF ফাইলের weight code পরিমার্জন করে, এর native format এবং block scale অক্ষুণ্ণ রেখে। ফলে তৈরি ফাইলটি একটি standard llama.cpp installation-এর সঙ্গে সামঞ্জস্যপূর্ণ থাকে।
আপনার কাছে আগে থেকেই একটি quantized model থাকলে এবং GGUF format পরিবর্তন না করে এর মান উন্নত করতে বা নির্দিষ্ট কাজের উপযোগী করতে চাইলে এটি কার্যকর। README-তে Hugging Face-এ একটি Qwen3.6-35B-A3B MACaQ-R model দেওয়া হয়েছে এবং একই তালিকাভুক্ত আকারের তুলনাকৃত Unsloth UD-Q4_K_XL ফাইলের চেয়ে কম KL divergence রিপোর্ট করা হয়েছে।
একটি quantized MoE GGUF পরিমার্জন করতে quantized model, এর সঙ্গে মিলে যাওয়া মূল Hugging Face model, একটি FP16 teacher file, calibration text, একটি output path এবং একটি working directory দিন:
.venv-llamacpp/bin/python llamacpp/macaq.py refine \
  --model models/model-q4.gguf --hf models/original \
  --teacher models/original-f16.gguf --calibration data/calibration.txt \
  --output models/model-macaq-r.gguf --work-dir work/refinement
পরিমার্জন শেষ হলে standard llama.cpp দিয়ে output লোড করুন:
llama cli -m models/model-macaq-r.ggufActivation transform-সহ সম্পূর্ণ MACaQ workflow-এর জন্য bundled-runtime guide ব্যবহার করুন।
vLLM দিয়ে মডেল quantize ও serve করুন
vLLM backend generation বা HTTP serving-এর জন্য compact text-model checkpoint তৈরি করে। W4A4 হলো default inference mode, এবং backend weight-only quantization-ও সমর্থন করে।
vLLM guide খুলে hybrid text model অথবা text mixture-of-experts model-এর workflow বেছে নিন।
নিজস্ব Python 3.12 environment-এ vLLM backend ইনস্টল করুন।
নির্বাচিত recipe-তে প্রয়োজনীয় source model এবং calibration data প্রস্তুত করুন।
compact checkpoint তৈরি করতে নথিভুক্ত quantization command চালান।
স্থানীয় generation-এর জন্য checkpoint লোড করুন অথবা নথিভুক্ত HTTP server চালু করুন।
README-তে একটি Qwen3.8-27B তুলনা দেওয়া হয়েছে, যেখানে MACaQ W4A4-এর perplexity 2.8994, আর BF16-এর 2.8463; একই সঙ্গে তালিকাভুক্ত test setup-এ দ্রুততর prefill ও decode measurement রিপোর্ট করা হয়েছে।
PyTorch দিয়ে speech generator quantize করুন
PyTorch backend speech generation-এর জন্য তৈরি এবং W4A4 checkpoint সংরক্ষণ করে। একটি checkpoint সংরক্ষিত হলে calibration পুনরায় না করেই তা লোড করা যায়।
নথিভুক্ত workflow-গুলো Qwen3-TTS এবং Chatterbox Turbo কভার করে।
PyTorch guide খুলে speech model বেছে নিন।
আলাদা Python 3.12 environment-এ প্রয়োজনীয় PyTorch dependency ইনস্টল করুন।
মডেল-নির্দিষ্ট নির্দেশনা অনুসরণ করে calibration ও quantization চালান।
W4A4 checkpoint সংরক্ষণ করুন।
সংরক্ষিত checkpoint লোড করে পুনরায় calibration না করে WAV audio তৈরি করুন।
Ascend hardware-এর সঙ্গে MACaQ ব্যবহার করুন
MACaQ W4A4 dense এবং grouped matrix multiplication kernel CANN-সম্পর্কিত pull request-এর মাধ্যমে পাওয়া যায়। README-তে ops-nn pull request 12568-এ PTO-ISA kernel এবং ops-tilelang pull request 44-এ CCE backend-সহ TileLang kernel-এর উল্লেখ রয়েছে।
সামঞ্জস্যপূর্ণ CANN, PyTorch এবং torch_npu version-এর জন্য ওই project-গুলোর build instruction অনুসরণ করুন। সম্পূর্ণ model execution-এর জন্য Ascend inference runtime-এর সঙ্গে integration প্রয়োজন।
আরও ভালো workflow-এর জন্য ব্যবহারিক পরামর্শ
- Deployment target অনুযায়ী backend বেছে নিন। Portable local text inference-এর জন্য GGUF ও llama.cpp, text serving-এর জন্য vLLM, multimodal generation-এর জন্য Diffusers এবং speech model-এর জন্য PyTorch বেছে নিন।
- মডেল-নির্দিষ্ট recipe ব্যবহার করুন। Dense, hybrid এবং mixture-of-experts model-এর জন্য ভিন্ন preparation ও quantization step প্রয়োজন হতে পারে।
- Calibration data ব্যবহারের সঙ্গে সামঞ্জস্যপূর্ণ রাখুন। উদাহরণস্বরূপ, Diffusers-এর image-to-video workflow calibration-এর সময় conditioning image ব্যবহার করে।
- Environment আলাদা রাখুন। README প্রতিটি backend-এর জন্য আলাদা environment এবং Python 3.12 ব্যবহারের সুপারিশ করে।
- শুধু file size নয়, quality-ও তুলনা করুন। Quantized model-কে FP16 বা অন্যান্য quantization method-এর সঙ্গে মূল্যায়ন করতে project-টি perplexity এবং KL divergence তুলনা ব্যবহার করে।
- আপনার কাছে আগে থেকেই GGUF থাকলে MACaQ-R ব্যবহার করুন। এটি standard llama.cpp compatibility বজায় রেখে বিদ্যমান quantized file পরিমার্জন করতে পারে।
উপসংহার
MACaQ একাধিক AI ওয়ার্কলোডে একটি কোয়ান্টাইজেশন পদ্ধতি প্রদান করে, যার মধ্যে রয়েছে GGUF টেক্সট মডেল, Diffusers-এর ছবি, ভিডিও ও অডিও মডেল, vLLM সার্ভিং চেকপয়েন্ট এবং PyTorch স্পিচ জেনারেটর। ব্যাকএন্ড-নির্দিষ্ট README দিয়ে শুরু করুন, বিচ্ছিন্ন পরিবেশে Python 3.12 ব্যবহার করুন, ক্যালিব্রেশনের জন্য মডেল রেসিপি অনুসরণ করুন এবং আপনার নির্ধারিত রানটাইম দিয়ে তৈরি চেকপয়েন্ট যাচাই করুন।
গবেষণা বা প্রযুক্তিগত ডকুমেন্টেশনের জন্য MACaQ পেপার দেখুন। প্রকল্পটি Apache License 2.0-এর অধীনে প্রকাশিত।