

DeepSelect কী?
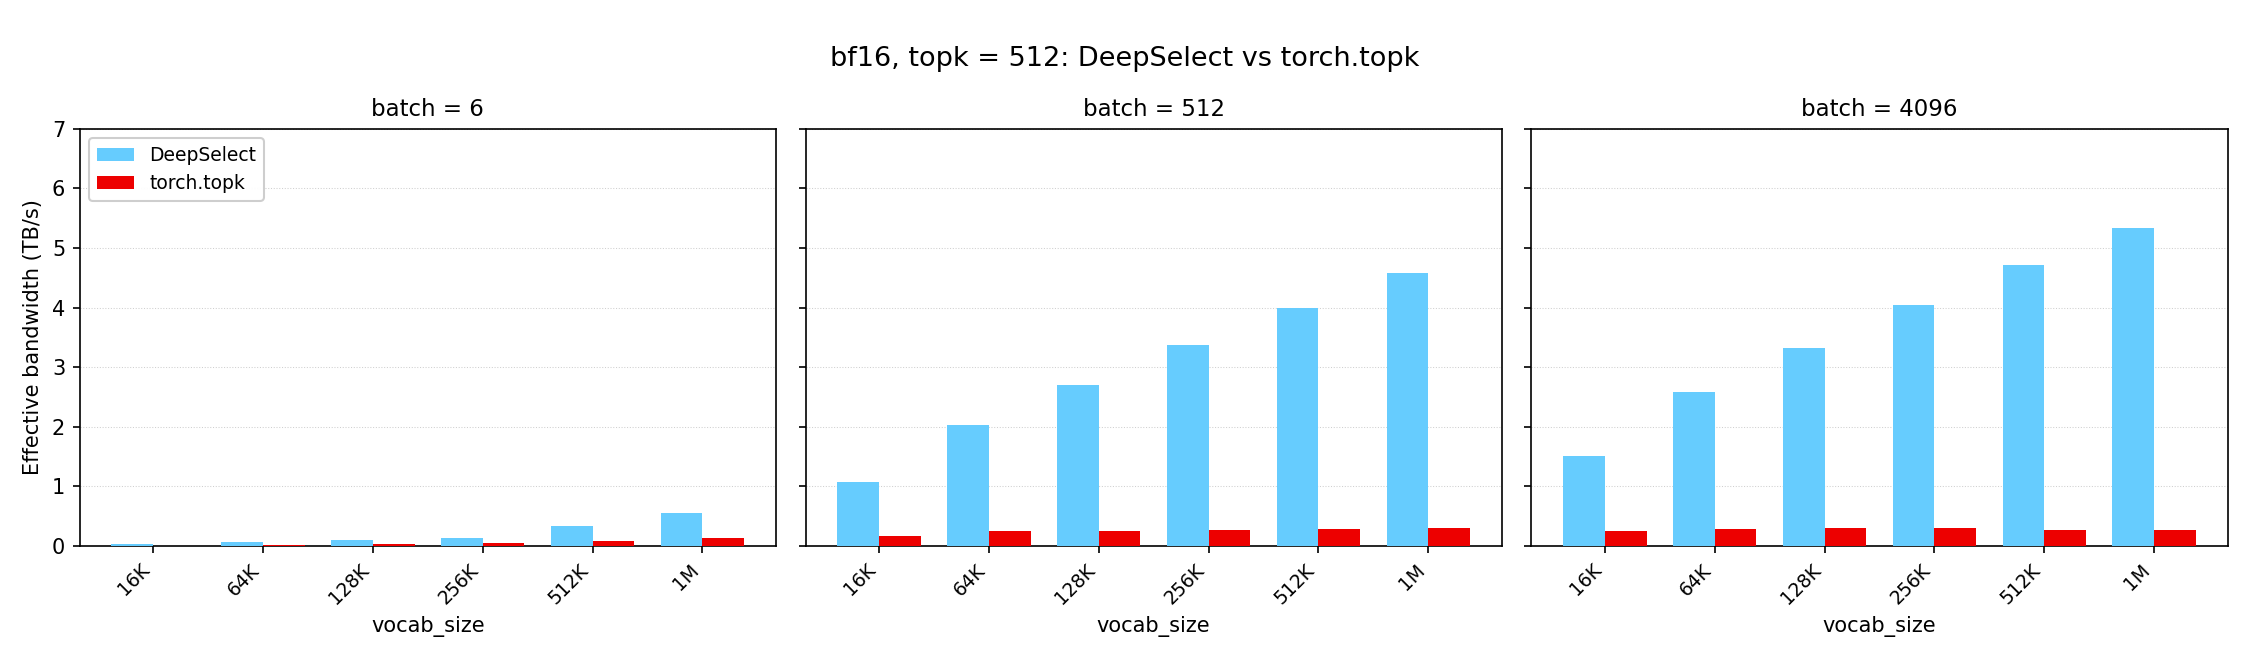
DeepSelect হলো DeepSeek Sparse Attention এবং sampling-এ ব্যবহৃত TopK kernel-এর একটি উচ্চ-পারফরম্যান্স বাস্তবায়ন। প্রকল্পের README অনুযায়ী, লাইব্রেরি সমর্থিত workload-গুলোর ক্ষেত্রে এটি সাধারণ torch.topk-এর তুলনায় 2–20x গতি বৃদ্ধি দিতে পারে।
সম্ভাব্য প্রতিটি TopK configuration অপ্টিমাইজ করার চেষ্টা না করে DeepSelect দুটি পরিস্থিতিতে মনোযোগ দেয়: torch.bfloat16 input ব্যবহার করা Lightning Indexer workload এবং torch.float32 input ব্যবহার করা sampling workload।
সমর্থিত Workload
Lightning Indexer পরিস্থিতি
- Input type:
torch.bfloat16 - Batch size: 1 থেকে শুরু করে যেকোনো মান; ছোট ও বড় উভয় batch-এর জন্য অপ্টিমাইজেশন রয়েছে
- Vocabulary size: 1 থেকে শুরু করে যেকোনো মান; ছোট ও বড় উভয় vocabulary-এর জন্য অপ্টিমাইজেশন রয়েছে
- TopK size: ছোট এবং
4096-এর বেশি নয়
ভালো পারফরম্যান্সের জন্য ফলাফল সাজানো আবশ্যক না হলে sorted_index নিষ্ক্রিয় রাখুন। Values-এর প্রয়োজন না থাকলে সেগুলোর output এড়াতে return_value=False সেট করুন।
Sampling পরিস্থিতি
- Input type:
torch.float32 - Batch size: 1 থেকে শুরু করে যেকোনো মান
- Vocabulary size: প্রায় 128K
- TopK size: ছোট এবং
4096-এর বেশি নয়
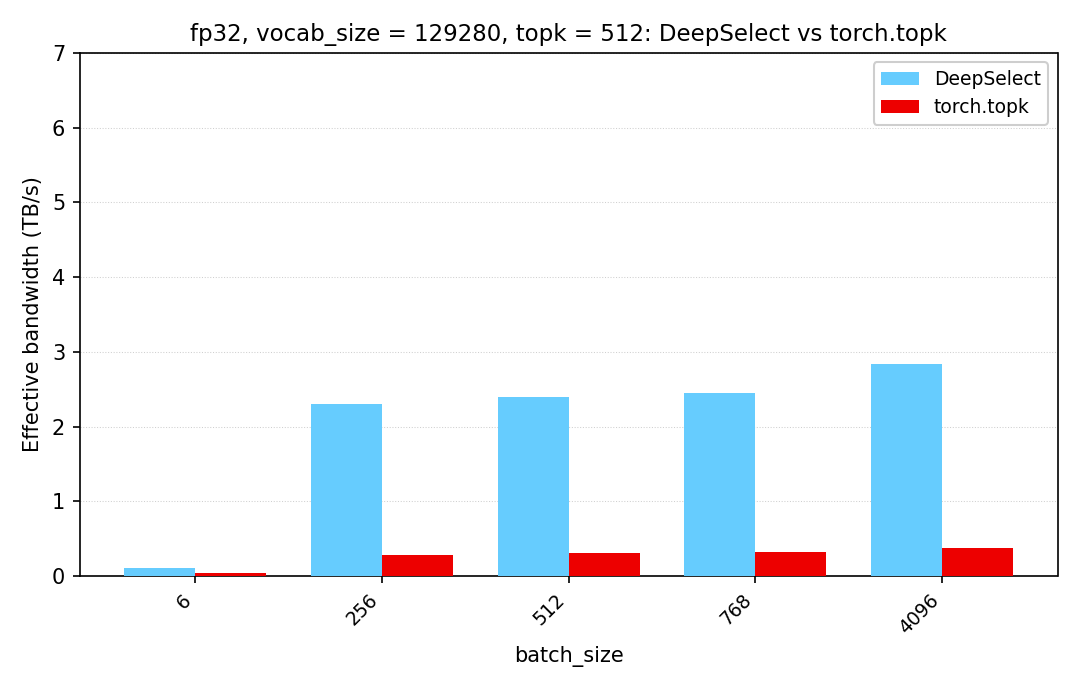
TopK floating-point arithmetic সম্পাদন করে না বলে repository floating-point throughput-এর পরিবর্তে effective memory bandwidth ব্যবহার করে পারফরম্যান্স পরিমাপ করে। এর benchmark একই input-এর ওপর torch.topk-এর তুলনায় পারফরম্যান্সের প্রতিবেদন দেয়।
প্রধান বৈশিষ্ট্য
- DeepSeek Sparse Attention এবং sampling workload-এর জন্য বিশেষায়িত TopK kernel
- নিজ নিজ target scenario-তে
torch.bfloat16এবংtorch.float32input-এর সমর্থন - কনফিগারযোগ্য
torch.int32বাtorch.int64index output - শুধু index প্রয়োজন হলে কম overhead-এর জন্য ঐচ্ছিক value output
- প্রতি-row exclusive upper bound-এর মাধ্যমে পরিবর্তনশীল দৈর্ঘ্যের row
- Index-এর জন্য ব্যবহারকারীর নিয়ন্ত্রিত output buffer
- অন্তর্নির্মিত NaN checking
ইনস্টলেশন
Repository clone করুন, এর submodule initialize করুন এবং project directory থেকে package ইনস্টল করুন:
git clone https://github.com/deepseek-ai/DeepSelect.git
cd DeepSelect
git submodule update --init --recursive
pip install -v .
উদাহরণগুলো CUDA tensor ব্যবহার করে, তাই device="cuda"-এ input তৈরি করুন।
মৌলিক TopK ব্যবহার
PyTorch এবং DeepSelect import করুন, একটি দ্বি-মাত্রিক input tensor তৈরি করুন এবং deep_select.topk কল করুন:
import torch
import deep_select

batch_size = 4
vocab_size = 204800
topk = 1024

x = torch.randn(
    batch_size,
    vocab_size,
    dtype=torch.bfloat16,
    device="cuda",
)

values, indices = deep_select.topk(
    x,
    topk,
    sorted_index=True,
    indices_type=torch.int32,
    return_value=True,
)

print(values.shape)   # (4, 1024)
print(indices.shape)  # (4, 1024)
Input-এর shape অবশ্যই (batch_size, vocab_size) হতে হবে। এর শেষ dimension contiguous হতে হবে এবং row stride deep_select.get_stride_requirement()[0] bytes-এর গুণিতক হতে হবে।
ফেরত দেওয়া values-এর data type x-এর মতোই হয়। indices_type-এর মাধ্যমে index-এর type নির্বাচন করা হয়, যা torch.int32 বা torch.int64 হতে পারে। sorted_index=True হলে প্রতিটি row-এর ফেরত দেওয়া index ascending order-এ সাজানো থাকে।
শুধু index ফেরত দেওয়া
পরবর্তী code-এ নির্বাচিত values-এর প্রয়োজন না থাকলে value output নিষ্ক্রিয় করুন:
values, indices = deep_select.topk(
    x,
    topk,
    sorted_index=False,
    indices_type=torch.int32,
    return_value=False,
)
README-তে উল্লেখ করা হয়েছে যে value output বাদ দিলে পারফরম্যান্স প্রায় 10% দ্রুত হয়। Sorting overhead যোগ করে বলে ordering প্রয়োজন না হলে sorted output চাওয়া এড়িয়ে চলুন।
Stride Alignment পরিচালনা
DeepSelect input row এবং output row-এর ওপর alignment-এর প্রয়োজনীয়তা আরোপ করে। Runtime-এ এগুলো দেখুন:
input_alignment, output_alignment = deep_select.get_stride_requirement()

print("Input row-stride alignment:", input_alignment, "bytes")
print("Output row-stride alignment:", output_alignment, "bytes")
কোনো input-এর row stride প্রয়োজনীয় input alignment-এর গুণিতক না হলে DeepSelect-এ পাঠানোর আগে tensor-এ padding যোগ করুন। শেষ dimension-টি contiguous থাকতে হবে।
DeepSelect ডিফল্টভাবে উভয় output বরাদ্দ করে। তাদের stride deep_select.get_stride_requirement()[1] bytes-এ aligned থাকে, যার ফলে ফেরত দেওয়া tensor non-contiguous হতে পারে। Output ব্যবহারকারী code-এর standard contiguous stride ধরে নেওয়া উচিত নয়।
বিদ্যমান index buffer ব্যবহার
Index caller-পরিচালিত কোনো buffer-এ লিখতে হলে API output_idx= গ্রহণ করে। সেই buffer-কে একই output stride requirement পূরণ করতে হবে। Custom buffer কনফিগার করার আগে সম্পূর্ণ function signature-এর জন্য deep_select/interface.py দেখুন।
পরিবর্তনশীল দৈর্ঘ্যের Row নিয়ে কাজ
প্রতিটি row-এর exclusive upper bound নির্ধারণ করতে end ব্যবহার করুন। একই batch-এর row-গুলোতে ভিন্ন valid length থাকলে এটি কার্যকর:
import torch
import deep_select

batch_size = 2
vocab_size = 129280

x = torch.randn(
    batch_size,
    vocab_size,
    dtype=torch.float32,
    device="cuda",
)

end = torch.tensor(
    [129280, 100000],
    dtype=torch.int32,
    device="cuda",
)

values, indices = deep_select.topk(
    x,
    1000,
    end=end,
    sorted=True,
    indices_type=torch.int64,
)
এখানে, প্রথম সারি 129280টি উপাদানই ব্যবহার করতে পারে, আর দ্বিতীয় সারিটি প্রথম 100000টি উপাদানের মধ্যে সীমাবদ্ধ। কোনো সারি অনুরোধ করা TopK আকারের চেয়ে ছোট হলে, DeepSelect তার আউটপুটে value_oob_fill_value এবং idx_oob_fill_value দিয়ে প্যাড করে।
NaN পরিচালনা
NaN পরীক্ষা সবসময় সক্রিয় থাকে। ডিফল্টভাবে, abort_when_nan_found=True থাকায় কার্নেল কোনো NaN শনাক্ত করলে trap() কল করে এবং বন্ধ হয়ে যায়। যেসব সারির বৈধ দৈর্ঘ্য অনুরোধ করা TopK আকারের চেয়ে কম বা সমান, সেগুলোতে NaN পরীক্ষা করা হয় না।
NaN থাকার সম্ভাবনা থাকলে, বিশেষ করে ডিফল্ট abort আচরণ বজায় রাখার সময়, কার্নেল চালুর আগে ইনপুট ডেটা যাচাই বা পরিশোধন করুন।
পারফরম্যান্স ও উন্নত টিপস
- সমর্থিত TopK সীমার মধ্যে থাকুন। DeepSelect সর্বোচ্চ
4096পর্যন্ত ছোট TopK মান সমর্থন করে। এর চেয়ে বড় মান সমর্থিত নয়। - উদ্দেশ্যপ্রসূত কাজের ধরন অনুযায়ী নির্বাচন করুন। Lightning Indexer পরিস্থিতির জন্য
torch.bfloat16এবং প্রকল্পে বর্ণিত sampling পরিস্থিতির জন্যtorch.float32ব্যবহার করুন। - সম্ভব হলে sorting এড়িয়ে চলুন। ইনডেক্স বা মান অনুযায়ী ক্রম সাজাতে পারফরম্যান্স খরচ হয়, তাই downstream প্রক্রিয়াকরণে প্রয়োজন হলেই এটি অনুরোধ করুন।
- সম্ভব হলে মান এড়িয়ে চলুন। শুধু ইনডেক্স ব্যবহার করা হলে
return_value=Falseসেট করুন। - শুরুতেই alignment পরীক্ষা করুন। পারফরম্যান্স-সংবেদনশীল লুপে অসামঞ্জস্যপূর্ণ টেনসর ঠিক করার পরিবর্তে
get_stride_requirement()-এর চারপাশে টেনসরের আকৃতি ও padding পরিকল্পনা করুন। - আউটপুট contiguous হবে ধরে নেবেন না। DeepSelect আউটপুট সারির stride সমন্বয় করে, ফলে তৈরি টেনসর non-contiguous হতে পারে।
- বাস্তব আকৃতি দিয়ে benchmark করুন। TopK-এর পারফরম্যান্স ইনপুটের ধরন, batch size, vocabulary size এবং TopK আকারের ওপর নির্ভর করে। অ্যাপ্লিকেশনে ব্যবহৃত সঠিক কনফিগারেশন পরীক্ষা করুন।
সরবরাহ করা benchmark চালানো
রিপোজিটরির test script-এ একটি performance mode রয়েছে:
python3 tests/test.py --perf-onlyএই benchmark একই ইনপুটে DeepSelect-এর সঙ্গে torch.topk-এর তুলনা করে এবং কার্যকর memory bandwidth ব্যবহার করে অনুপাত দেখায়।
উপসংহার
DeepSelect সামঞ্জস্যপূর্ণ DeepSeek Sparse Attention এবং sampling workload-এর জন্য বিশেষায়িত TopK কার্নেল সরবরাহ করে। alignment-করা দ্বিমাত্রিক CUDA টেনসর দিয়ে শুরু করুন, topk সর্বোচ্চ 4096-এর মধ্যে রাখুন এবং অপ্রয়োজনীয় হলে sorting বা value output বন্ধ করুন। production integration-এর জন্য stride-এর প্রয়োজনীয়তা যাচাই করুন, সম্ভাব্য non-contiguous output বিবেচনায় রাখুন এবং আপনার অ্যাপ্লিকেশনে ব্যবহৃত সঠিক টেনসরের আকৃতি দিয়ে benchmark করুন।