

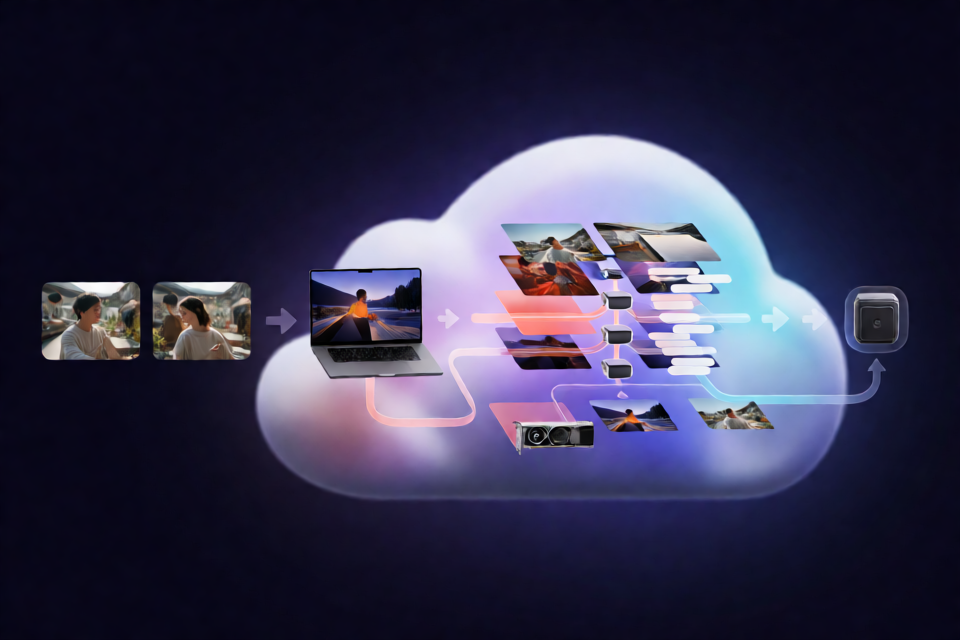
এই প্রকল্পটি কী করে
MiniMax H3 Ref2VA LoRA Colab Skill হলো একটি ইনস্টলযোগ্য Codex skill, যা জোড়া ইমেজ ডেটাসেট প্রস্তুত এবং Google Colab-এ একটি MiniMax H3 Ref2VA LoRA প্রশিক্ষণের জন্য ব্যবহৃত হয়। এর runner স্থানীয় ছবি সংগঠিত করে, ডেটাসেট প্যাকেজ করে, সংযুক্ত Colab notebook চালু করে, checkpoint ও run artifact Google Drive-এ সংরক্ষণ করে এবং চূড়ান্ত .safetensors adapter আপনার কম্পিউটারে ডাউনলোড করে।
এই workflow বিশেষভাবে MiniMax H3 transformer-এর জন্য তৈরি। H3 তার image-understanding pipeline-এর ভেতরে Qwen3-VL ব্যবহার করে, তবে Qwen Image একটি আলাদা model। Qwen Image LoRA, H3 adapter-এর সঙ্গে সামঞ্জস্যপূর্ণ নয়।
প্রধান বৈশিষ্ট্য
- জোড়া target এবং reference/control image dataset তৈরি করে।
- উপলব্ধ থাকলে একই basename-এর caption file ব্যবহার করে।
- পুনরুৎপাদনযোগ্য caption ও reference নির্বাচন-এর জন্য JSON dataset plan সমর্থন করে।
- Google Colab-এ Ostris AI Toolkit-এর মাধ্যমে MiniMax H3 Ref2VA LoRA training চালায়।
- প্রশিক্ষণের ধাপ, LoRA rank, alpha, learning rate, GPU type এবং high-memory request কনফিগার করার সুবিধা দেয়।
- Checkpoint, sample, configuration এবং run summary Google Drive-এর সঙ্গে সিঙ্ক্রোনাইজ করে।
- চূড়ান্ত
.safetensorsadapter স্থানীয় output directory-তে ডাউনলোড করে। - Colab compute balance পরীক্ষা এবং remote runtime connectivity যাচাই করার command প্রদান করে।
পূর্বশর্ত
Skill ইনস্টল করার আগে নিশ্চিত করুন যে আপনার স্থানীয় সিস্টেমে রয়েছে:
- Python 3.10 বা পরবর্তী সংস্করণ।
- Remote command চালানোর আগে ইনস্টল ও authenticated করা Google Colab CLI।
- GPU hardware ব্যবহারের অনুমতিসম্পন্ন একটি Colab account।
- প্রয়োজনীয় H3 model ও training-adapter asset ব্যবহারের access, যার মধ্যে প্রযোজ্য license গ্রহণও অন্তর্ভুক্ত।
- নির্ধারিত training run-এর জন্য পর্যাপ্ত Colab compute।
সংযুক্ত notebook অন্তত 60 GiB খালি disk space পরীক্ষা করে এবং GPU VRAM 48 GiB-এর কম হলে সতর্ক করে। প্রকল্পটি high-memory A100 ব্যবহারের পরামর্শ দেয়, যদিও official minimum-VRAM guarantee নেই।
Codex Skill ইনস্টল করুন
Repository clone করে installer চালান:
git clone https://github.com/killkli/minimax-h3-lora-colab-skill.git
cd minimax-h3-lora-colab-skill
./install.sh
CODEX_HOME সেট করা থাকলে installer skill-টি $CODEX_HOME/skills-এর অধীনে স্থাপন করে। অন্যথায় এটি ~/.codex/skills ব্যবহার করে।
অন্য skills directory-তে ইনস্টল করতে --dest দিন:
./install.sh --dest /path/to/skillsডিফল্টভাবে বিদ্যমান installation সংরক্ষিত থাকে। ইচ্ছাকৃতভাবে কোনো installation প্রতিস্থাপন করতে --force ব্যবহার করুন। Installer আগের copy নিঃশব্দে মুছে না ফেলে timestamp-যুক্ত backup-এ সরিয়ে রাখে।
Installation যাচাই করুন
Colab job চালু না করে runner-এর help দেখুন:
python3 ~/.codex/skills/minimax-h3-lora-colab/scripts/runner.py --helpCODEX_HOME কনফিগার করা থাকলে ~/.codex/skills-এর পরিবর্তে $CODEX_HOME/skills ব্যবহার করুন। স্থানীয় installation এবং help check training শুরু করে না বা Colab GPU time ব্যবহার করে না।
আপনার Training Image প্রস্তুত করুন
Target photo-গুলো একটি directory-তে রাখুন। ছবিগুলোতে একই ব্যক্তি বা subject থাকা উচিত। চাইলে matching basename-যুক্ত text file হিসেবে caption যোগ করতে পারেন। উদাহরণস্বরূপ, photo01.jpg-এর caption photo01.txt-এ রাখা যেতে পারে।
Clone করা repository থেকে dataset প্রস্তুত করুন:
python3 scripts/runner.py prepare \
  --input-dir /path/to/target_photos \
  --name studio_subject \
  --trigger "studio_subject person" \
  --output-dir ./prepared_dataset
প্রস্তুত directory-তে থাকবে:
prepared_dataset/
├── targets/
├── references/
└── dataset_manifest.jsontargets/-এ target image এবং সেগুলোর একই basename-এর caption file থাকে।references/-এ target-এর সঙ্গে basename মেলানো reference বা control image থাকে।dataset_manifest.jsonপ্রতিটি sample-এর source, target, reference এবং caption সংরক্ষণ করে।
Dataset preparation স্থানীয়ভাবে হয়। এটি মূল ছবিগুলো prepared dataset-এ copy করে, তবে Colab-এ upload করে না।
স্বয়ংক্রিয়ভাবে Reference নির্বাচন করুন
আলাদা reference folder না দিলে runner-এর অন্তত দুটি target photo প্রয়োজন। Reference pairing তৈরি করতে এটি ওই ছবিগুলোর মধ্যে পর্যায়ক্রমে ঘুরে কাজ করে।
সম্ভব হলে একই subject-এর বৈচিত্র্যময় ও কার্যকর view ব্যবহার করুন। কোনো target-এর reference হিসেবে সেই target নিজেকে ব্যবহার করা উচিত নয়।
আলাদা Reference Folder ব্যবহার করুন
অন্য directory থেকে reference নির্বাচন করতে --reference-dir যোগ করুন:
python3 scripts/runner.py prepare \
  --input-dir /path/to/target_photos \
  --reference-dir /path/to/reference_photos \
  --name studio_subject \
  --trigger "studio_subject person" \
  --output-dir ./prepared_dataset
নির্বাচিত প্রতিটি reference-এ target set-এর একই subject থাকা আবশ্যক। বৃহত্তর collection-এর কেবল একটি অংশ বাছাই করলে নির্বাচিত target ও reference staging folder-এ রাখুন এবং মূল image collection অপরিবর্তিত রাখুন।
পুনরুৎপাদনযোগ্য Dataset Plan তৈরি করুন
Dataset plan-এ প্রতিটি image-এর caption এবং ঐচ্ছিক target-to-reference নির্বাচন সংরক্ষিত থাকে। এর ফলে manual বা agent-assisted curation পুনরুৎপাদনযোগ্য হয়।
{
  "captions": {
    "photo01.jpg": "studio_subject person, waist-up portrait in a blue jacket, outdoors in soft daylight",
    "photo02.jpg": "studio_subject person, side profile wearing a white shirt, indoors by a window"
  },
  "references": {
    "photo01.jpg": "front_reference.png",
    "photo02.jpg": "side_reference.png"
  }
}
captions অবজেক্টে প্রতিটি টার্গেট ছবির বেসনেম অন্তর্ভুক্ত থাকতে হবে। ঐচ্ছিক references অবজেক্টটি উপস্থিত থাকলে, এটিতে প্রতিটি টার্গেট বেসনেমকে প্রার্থী রেফারেন্স ডিরেক্টরির একটি ছবি বেসনেমের সঙ্গে ম্যাপ করতে হবে।
ক্যাপশনে শুধু দৃশ্যমান বিবরণ উল্লেখ করুন। সম্পর্কহীন ব্যক্তি বা বিষয়গুলো আলাদা ডেটাসেটে রাখুন এবং কোনো টার্গেট ছবিকে নিজের সঙ্গেই ম্যাপ করবেন না।
নিচের পরিকল্পনা অনুযায়ী ডেটাসেট প্রস্তুত করুন:
python3 scripts/runner.py prepare \
  --input-dir /path/to/target_photos \
  --reference-dir /path/to/reference_photos \
  --dataset-plan /path/to/dataset-plan.json \
  --name studio_subject \
  --trigger "studio_subject person" \
  --output-dir ./prepared_dataset
--dataset-plan বাদ দিলে runner বিদ্যমান সাইডকার ক্যাপশন ব্যবহার করে এবং অনুপস্থিত ক্যাপশনের জন্য একটি সরল ডিফল্ট সরবরাহ করে।
আপলোডের আগে পর্যালোচনা করুন
প্রশিক্ষণের আগে dataset_manifest.json খুলে প্রতিটি সোর্স, টার্গেট, রেফারেন্স এবং ক্যাপশন যাচাই করুন। ভুল জোড়া, অনুপস্থিত বিবরণ বা ভিন্ন বিষয়ের ছবি শনাক্ত করার জন্য এটিই সেরা সময়। প্রশিক্ষণের ধাপেই প্রস্তুত ছবিগুলো Colab রানটাইমে আপলোড করা হয়।
Google Colab-এ LoRA প্রশিক্ষণ দিন
প্রস্তুত ডেটাসেট পর্যালোচনা করার পর একটি প্রশিক্ষণ রান শুরু করুন:
python3 scripts/runner.py train \
  --dataset-dir ./prepared_dataset \
  --name studio_subject \
  --trigger "studio_subject person" \
  --steps 1000 \
  --rank 16 \
  --alpha 16 \
  --gpu A100 \
  --output-dir ./outputs
ডিফল্ট প্রশিক্ষণ সেটিংস হলো:
- ১,০০০টি প্রশিক্ষণ ধাপ।
- LoRA র্যাঙ্ক ১৬।
- আলফা ১৬।
- লার্নিং রেট
1e-4। - উচ্চ-মেমরি A100 Colab সেশন।
নোটবুকটি H3 মডেল এবং প্রয়োজনীয় প্রশিক্ষণ-অ্যাডাপ্টার অ্যাসেট ডাউনলোড করে। চূড়ান্ত অ্যাডাপ্টারটি ./outputs/-এ একটি .safetensors ফাইল হিসেবে রাখা হয়।
রানের আর্টিফ্যাক্টগুলোও এখানে সিঙ্ক্রোনাইজ করা হয়:
MyDrive/MiniMax_H3_LoRAs/<name>/<run-id>/Drive ডিরেক্টরিতে চেকপয়েন্ট, তৈরি করা নমুনা, কনফিগারেশন ডেটা এবং রান সারাংশ থাকে।
প্রশিক্ষণ প্যারামিটার সাবধানে পরিবর্তন করুন
ধাপ, র্যাঙ্ক, আলফা, GPU এবং আউটপুট ডিরেক্টরির উদাহরণ মানগুলো পরিবর্তন করতে পারেন। সমর্থিত সব প্রশিক্ষণ অপশন দেখতে চালান:
python3 scripts/runner.py train --helpডিফল্টভাবে উচ্চ-মেমরি মোডের অনুরোধ করা হয়। নির্বাচিত Colab GPU বরাদ্দে এই অনুরোধ বাদ দিতে হলে --no-high-mem যোগ করুন।
Colab ব্যবহার ও সংযোগ পরীক্ষা করুন
বর্তমান Colab কম্পিউট ব্যালান্স JSON আকারে পড়তে ব্যবহার করুন:
python3 scripts/runner.py usage --jsonরিমোট GPU রানটাইম তৈরি করে probe, ফাইল স্থানান্তর এবং Google Drive পাথ যাচাই করতে চালান:
python3 scripts/runner.py test
testকমান্ডটি প্রশিক্ষণ যাচাই করে না। এটি প্রমাণ করে না যে MiniMax H3 প্রশিক্ষণ উপলব্ধ VRAM-এ চলবে বা সফলভাবে সম্পন্ন হবে।
উন্নত টিপস ও পরিচালনামূলক নির্দেশনা
বিষয়ের সেট সংক্ষিপ্ত রাখুন
প্রতি ডেটাসেটে একজন ব্যক্তি বা একটি বিষয়ের ছবি ব্যবহার করুন। সম্পর্কহীন বিষয় আলাদা রাখলে ক্যাপশন ও রেফারেন্স ম্যাপিং আরও স্পষ্ট হয় এবং runner-এর প্রত্যাশিত ওয়ার্কফ্লো অনুসরণ করা যায়।
ছবিভিত্তিক ক্যাপশন ব্যবহার করুন
শুধু সাধারণ ক্যাপশনের ওপর নির্ভর না করে ভঙ্গি, পোশাক, ফ্রেমিং, পরিবেশ এবং আলোসহ দৃশ্যমান বৈশিষ্ট্য বর্ণনা করুন। নির্বাচিত ট্রিগারটি ধারাবাহিকভাবে অন্তর্ভুক্ত করুন, তবে ছবিতে দেখা যায় না এমন বিবরণ যোগ করবেন না।
কার্যকর রেফারেন্স বৈচিত্র্যকে অগ্রাধিকার দিন
একই বিষয়কে দেখায়, তবে বিভিন্ন দৃষ্টিভঙ্গি দেয় এমন রেফারেন্স বেছে নিন। উদাহরণস্বরূপ, উপযুক্ত ক্ষেত্রে সামনের দিকের ও পাশের প্রোফাইলের দৃশ্য জোড়া দিন। কোনো টার্গেটকে কখনো নিজের সঙ্গেই জোড়া দেবেন না।
পর্যালোচনাযোগ্য রেকর্ড সংরক্ষণ করুন
প্রকল্পের সঙ্গে ডেটাসেট প্ল্যান এবং তৈরি করা ম্যানিফেস্ট রাখুন। এগুলো একসঙ্গে কোনো রানে ব্যবহৃত ক্যাপশন ও জোড়াগুলো নথিবদ্ধ করে এবং প্রস্তুতি প্রক্রিয়া নিরীক্ষা বা পুনরাবৃত্তি করা সহজ করে।
স্থানীয় ও ক্লাউড আউটপুট পর্যবেক্ষণ করুন
স্থানীয় আউটপুট ডিরেক্টরিতে ডাউনলোড করা চূড়ান্ত অ্যাডাপ্টার থাকে, আর Google Drive-এ বিস্তৃত রান আর্টিফ্যাক্ট সংরক্ষিত থাকে। প্রশিক্ষণ রান অপ্রত্যাশিতভাবে বন্ধ হলে চেকপয়েন্ট, নমুনা, কনফিগারেশন এবং রান সারাংশ পরিদর্শন করতে Drive-এর কপি ব্যবহার করুন।
হার্ডওয়্যার সামঞ্জস্য রানটাইম-নির্ভর হিসেবে বিবেচনা করুন
প্রস্তাবিত উচ্চ-মেমরি A100 সফলতার নিশ্চয়তা দেয় না। প্রকৃত মেমরি সামঞ্জস্য Colab রানটাইম ও প্রশিক্ষণ কনফিগারেশনের ওপর নির্ভর করে। নোটবুকটি ৪৮ GiB VRAM-এর নিচে সতর্ক করে এবং ৬০ GiB ফ্রি ডিস্ক পরীক্ষা করে, তবে এগুলো কোনো আনুষ্ঠানিক হার্ডওয়্যার নিশ্চয়তা নয়।
যাচাইয়ের অবস্থা বুঝুন
আপস্ট্রিম AI Toolkit Ref2VA উদাহরণ কনফিগারেশনটি যাচাই করা হয়নি হিসেবে চিহ্নিত। তাই রিপোজিটরিটি দাবি করে না যে প্রতিটি ক্লাউড প্রশিক্ষণ রান সফল হবে। পুনরুৎপাদনযোগ্যতার জন্য নোটবুকটি পরিদর্শিত AI Toolkit সোর্স কমিট নির্দিষ্ট করে, তবে সফল ইনস্টলেশন বা রিমোট probe-কে শুরু থেকে শেষ পর্যন্ত প্রশিক্ষণ সম্পন্ন হওয়ার প্রমাণ হিসেবে বিবেচনা করা উচিত নয়।
আরও পড়ুন
- MiniMax H3 মডেল আর্কিটেকচার
- Ostris AI Toolkit MiniMax-H3 Ref2VA ডকুমেন্টেশন
- নির্দিষ্ট AI Toolkit H3 ইমপ্লিমেন্টেশন
উপসংহার
MiniMax H3 Ref2VA LoRA Colab Skill স্থানীয় ছবি বাছাই থেকে ডাউনলোডযোগ্য H3 অ্যাডাপ্টার তৈরি পর্যন্ত একটি পুনরাবৃত্তিযোগ্য পদ্ধতি দেয়। স্থানীয়ভাবে লক্ষ্য-রেফারেন্স জোড়া প্রস্তুত ও পর্যালোচনা করুন, পুনরুৎপাদনযোগ্য ক্যাপশন ও ম্যাপিং প্রয়োজন হলে ডেটাসেট পরিকল্পনা ব্যবহার করুন, আপনার Colab রিসোর্স ও লাইসেন্স নিশ্চিত করুন, তারপর প্রশিক্ষণ শুরু করুন। মনে রাখবেন, আপস্ট্রিম কনফিগারেশনটি এখনও যাচাই করা হয়নি এবং Qwen Image LoRA-কে MiniMax H3 অ্যাডাপ্টারের সঙ্গে বিনিময়যোগ্যভাবে ব্যবহার করা যায় না।