

ছোট ক্লাসিফায়ার কী করে
tiny-classifiers হলো ছোট, নির্দিষ্ট কাজের জন্য তৈরি টেক্সট ক্লাসিফায়ার প্রশিক্ষণের একটি ব্যবহারিক রেসিপি। এটি ১৭ মিলিয়ন প্যারামিটারের Ettin-17M এনকোডার ব্যবহার করে, এর সব ওজন ফাইন-টিউন করে এবং ফলাফলকে একটি স্ট্যান্ডার্ড Hugging Face মডেল হিসেবে সংরক্ষণ করে।
প্রকল্পটি ব্যাংকিং বার্তা রাউটিং, সংবাদ শ্রেণিবদ্ধকরণ, ব্যবহারকারীর অভিপ্রায় শনাক্তকরণ, সেন্টিমেন্ট শনাক্তকরণ বা আইনি নথিকে পূর্বনির্ধারিত শ্রেণিতে বরাদ্দ করার মতো ক্লাসিফিকেশন কাজের জন্য তৈরি। পর্যাপ্ত লেবেলযুক্ত উদাহরণ না থাকলে, একটি বড় ভাষা মডেল শিক্ষক হিসেবে কাজ করে প্রশিক্ষণ সেটে লেবেল দিতে পারে।
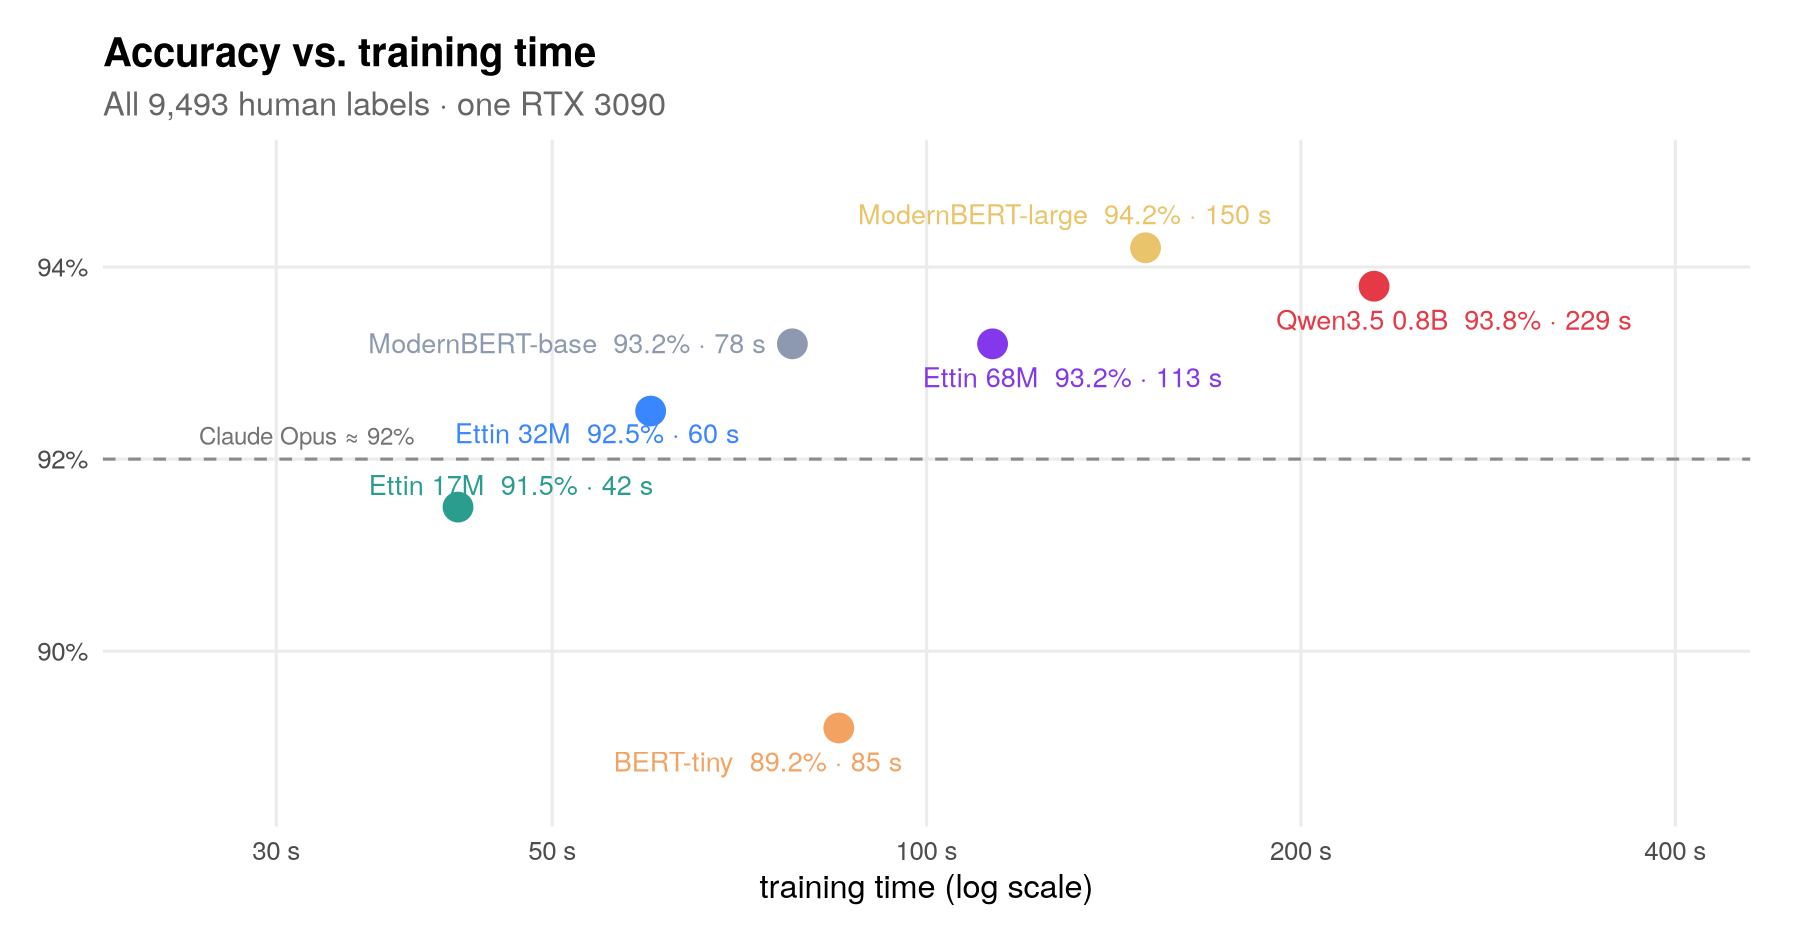
রিপোজিটরির Banking77 পরীক্ষায় Ettin-17M 91.5% নির্ভুলতা অর্জন করেছে, যেখানে Claude Opus-এর ফল 92%। একটি গেমিং GPU-তে প্রশিক্ষণে 42 সেকেন্ড সময় লেগেছে, আর ইনফারেন্সে প্রতি বার্তায় প্রায় 5 মিলিসেকেন্ড লেগেছে। ল্যাপটপের CPU-তেও প্রায় 11 মিনিটে এবং ফোনের GPU-তে প্রায় 21 মিনিটে প্রশিক্ষণ সম্পন্ন হয়েছে।
প্রশিক্ষণ সময়ের তুলনায় Banking77-এর নির্ভুলতা।
প্রধান বৈশিষ্ট্য
- ছোট স্থানীয় মডেল: Ettin-17M-এ 17 মিলিয়ন প্যারামিটার রয়েছে এবং এটি প্রতিটি শ্রেণির জন্য একটি করে স্কোর তৈরি করে।
- মানব বা শিক্ষক-প্রদত্ত লেবেল: যাচাইকৃত লেবেল দিয়ে প্রশিক্ষণ দিন অথবা অন্যথায় লেবেলবিহীন বার্তায় লেবেল দিতে Kimi K3-কে বলুন।
- GPU ও CPU প্রশিক্ষণ: প্রশিক্ষণ স্ক্রিপ্ট উভয় পরিবেশ সমর্থন করে।
- স্ট্যান্ডার্ড মডেল আউটপুট: প্রশিক্ষিত ক্লাসিফায়ার Hugging Face-এর
transformersপাইপলাইনের মাধ্যমে লোড করা যায়। - পুনরায় চালানো যায় এমন লেবেলিং: লেবেলিং স্ক্রিপ্ট রিট্রাই, অভিযোজিত কনকারেন্সি, ধীর অনুরোধের জন্য হেজিং এবং প্রদানকারী-ভিত্তিক বাজেট সমর্থন করে।
- অন্তর্নির্মিত মূল্যায়ন: প্রশিক্ষণ টেস্ট নির্ভুলতা জানায়, আর শিক্ষক লেবেলিং লেবেলযুক্ত টেস্ট সেটে শিক্ষকের নির্ভুলতা মাপতে পারে।
- খরচ বিশ্লেষণ: লেবেলিং ও প্রশিক্ষণের খরচ API-এর মাধ্যমে ক্লাসিফিকেশনের জন্য অর্থ দেওয়ার চেয়ে কখন কম হবে, তা ব্রেক-ইভেন স্ক্রিপ্ট অনুমান করে।
- পুনর্ব্যবহারযোগ্য ডেটা প্রস্তুতি: প্রকল্পটি একটি সামঞ্জস্যপূর্ণ কাঠামো ব্যবহার করে দশটি উন্মুক্ত ক্লাসিফিকেশন ডেটাসেট প্রস্তুত করতে পারে।
প্রশিক্ষণের রেসিপিটি যেভাবে কাজ করে
Ettin-17M হলো Johns Hopkins-এর একটি উন্মুক্ত এনকোডার এবং এটি BERT-ধরনের মডেলের সঙ্গে সম্পর্কিত। টোকেন ধরে ধরে টেক্সট তৈরি করা জেনারেটিভ মডেলের বিপরীতে, এটি সম্পূর্ণ ইনপুট পড়ে এবং প্রতিটি উপলভ্য শ্রেণির জন্য একটি স্কোর নির্ধারণ করে।
রিপোজিটরিটি প্রতিটি শ্রেণির জন্য একটি করে আউটপুট যোগ করে এবং মডেলের প্রতিটি ওজন ফাইন-টিউন করে। ডিফল্ট রেসিপিতে ব্যাচ সাইজ 32, 1e-4 লার্নিং রেটসহ AdamW, 0.01 ওয়েট ডিকেই, 5% ওয়ার্ম-আপের পর কসাইন ডিকেই, 1.0 গ্রেডিয়েন্ট ক্লিপিং এবং ক্রস-এনট্রপি লস ব্যবহার করা হয়।
প্রায় 9,500টি বার্তার জন্য প্রশিক্ষণ ছয়টি পাসে চলে। মাত্র 2,000টি উদাহরণ থাকলে একই সংখ্যক অপ্টিমাইজেশন ধাপ ব্যবহার করা হয়, যা প্রায় 28টি পাসের সমান। README-তে জোর দিয়ে বলা হয়েছে যে প্রতিটি কাজের জন্য এই সেটিংগুলো আলাদাভাবে টিউন করা হয়নি।
ইনস্টলেশন ও সেটআপ
1. uv ইনস্টল করুন
স্ক্রিপ্টগুলো প্রয়োজনীয় পরিবেশ তৈরি করতে এবং প্রথমবার চালানোর সময় স্বয়ংক্রিয়ভাবে নির্ভরতা ইনস্টল করতে uv ব্যবহার করে। আপনার অপারেটিং সিস্টেমের নির্দেশনা অনুসরণ করে uv ইনস্টল করুন, তারপর রিপোজিটরির রুট ডিরেক্টরিতে একটি টার্মিনাল খুলুন।
2. উন্মুক্ত ডেটাসেট প্রস্তুত করুন
প্রস্তুতি স্ক্রিপ্ট চালান:
uv run recipe/prepare.pyএটি Hugging Face Hub থেকে Banking77, CLINC150, ইংরেজি ও ফরাসি ভাষার MASSIVE, TREC, AG News, SST-5, Financial PhraseBank, LEDGAR এবং টুইটের হেট-স্পিচ ডেটাসেট ডাউনলোড করে।
প্রতিটি কাজের জন্য স্ক্রিপ্টটি data/tasks/-এর অধীনে একটি ডিরেক্টরি তৈরি করে। এটি একটি টাস্ক সংজ্ঞা, 2,000টি প্রশিক্ষণ বার্তা, প্রতিটি শ্রেণিতে সর্বোচ্চ 150টি উদাহরণসহ একটি বড় প্রশিক্ষণ স্প্লিট এবং একটি টেস্ট সেট তৈরি করে।
3. লেবেলিং প্রদানকারী কনফিগার করুন
কোনো শিক্ষক মডেল দিয়ে লেবেল তৈরি করতে চাইলে, এক বা একাধিক সমর্থিত প্রদানকারীর জন্য একটি API কী সেট করুন:
export OPENROUTER_API_KEY=...রেসিপিটি Fireworks, Together, DeepInfra এবং Parasail-এর সঙ্গে যুক্ত প্রদানকারী কী-ও শনাক্ত করে। ডেটা পাঠানোর বা প্রশিক্ষণের জন্য তৈরি উত্তর ব্যবহার করার আগে সংশ্লিষ্ট প্রদানকারীর বর্তমান মূল্য, ব্যবহারের নীতি এবং মডেলের শর্তগুলো দেখে নিন।
প্রাথমিক টিউটোরিয়াল: একটি AG News ক্লাসিফায়ার প্রশিক্ষণ
ধাপ 1: Kimi K3 দিয়ে লেবেল তৈরি করুন
ডেটাসেট প্রস্তুত করার পর, 2,000টি AG News প্রশিক্ষণ বার্তায় লেবেল দিন:
uv run recipe/label.py data/tasks/agnewsপ্রতিবেদিত রান অনুযায়ী, Kimi K3 প্রায় $1 খরচে প্রায় 20 সেকেন্ডে 2,000টি উদাহরণে লেবেল দিয়েছে। প্রকৃত সময় ও খরচ প্রদানকারীভেদে পরিবর্তিত হতে পারে। স্ক্রিপ্টটি পুনরায় চালানো যায়, তাই লেবেলিং বাধাগ্রস্ত হলে শুরু থেকে আবার করতে হয় না।
ধাপ 2: শিক্ষক-প্রদত্ত লেবেলে Ettin-17M ফাইন-টিউন করুন
তৈরি করা লেবেল ফাইলটি প্রশিক্ষণ স্ক্রিপ্টে দিন এবং একটি আউটপুট ডিরেক্টরি নির্বাচন করুন:
uv run recipe/train.py data/tasks/agnews --labels labels/agnews-train.jsonl --save models/agnewsস্ক্রিপ্টটি ক্লাসিফায়ার ফাইন-টিউন করে, টেস্ট সেটে মূল্যায়ন করে, টেস্ট নির্ভুলতা প্রিন্ট করে এবং models/agnews-এর অধীনে একটি Hugging Face-সামঞ্জস্যপূর্ণ মডেল সংরক্ষণ করে।
ধাপ 3: মানব-লেবেল বেসলাইন প্রশিক্ষণ
ডেটাসেটের মূল মানব-প্রদত্ত লেবেলে প্রশিক্ষণ দিতে শিক্ষক-লেবেল আর্গুমেন্ট ছাড়া একই প্রশিক্ষণ স্ক্রিপ্ট চালান:
uv run recipe/train.py data/tasks/agnewsএই তুলনা জ্ঞান-ডিস্টিলেশনের সময় কতটা পারফরম্যান্স হারিয়েছে তা বুঝতে সাহায্য করে। রিপোজিটরির টিউটোরিয়াল রানে মানব-প্রদত্ত লেবেলে 89.2% নির্ভুলতা, Kimi K3-এর লেবেলে 85.1% এবং Qwen3.8-27B-এর লেবেলে 81.8% নির্ভুলতা পাওয়া গেছে।
ধাপ ৪: নতুন টেক্সট শ্রেণিবদ্ধ করুন
Hugging Face pipeline ব্যবহার করে সংরক্ষিত মডেলটি লোড করুন:
from transformers import pipeline

classify = pipeline(
    "text-classification",
    model="models/agnews",
    device="cpu"
)

result = classify(
    "NASA's new telescope finds water vapour on a distant planet"
)
print(result)
ফলাফলটি একটি তালিকা, যাতে পূর্বাভাসিত লেবেল ও তার স্কোর থাকে। এই উদাহরণের প্রত্যাশিত ক্যাটাগরি হলো Sci/Tech। রিপোর্ট করা AG News মডেলটি CPU-তে একটি মেসেজ প্রক্রিয়া করতে প্রায় ৬ মিলিসেকেন্ড সময় নিয়েছে।
নিজের ডেটা দিয়ে Tiny Classifiers ব্যবহার করুন
১. একটি টাস্ক ডিরেক্টরি তৈরি করুন
data/tasks/agnews/-এর মতো একই লেআউট অনুসরণ করে একটি ফোল্ডার তৈরি করুন। প্রতিটি কাস্টম টাস্কে task.json, train.jsonl এবং test.jsonl ফাইল থাকতে হবে।
২. ক্যাটাগরি নির্ধারণ করুন
task.json ফাইলে একটি নাম, একটি নির্দেশনামূলক বাক্য এবং লেবেলগুলোর সম্পূর্ণ তালিকা থাকতে হবে:
{"name":"support-routing","instruction":"Assign each support message to the correct team.","labels":["billing","technical","account"]}স্বতন্ত্র ও অর্থবহ লেবেল নাম ব্যবহার করুন। মডেল বা শিক্ষককে কী শ্রেণিবিন্যাসের সিদ্ধান্ত নিতে হবে, নির্দেশনায় তা স্পষ্টভাবে বর্ণনা করা উচিত।
৩. প্রশিক্ষণ ও পরীক্ষার রেকর্ড যোগ করুন
প্রতি লাইনে একটি করে JSON অবজেক্ট সংরক্ষণ করুন। লেবেলযুক্ত রেকর্ডের কাঠামো হলো:
{"id":"msg-001","text":"I was charged twice for my subscription.","label":"billing"}কোনো শিক্ষক মডেল প্রশিক্ষণ ডেটায় লেবেল দিলে, train.jsonl-এর রেকর্ডে label ফিল্ডটি বাদ দেওয়া যেতে পারে:
{"id":"msg-002","text":"The application closes whenever I upload a file."}শিক্ষক ও শিক্ষার্থী উভয়ের নির্ভুলতা মাপতে পরীক্ষার রেকর্ডে যাচাই করা লেবেল থাকা উচিত। উৎপাদনে কোনো মডেল ব্যবহারের আগে কয়েকশ পরীক্ষামূলক মেসেজ ম্যানুয়ালি যাচাই করার পরামর্শ প্রকল্পটি দেয়।
৪. লেবেল দিন, প্রশিক্ষণ দিন এবং মূল্যায়ন করুন
স্ট্যান্ডার্ড কমান্ডগুলোতে আপনার ডিরেক্টরির পথ বসান:
uv run recipe/label.py data/tasks/support-routing
uv run recipe/train.py data/tasks/support-routing \
  --labels labels/support-routing-train.jsonl \
  --save models/support-routing
--labels বাদ দিয়ে আপনি সরাসরি মানব-দেওয়া লেবেল দিয়েও প্রশিক্ষণ দিতে পারেন। Ettin-17M-এর পরিবর্তে অন্য কোনো এনকোডার ব্যবহার করতে প্রশিক্ষণ স্ক্রিপ্টের --model অপশনের মাধ্যমে মডেলটি দিন।
ফাইন-টিউনিং কখন লাভজনক তা পরিমাপ করুন
টাস্কগুলো প্রস্তুত করার পর ব্রেক-ইভেন বিশ্লেষণ চালান:
uv run recipe/breakeven.pyলেবেলিং ও প্রশিক্ষণের প্রাথমিক খরচ, অর্থ ও সময় উভয় বিবেচনা করে, পুনরুদ্ধার করতে কতগুলো মেসেজ শ্রেণিবদ্ধ করতে হবে এই স্ক্রিপ্টটি তার অনুমান দেয়। Jev zero-shot classification API-এর তুলনায়, টাস্কভেদে রিপোজিটরিটি প্রায় ৫০,০০০ থেকে ৫,০০,০০০ মেসেজে ব্রেক-ইভেন পয়েন্ট পেয়েছে।
আপনার ভলিউম কম বা অনিশ্চিত হলে, API-ই সহজ পছন্দ হতে পারে। টাস্ক স্থিতিশীল হলে, মূল্যায়নের ডেটা থাকলে এবং শ্রেণিবিন্যাসের ভলিউম বেশি হলে ফাইন-টিউনিং আরও আকর্ষণীয় হয়ে ওঠে।
উন্নত টিপস
লেবেলের মানকে অগ্রাধিকার দিন
পরীক্ষাগুলোতে দেখা গেছে, মডেলের আকারের চেয়ে লেবেল বেশি গুরুত্বপূর্ণ। আরও লেবেলযুক্ত উদাহরণ যোগ করলে লার্নিং কার্ভের উন্নতি অব্যাহত ছিল। শিক্ষক-প্রশিক্ষিত শিক্ষার্থী সাধারণত তার শিক্ষকের চেয়ে নির্ভুলতায় কয়েক পয়েন্ট পিছিয়ে থাকে, যেখানে মানব-দেওয়া লেবেল সেই সীমা অতিক্রম করতে পারে।
অস্পষ্ট ক্যাটাগরি পর্যালোচনা করুন, পদ্ধতিগত লেবেলিং ত্রুটি সংশোধন করুন এবং আর্কিটেকচার পরিবর্তন বা বহু হাইপারপ্যারামিটার টিউন করার আগে প্রতিনিধিত্বশীল উদাহরণ যোগ করুন।
শিক্ষককে আলাদাভাবে মূল্যায়ন করুন
কোনো টাস্কে দুর্বলভাবে কাজ করা শিক্ষককে একজন শিক্ষার্থী নির্ভরযোগ্যভাবে компенসেট করতে পারে না। দশটি টাস্কের ফলাফলে দেখা গেছে, শিক্ষক নিজেই যেখানে দুর্বল ছিলেন, শিক্ষক-লেবেলযুক্ত মডেলগুলো সেখানে পিছিয়ে পড়েছে। একটি মানব-যাচাইকৃত পরীক্ষার সেট রাখুন এবং অনেক বড় সংগ্রহে লেবেল দেওয়ার খরচ করার আগে শিক্ষকের নির্ভুলতা মাপুন।
পরীক্ষামূলক বৈচিত্র্য বিবেচনায় রাখুন
README-তে র্যান্ডম সিডের কারণে প্রায় ±০.৫ শতাংশ পয়েন্ট এবং পরীক্ষার সেটের আকারের কারণে ±১.৫ থেকে ২ পয়েন্ট বৈচিত্র্যের কথা বলা হয়েছে। প্রকাশিত টেবিলগুলো তিনটি রান-এর গড় ব্যবহার করে। ছোট নির্ভুলতার পার্থক্য স্থাপনের সিদ্ধান্তে প্রভাব ফেললে পুনরাবৃত্ত রান এবং যথেষ্ট বড় পরীক্ষার সেট ব্যবহার করুন।
লাইসেন্স ও প্রদানকারীর শর্ত মেনে চলুন
শিক্ষক মডেলের লাইসেন্স ও প্রদানকারীর শর্ত অনুমতি দিলেই কেবল উৎপন্ন উত্তরের ওপর প্রশিক্ষণ দিন। রিপোজিটরিটি Kimi K3 ব্যবহার করেছে, তবে কিছু মডেল ও API তাদের আউটপুট ব্যবহার করে অন্য মডেল প্রশিক্ষণ দেওয়া নিষিদ্ধ করে। পাবলিক ডেটাসেটগুলোরও নিজস্ব লাইসেন্স থাকে; রিপোজিটরিটি সেগুলো পুনর্বিতরণ না করে ডাউনলোড করে।
বিকল্প হার্ডওয়্যার পরীক্ষা করুন
প্রধান প্রশিক্ষণ স্ক্রিপ্ট CPU ও GPU উভয় এক্সিকিউশন সমর্থন করে। রিপোজিটরিটিতে একটি পৃথক ফোন ইমপ্লিমেন্টেশনও রয়েছে, যা WebGPU ও jax-js ব্যবহার করে Chrome-এর মাধ্যমে প্রশিক্ষণ দেয়। ফোনের ওয়ার্কফ্লোটিকে একটি স্বতন্ত্র ইমপ্লিমেন্টেশন হিসেবে বিবেচনা করুন এবং প্রকল্পের phone/ ডিরেক্টরির নির্দেশনা অনুসরণ করুন।
নথিভুক্ত NixOS সমস্যার সমাধান করুন
/sbin/ldconfig খুঁজে না পাওয়ার কারণে NixOS-এ প্রশিক্ষণ ব্যর্থ হলে, প্রশিক্ষণ চালানোর আগে CUDA লাইব্রেরির পথ নির্ধারণ করুন:
export TRITON_LIBCUDA_PATH=/run/opengl-driver/libউপসংহার
tiny-classifiers লেবেলযুক্ত টেক্সটকে একটি দ্রুত স্থানীয় শ্রেণিবিন্যাসকারীতে রূপান্তরের জন্য সংক্ষিপ্ত ও কার্যকর ওয়ার্কফ্লো দেয়: টাস্ক প্রস্তুত করুন, মানব বা শিক্ষক-দেওয়া লেবেল সংগ্রহ করুন, Ettin-17M ফাইন-টিউন করুন, যাচাইকৃত উদাহরণের বিপরীতে মূল্যায়ন করুন এবং স্থানীয় ইনফারেন্স অর্থনৈতিকভাবে API-কে ছাড়িয়ে যায় কি না তা অনুমান করুন।
সবচেয়ে গুরুত্বপূর্ণ শিক্ষা হলো নির্ভরযোগ্য লেবেল ও মূল্যায়নের ডেটায় বিনিয়োগ করা। এগুলো থাকলে ১৭-মিলিয়ন-প্যারামিটারের একটি এনকোডার শক্তিশালী শ্রেণিবিন্যাস নির্ভুলতা, মিলিসেকেন্ড-স্তরের ইনফারেন্স এবং পূর্বানুমানযোগ্য স্থানীয় পরিচালন খরচ দিতে পারে, প্রতিটি মেসেজের জন্য বড় মডেল কল না করেই।