

রিকারেন্ট লুপড ট্রান্সফরমার কী?
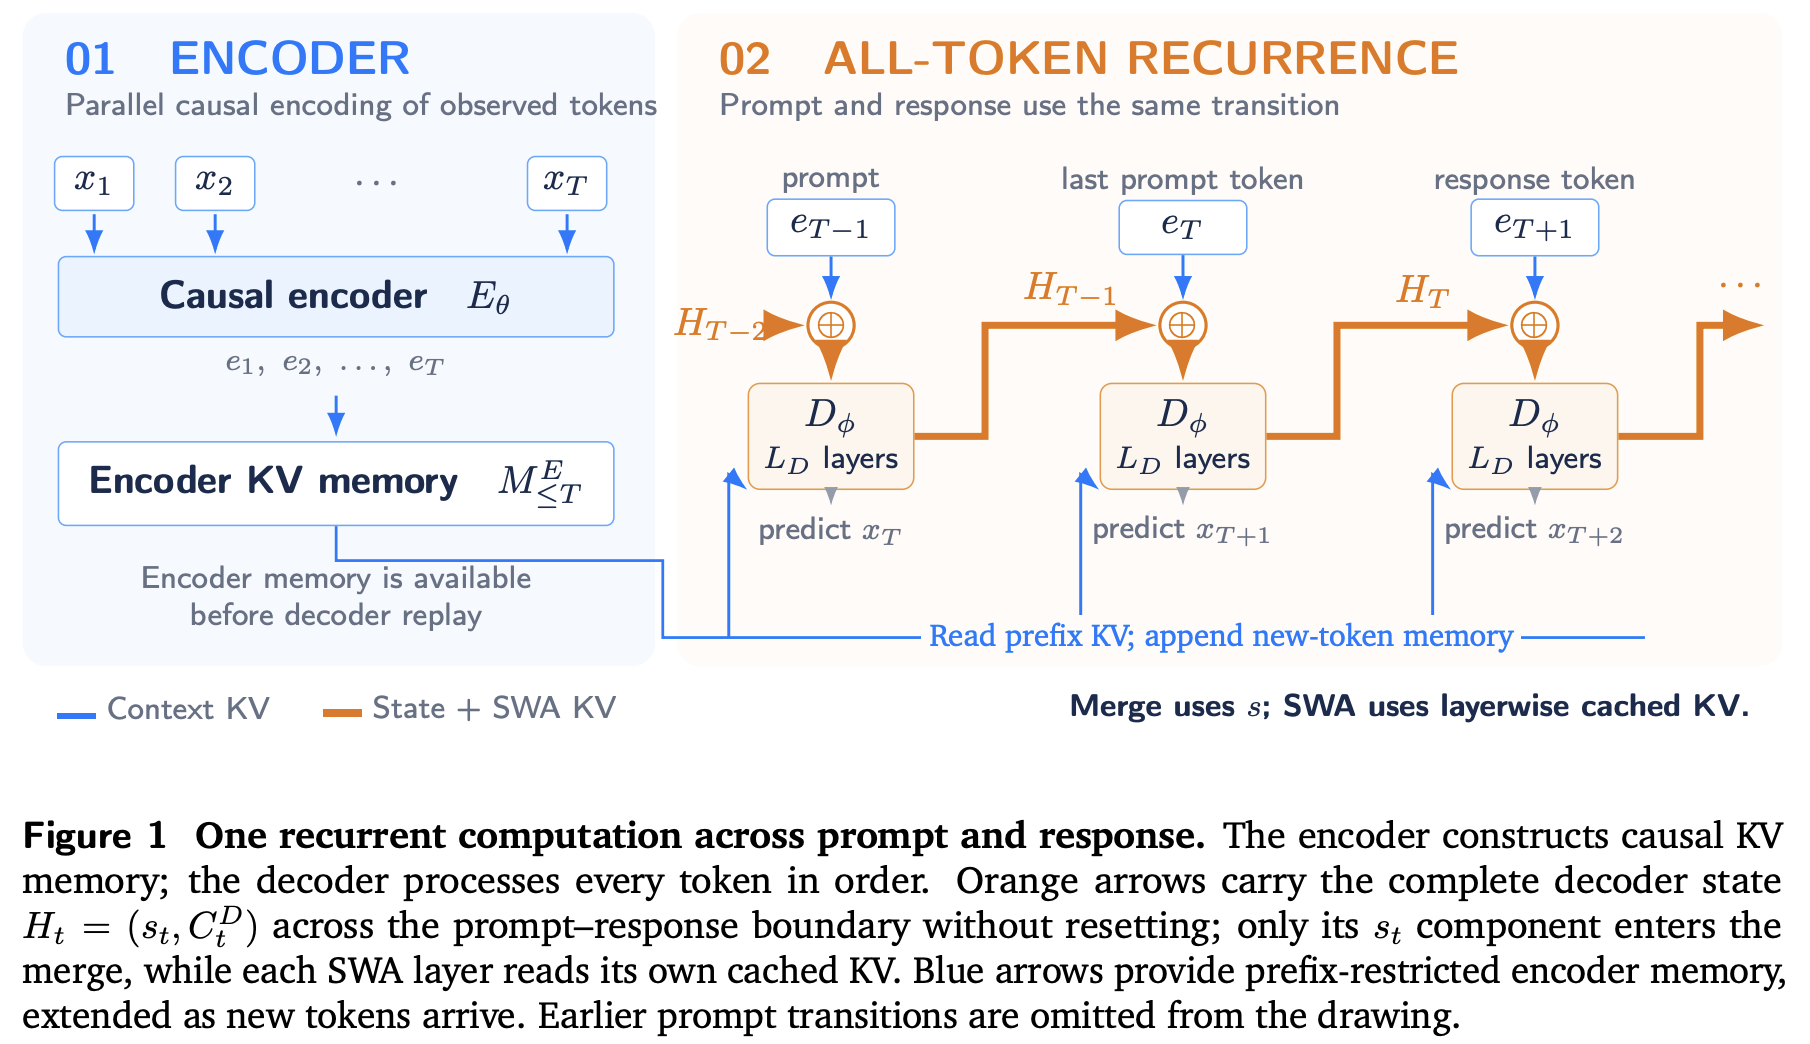
রিকারেন্ট লুপড ট্রান্সফরমার (RLT) হলো এমন একটি গবেষণা-স্থাপত্য, যা একটি সিকোয়েন্সের প্রতিটি টোকেনের মধ্য দিয়ে ল্যাটেন্ট গণনা বহন করার জন্য তৈরি। একটি causal encoder বৈশ্বিক key–value মেমরি তৈরি করে, আর একটি recurrent decoder সেই মেমরির সঙ্গে sliding-window attention এবং তার আগের final hidden state থেকে পাওয়া feedback একত্র করে।
এতে একটি সম্প্রসারণযোগ্য temporal computation path তৈরি হয়। Decoder-এ L_Dটি layer থাকলে, tটি token প্রক্রিয়াকরণের মাধ্যমে tL_Dটি decoder block জুড়ে একটি recurrent path তৈরি হয়, যদিও প্রতিটি token-এর জন্য মডেলটি কেবল নির্দিষ্ট সংখ্যক block চালায়।
এই প্রকল্পে “infinite temporal depth” বলতে বোঝায়, sequence-এর দৈর্ঘ্যের সঙ্গে computation path বাড়তে পারে। এর অর্থ এই নয় যে একটি মাত্র token-এর মধ্যে মডেলটি অসীম computation সম্পাদন করে।
মূল নকশা নীতি
১. সময়জুড়ে ল্যাটেন্ট reasoning
একটি token-এর জন্য final decoder output পরবর্তী token-এর input হয়ে যায়। ফলে মডেলটি prompt এবং generated response জুড়ে একটি latent state ছড়িয়ে দিতে পারে, prompt–response সীমানাকে reset point হিসেবে বিবেচনা না করেই।
২. মডেল ও হার্ডওয়্যারের যৌথ নকশা
প্রস্তাবিত নকশায় কয়েকটি সম্ভাব্য optimization-এর সুযোগ রয়েছে:
- পরিচিত token-গুলোর ওপর parallel causal-encoder computation
- স্বাধীন sequence-গুলোর মধ্যে batching
- encoder থেকে তৈরি memory পুনর্ব্যবহার
- recurrent decoder execution-এর চারপাশে activation checkpointing
এগুলো নকশাগত সুযোগ ও গবেষণার লক্ষ্য। প্রতিবেদনে বড় পরিসরে হার্ডওয়্যারগত speedup পরিমাপ করা হয়েছে বলে দাবি করা হয়নি।
৩. Training ও reinforcement learning-এর জন্য অভিন্ন semantics
Pretraining, supervised fine-tuning, sampling এবং current-policy reinforcement learning replay—সবকিছু একই complete-state transition ব্যবহার করে। এই state-এর মধ্যে prompt recurrence-এর পাশাপাশি decoder-এর sliding-window key–value cache-ও রয়েছে।
স্থাপত্যটি কীভাবে কাজ করে
একটি token x_t-এর জন্য causal encoder একটি representation e_t এবং encoder থেকে তৈরি global memory M_≤t উৎপন্ন করে। Decoder state-এর মধ্যে recurrent output এবং layerwise sliding-window attention cache—দুটিই থাকে:
H_t = (s_t, C_t^D)
H_0 = (s_*, empty)
State transition হলো:
(s_t, C_t^D) = D_phi(
  Merge(e_t, s_(t-1)),
  M_≤t,
  C_(t-1)^D,
  t
)
পরবর্তী token-এর distribution final recurrent output থেকে গণনা করা হয়:
p(x_(t+1) | x_(1:t)) = softmax(W_o RMSNorm_o(s_t))Context-এর তিনটি রূপ
- Global encoder context: Decoder cross-attention কেবল বর্তমান position-এর মাধ্যমে encoder memory পড়ে, ফলে causal আচরণ বজায় থাকে।
- Local decoder memory: Sliding-window attention সাম্প্রতিক decoder key–value entry এবং বর্তমান token-এর entry পড়ে।
Wআকারের একটি window-তে বর্তমান token অন্তর্ভুক্ত থাকে, ফলে পরবর্তী update-এর জন্য সর্বাধিকW - 1টি historical entry অবশিষ্ট থাকে। - Temporal feedback: আগের final decoder output বর্তমান encoder representation-এর সঙ্গে মিশে যায়।
Sequence prompt থেকে response-এ প্রবেশ করলেও recurrent output বা decoder cache কোনোটিই reset হয় না।
নির্দিষ্ট মডেল configuration
প্রতিবেদনে 48টি encoder layer এবং 48টি decoder layer-সম্বলিত একটি configuration বর্ণনা করা হয়েছে। সামঞ্জস্যপূর্ণ attention ও feed-forward weight-গুলো stage-গুলোর মধ্যে shared। Decoder block-গুলো encoder memory-এর ওপর অতিরিক্ত cross-attention সম্পাদন করে, তাই layer-এর সংখ্যা একই হলেও floating-point operation-এর সংখ্যা একই—এমন নয়।
Installation ও Repository Setup
README-তে নথিভুক্ত software package-এর বদলে একটি architectural report উপস্থাপন করা হয়েছে। এতে dependency requirements, installation command, public training script বা runnable API দেওয়া নেই। তবু paper ও সহায়ক উপকরণ পড়তে repository clone করতে পারেন:
git clone https://github.com/yifanzhang-pro/recurrent-looped-tranformer.git
cd recurrent-looped-tranformer
অন্তর্ভুক্ত Recurrent_Looped_Transformer.pdf দিয়ে শুরু করুন। এছাড়াও project website ভিজিট করতে পারেন এবং prefill–decode kernel mismatch note পর্যালোচনা করতে পারেন।
README-তে কোনো executable implementation নথিভুক্ত না থাকায় repository description থেকে package installation instructions বা ready-to-run model code অনুমান করা উচিত নয়।
মৌলিক ব্যবহার: RLT Execution Model অনুসরণ
প্রতিবেদনটি প্রয়োগের সবচেয়ে কার্যকর উপায় হলো এটিকে একটি implementation blueprint হিসেবে ব্যবহার করা। নিচের conceptual pseudocode একটি state transition-এর সারসংক্ষেপ; এটি repository-প্রদত্ত API নয়:
state = (initial_recurrent_state, empty_decoder_cache)

for each token x_t:
    e_t = causal_encoder_representation(x_t)
    memory = encoder_memory_through_position(t)

    merged = Merge(e_t, state.recurrent_output)
    state = recurrent_decoder(
        merged,
        memory,
        state.decoder_cache,
        position=t
    )

    next_token_distribution = output_head(state.recurrent_output)
Prompt prefill
- পরিচিত prompt token-গুলোর ওপর batch হিসেবে causal encoder চালান।
- Decoder-এর মাধ্যমে প্রতিটি prompt token-এর ওপর recurrence চালান।
- এই recurrence চলাকালীন decoder sliding-window key–value cache তৈরি করুন।
- Generation-এর জন্য final recurrent output ও cache সংরক্ষণ করুন।
প্রম্পট প্রিফিলের সময় শুধু এনকোডার চালালে প্রতিবেদনে বর্ণিত সম্পূর্ণ RLT স্টেট পুনরুৎপাদন করা যাবে না।
অটোরিগ্রেসিভ জেনারেশন
- পরবর্তী টোকেনের ডিস্ট্রিবিউশন গণনা করতে পূর্ববর্তী স্টেট ব্যবহার করুন।
- ওই ডিস্ট্রিবিউশন থেকে একটি টোকেন স্যাম্পল করুন।
- স্যাম্পল করা টোকেনটি ইনক্রিমেন্টালভাবে এনকোড করুন।
- রিকারেন্ট ডিকোডারের মাধ্যমে টোকেনটি ঠিক একবার প্রসেস করুন।
- রিকারেন্ট আউটপুট এবং স্লাইডিং-উইন্ডো ক্যাশ উভয়ই আপডেট করুন।
এই ক্রমটি জেনারেট করা টোকেনকে দুবার প্রসেস করা এড়ায় এবং প্রশিক্ষণের সময় ব্যবহৃত একই স্টেট-ট্রানজিশন সেমান্টিক্স বজায় রাখে।
প্রিট্রেনিং এবং সুপারভাইজড ফাইন-টিউনিং
প্রিট্রেনিংয়ের সময় এনকোডারটি কারণনির্ভরভাবে চলে এবং রিকারেন্ট ডিকোডার সম্পূর্ণ ব্যাকপ্রপাগেশন থ্রু টাইম ব্যবহার করে। প্রতিটি বৈধ পরবর্তী-টোকেন টার্গেটের জন্য সুপারভিশন প্রয়োগ করা হয়।
সুপারভাইজড ফাইন-টিউনিংয়ের সময় সব কনটেক্সট টোকেনের ভিত্তিতে স্টেট আপডেট করা হয়, কিন্তু লস প্রয়োগ করা হয় শুধু অ্যাসিস্ট্যান্ট টার্গেটগুলোর ওপর। প্রম্পটের টোকেনগুলো সুপারভাইজড না হলেও রিকারেন্ট স্টেট নির্মাণে অংশগ্রহণ করে।
বর্তমান-পলিসি রিইনফোর্সমেন্ট লার্নিং রিপ্লে
বর্তমান-পলিসি রিপ্লেকে বর্তমান মডেল ওজনের অধীনে সম্পূর্ণ সিকোয়েন্স ইতিহাস পুনর্গঠন করতে হয়। এর মধ্যে রিকারেন্ট আউটপুট, এনকোডার মেমরি এবং ডিকোডারের সব স্লাইডিং-উইন্ডো ক্যাশ অন্তর্ভুক্ত।
- বর্তমান প্যারামিটার ব্যবহার করে এনকোডার রিপ্রেজেন্টেশন ও মেমরি পুনর্নির্মাণ করুন।
- রিকারেন্ট স্টেট এবং ডিকোডার ক্যাশ পুনর্গঠনের জন্য আগের প্রতিটি টোকেন রিপ্লে করুন।
- কোনো অ্যাকশন টোকেন প্রসেস করার আগে তার সম্ভাবনা মূল্যায়ন করুন।
- পরবর্তী স্টেটে অগ্রসর হতে অ্যাকশনটি একবার প্রসেস করুন।
ওজন আপডেটের পর প্যারামিটার-নির্ভর ক্যাশ পুরোনো হয়ে যায়, তাই নির্ভুল রিপ্লের জন্য সেগুলো পুনর্নির্মাণ করতে হয়। সম্পূর্ণ গ্রেডিয়েন্ট রিকারেন্ট আউটপুট, ডিকোডার কী–ভ্যালু এন্ট্রি এবং এনকোডার মেমরির মধ্য দিয়ে প্রবাহিত হয়। এসব উপাদানের যেকোনোটি ডিট্যাচ করা গ্রেডিয়েন্টের একটি আনুমানিক রূপ।
বিহেভিয়ার লগ-প্রবাবিলিটিকে স্যাম্পলিংয়ের জন্য বাস্তবে ব্যবহৃত ডিস্ট্রিবিউশনের সঙ্গে সামঞ্জস্যপূর্ণ হতে হবে। নির্ভুল ইম্পর্ট্যান্স স্যাম্পলিংয়ের জন্য অতিরিক্তভাবে সাপোর্ট কভারেজ প্রয়োজন। শেয়ার করা এক্সিকিউশন সেমান্টিক্স কাঠামোগত প্রম্পট-বাউন্ডারি অমিল কমায়, কিন্তু কার্নেলগুলোর মধ্যে সংখ্যাগত সমতা বা একটি আনবায়াসড অফ-পলিসি অবজেক্টিভ নিশ্চিত করে না।
প্রাথমিক সিনথেটিক ফলাফল
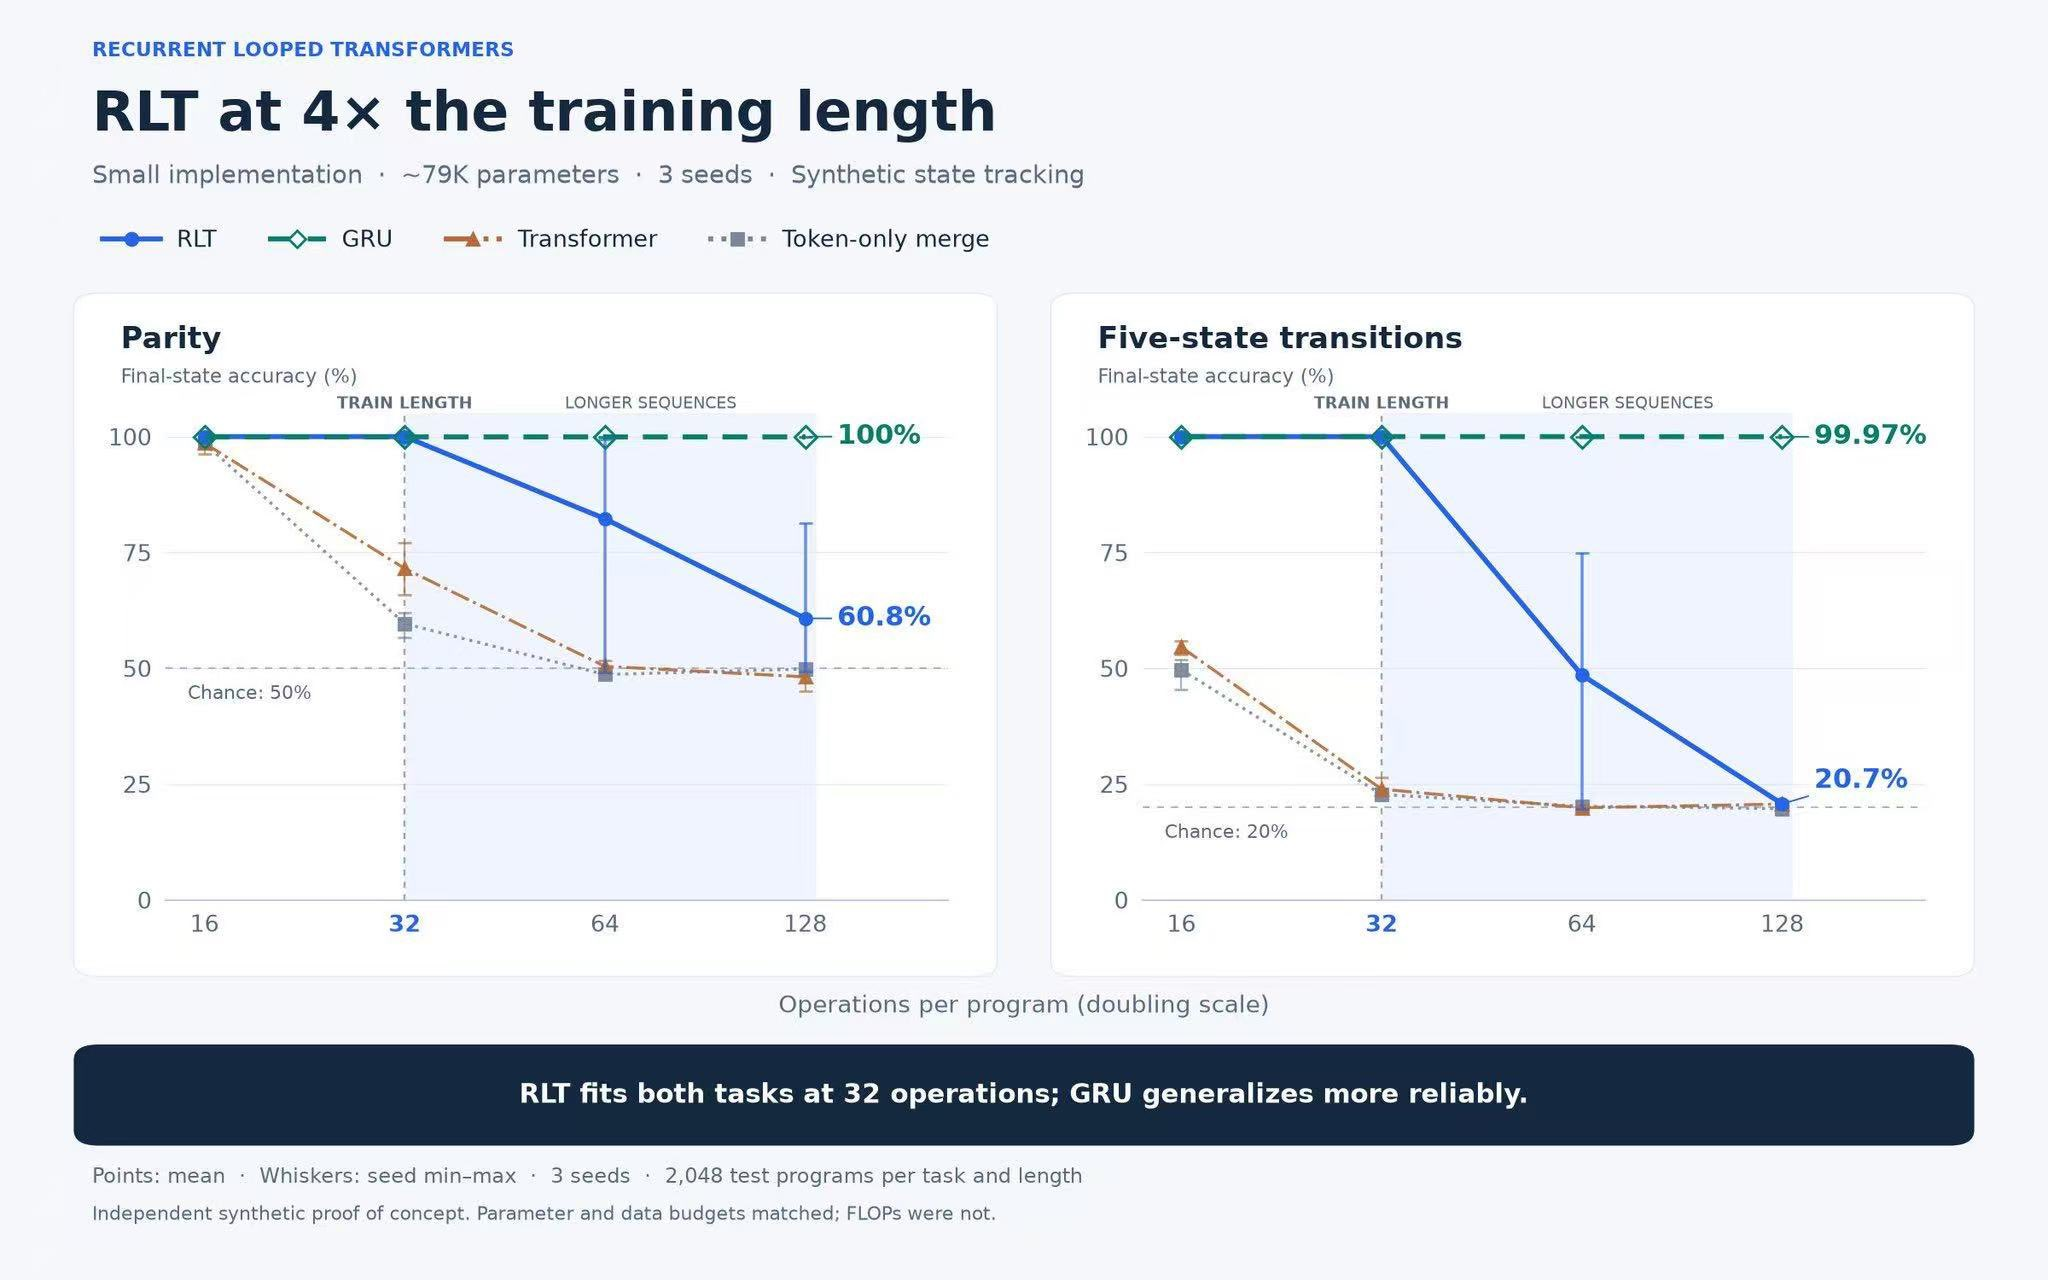
README-তে প্রায় 79,000 প্যারামিটার এবং তিনটি র্যান্ডম সিড ব্যবহার করে একটি ছোট ইমপ্লিমেন্টেশনের স্বাধীন প্রুফ-অফ-কনসেপ্ট স্টেট-ট্র্যাকিং পরীক্ষার কথা বলা হয়েছে। মডেলগুলোকে 32টি অপারেশনের সিকোয়েন্সে প্রশিক্ষণ দেওয়া হয়েছিল এবং সর্বোচ্চ 128টি অপারেশনে মূল্যায়ন করা হয়েছিল; প্রতিটি টাস্ক ও দৈর্ঘ্যের জন্য ছিল 2,048টি টেস্ট প্রোগ্রাম।
প্যারিটি টাস্ক
- 32টি অপারেশনে RLT প্রায় 100% ফাইনাল-স্টেট নির্ভুলতা অর্জন করেছে।
- 64টি অপারেশনে এটি প্রায় 82% অর্জন করেছে।
- 128টি অপারেশনে এটি 60.8% অর্জন করেছে।
- প্যারিটির ক্ষেত্রে চান্স নির্ভুলতা 50%।
পাঁচ-স্টেট ট্রানজিশন টাস্ক
- 32টি অপারেশনে RLT প্রায় 100% ফাইনাল-স্টেট নির্ভুলতা অর্জন করেছে।
- 64টি অপারেশনে এটি প্রায় 49% অর্জন করেছে।
- 128টি অপারেশনে এটি 20.7% অর্জন করেছে।
- এই টাস্কের ক্ষেত্রে চান্স নির্ভুলতা 20%।
ফলাফল দেখায় যে প্রশিক্ষণের দৈর্ঘ্যে RLT উভয় টাস্কেই ফিট করেছে, কিন্তু দীর্ঘতর সিকোয়েন্সে এর নির্ভুলতা কমেছে। আনুমানিক হিসেবে চিহ্নিত মানগুলো মূল চিত্র থেকে পড়া হয়েছে, আর 128-অপারেশনের RLT মানগুলো সংখ্যাগতভাবে লেবেল করা ছিল।
প্যারামিটার এবং ডেটা বাজেট সমান রাখা হয়েছিল, কিন্তু ফ্লোটিং-পয়েন্ট অপারেশন বাজেট সমান ছিল না। এই পরীক্ষাগুলো সিনথেটিক প্রদর্শনী; এগুলো বৃহৎ-পরিসরের রিজনিং উন্নতি, হার্ডওয়্যার ত্বরণ বা রিইনফোর্সমেন্ট লার্নিং স্কেলিংয়ের প্রমাণ নয়।
উন্নত ইমপ্লিমেন্টেশন পরামর্শ
- সম্পূর্ণ স্টেটকে অবিভাজ্য হিসেবে বিবেচনা করুন:
s_tএবংC_t^Dউভয়ই সংরক্ষণ করুন। শুধু রিকারেন্ট ভেক্টর পুনরুদ্ধার করলে নথিবদ্ধ ট্রানজিশন পুনরুৎপাদন হয় না। - রেসপন্সের সীমায় রিসেট করবেন না: প্রম্পট রিকারেন্স এবং এর ডিকোডার ক্যাশ সরাসরি রেসপন্স জেনারেশনে প্রবাহিত হতে হবে।
- উইন্ডার সংজ্ঞা নির্ভুলভাবে নির্ধারণ করুন:
Wআকারের স্লাইডিং উইন্ডারে বর্তমান টোকেন অন্তর্ভুক্ত থাকে, তাই পরবর্তী আপডেটের জন্য ঐতিহাসিক এন্ট্রি অবশিষ্ট থাকে মাত্রW - 1টি। - আপডেটের পর ক্যাশ পুনর্নির্মাণ করুন: বর্তমান-পলিসি রিপ্লের জন্য আগের পলিসি থেকে ক্যাশ করা মান নয়, বর্তমান ওজন দিয়ে তৈরি ক্যাশ প্রয়োজন।
- স্যাম্পলিং ও রিপ্লের ক্রম সামঞ্জস্যপূর্ণ রাখুন: পূর্ববর্তী স্টেট থেকে জেনারেট করা অ্যাকশন মূল্যায়ন করুন, তারপর সেটি একবার প্রসেস করুন।
- নির্ভুল গ্রেডিয়েন্ট ও আনুমানিক রূপ আলাদা করুন: রিকারেন্ট স্টেট, ডিকোডার ক্যাশ বা এনকোডার মেমরি ডিট্যাচ করলে গ্রেডিয়েন্টের পথ পরিবর্তিত হয়।
- কম্পিউট আলাদাভাবে পরিমাপ করুন: সমান প্যারামিটার বা ডেটা বাজেট সমান FLOP প্রমাণ করে না, বিশেষত ডিকোডার স্তরগুলো এনকোডার-মেমরি ক্রস-অ্যাটেনশন যোগ করে বলে।
- সংখ্যাগত আচরণ যাচাই করুন: শেয়ার করা উচ্চ-স্তরের এক্সিকিউশন সেমান্টিক্স স্বয়ংক্রিয়ভাবে প্রিফিল ও ডিকোড কার্নেলের পার্থক্য দূর করে না।
উপসংহার
রিকারেন্ট লুপড ট্রান্সফরমার বৈশ্বিক কারণনির্ভর এনকোডার মেমরি, স্থানীয় ডিকোডার স্লাইডিং-উইন্ডো অ্যাটেনশন এবং টোকেন-টু-টোকেন রিকারেন্ট ফিডব্যাককে একত্র করে। এর কেন্দ্রীয় ইমপ্লিমেন্টেশন নিয়ম হলো সামঞ্জস্য: প্রিট্রেনিং, ফাইন-টিউনিং, জেনারেশন এবং বর্তমান-পলিসি রিপ্লে জুড়ে প্রতিটি প্রম্পট ও রেসপন্স টোকেনকে একই সম্পূর্ণ-স্টেট ট্রানজিশনে অংশগ্রহণ করতে হবে।
প্রাথমিক পরীক্ষাগুলো ছোট স্টেট-ট্র্যাকিং টাস্কে কার্যকর দৈর্ঘ্য-সাধারণীকরণের ইঙ্গিত দেয়, কিন্তু প্রশিক্ষণের দৈর্ঘ্য অতিক্রম করলে কর্মক্ষমতা এখনও কমে যায়। তাই আর্কিটেকচারটিকে যাচাইকৃত বৃহৎ-পরিসরের রিজনিং সিস্টেম হিসেবে নয়, বরং একটি গবেষণা প্রস্তাব ও প্রুফ-অফ-কনসেপ্ট হিসেবে দেখা উচিত।