

গ্র্যাজুয়েট ভর্তি এজেন্ট বেঞ্চমার্ক যা মূল্যায়ন করে
গ্র্যাজুয়েট ভর্তি এজেন্ট বেঞ্চমার্ক গ্র্যাজুয়েট ভর্তি পরামর্শদানের জন্য এজেন্ট কনফিগারেশন মূল্যায়ন করে। একটি এজেন্ট কনফিগারেশনে একটি এক্সিকিউশন সিস্টেম ও একটি ভাষা মডেল থাকে। এটি আবেদন-সংক্রান্ত সুপারিশ, পরিকল্পনা, সিদ্ধান্ত গ্রহণ এবং নতুন শিক্ষার্থী-তথ্য পাওয়া গেলে পরামর্শ হালনাগাদ করার সক্ষমতা পরীক্ষা করে।
বেঞ্চমার্কটিতে বর্তমানে চীনা ভাষার 70টি টাস্ক, 23টি কেস এবং 83টি উত্তর-ধাপ রয়েছে। প্রতিটি টাস্কের জন্য মূল্যায়ন রুব্রিক ও রেফারেন্স প্রোগ্রাম রয়েছে। পাবলিক ডেটাসেট ব্যবহার করতে অনুমোদনের প্রয়োজন হয় না, তবে মূল্যায়ন করা এজেন্টদের কাছ থেকে স্কোরিং উপকরণ গোপন রাখা উচিত, যাতে ফলাফল প্রভাবিত না হয়।
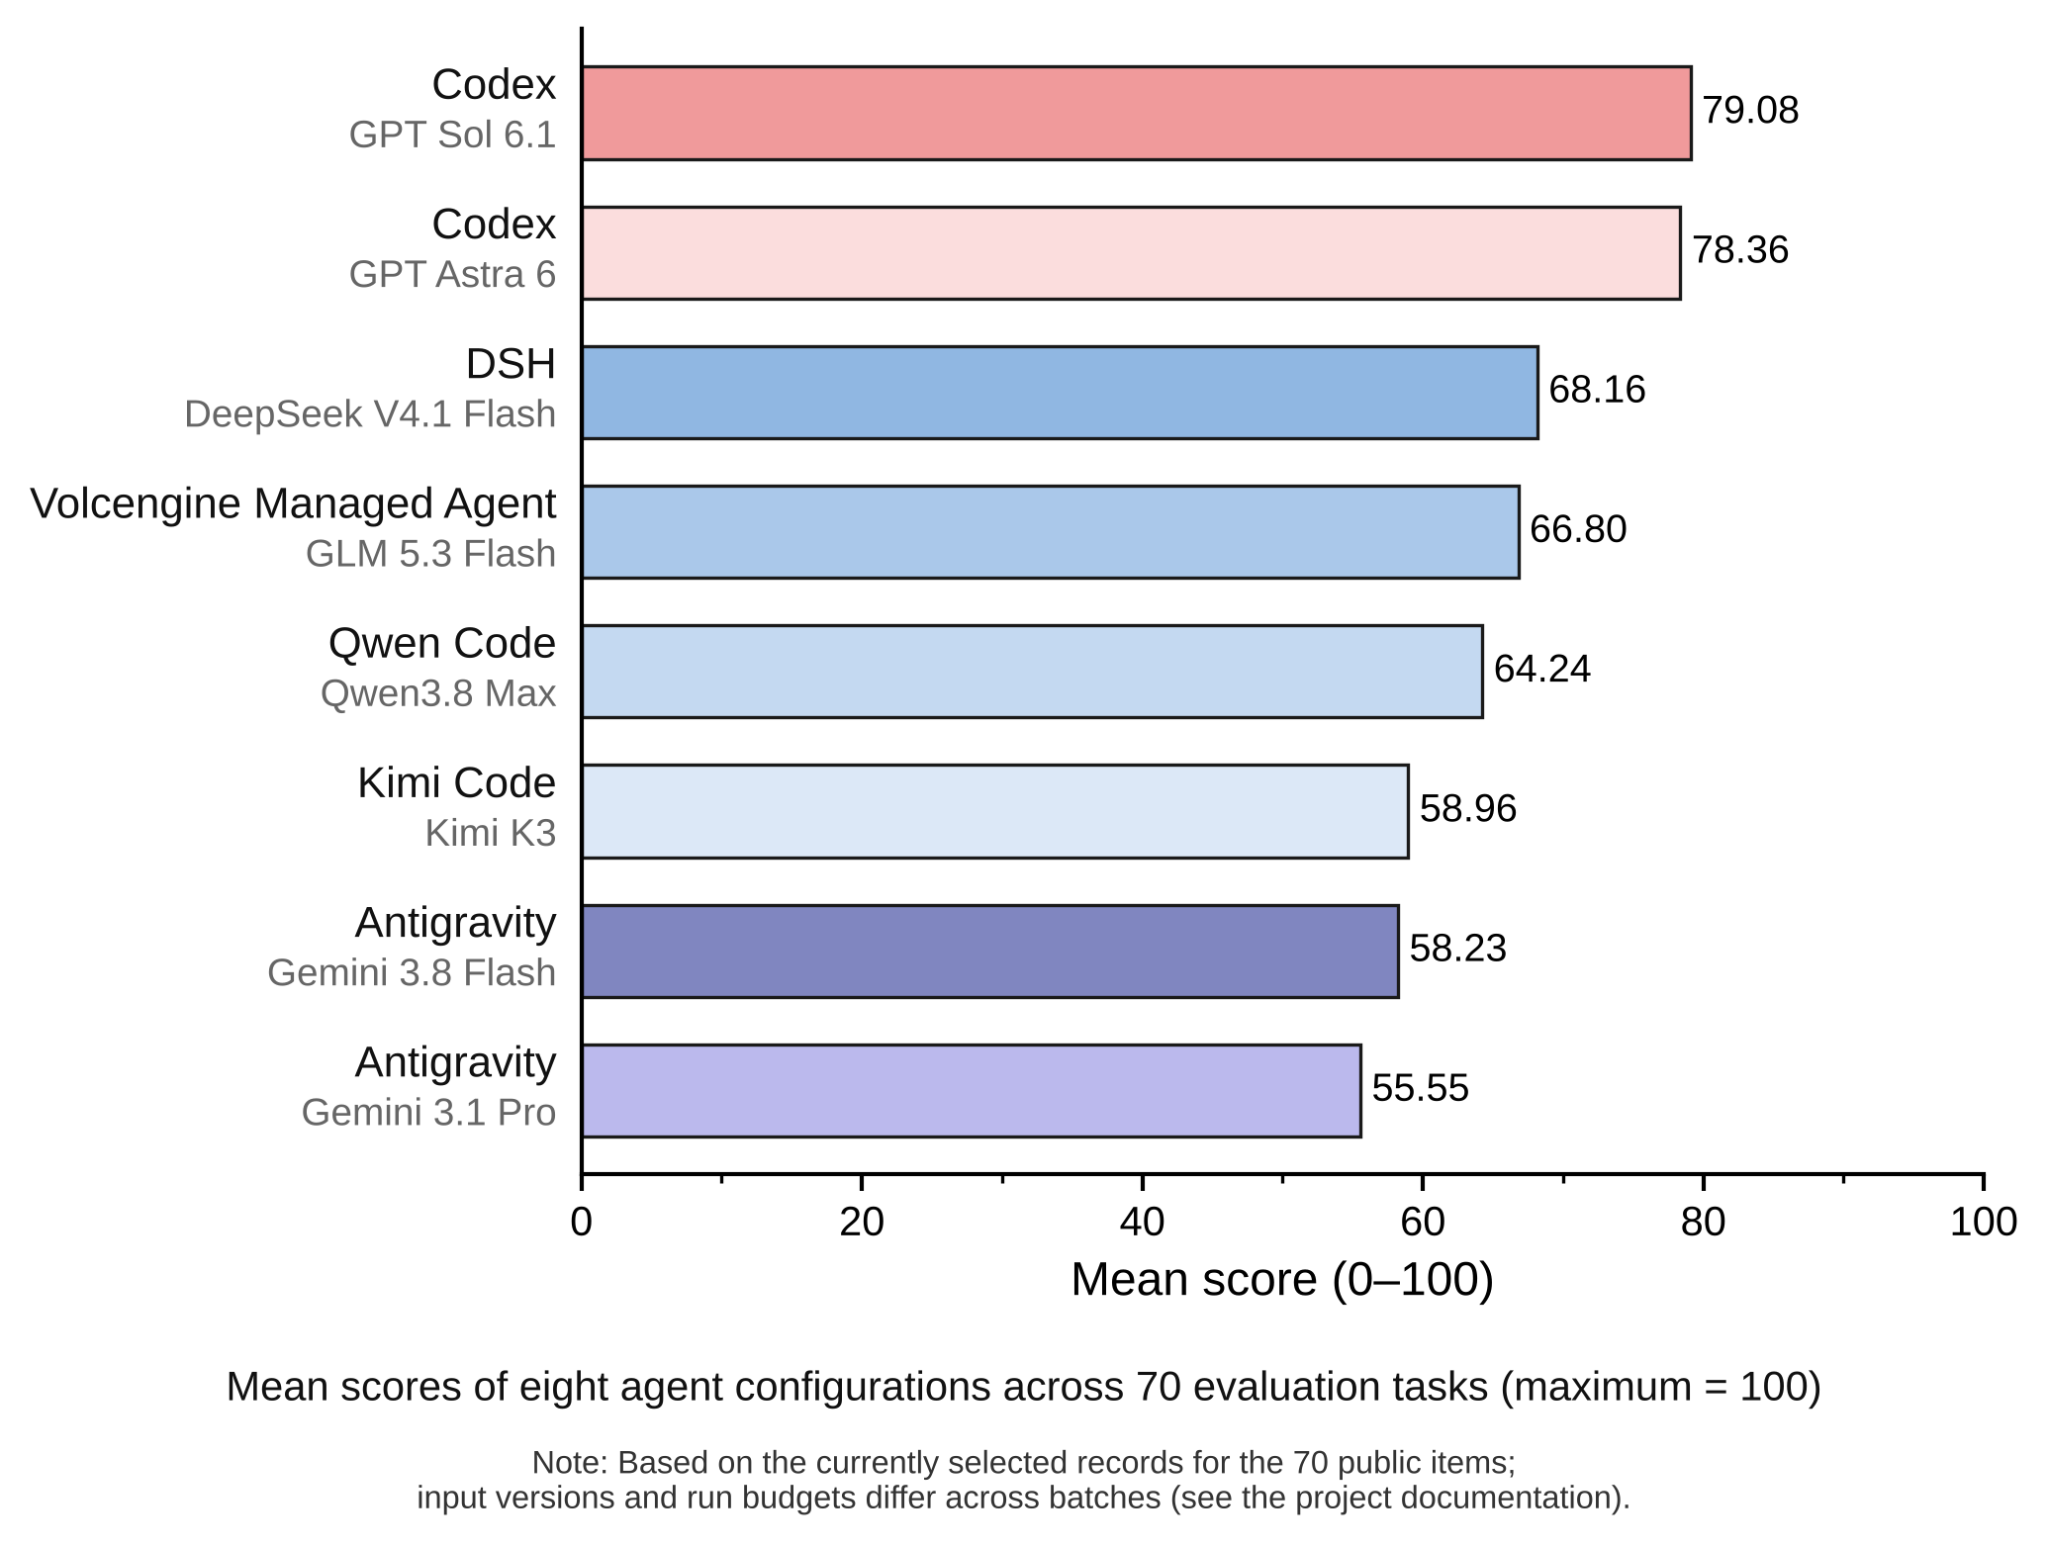
রিপোজিটরিতে আটটি কনফিগারেশনের মূল্যায়ন রেকর্ডও প্রকাশ করা হয়েছে। প্রতিটি কনফিগারেশন বর্তমান 70টি টাস্ক সম্পন্ন করেছে, যদিও প্রকল্পের নোট অনুযায়ী রানগুলোতে ভিন্ন ইনপুট সংস্করণ ও বাজেট ব্যবহৃত হয়েছে। তাই লিডারবোর্ডের ফলাফলকে পুরোপুরি অভিন্ন পরীক্ষার ফল হিসেবে বিবেচনা করা উচিত নয়।
মূল্যায়ন কাঠামো বুঝুন
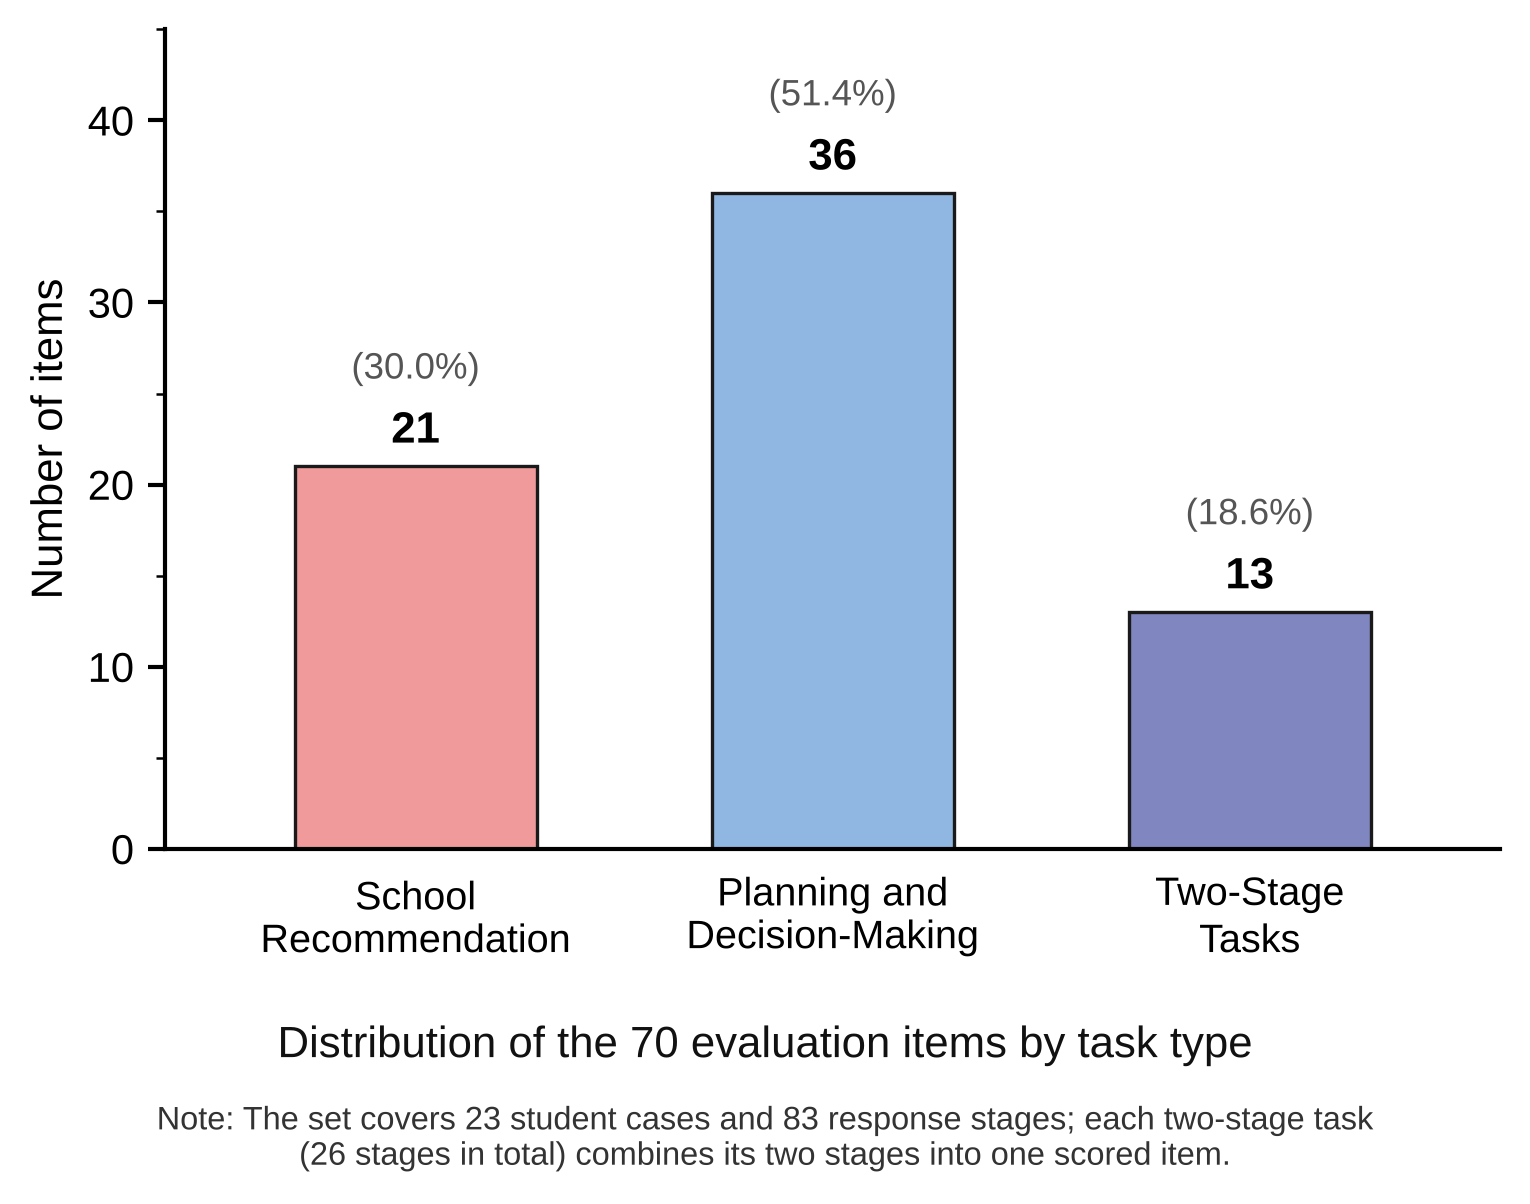
টাস্ক সংগ্রহটি তিনটি বিভাগে বিভক্ত:
- 21টি সুপারিশ টাস্ক: প্রস্তাবিত প্রোগ্রামগুলো শিক্ষার্থীর পটভূমি ও সীমাবদ্ধতার সঙ্গে কতটা সামঞ্জস্যপূর্ণ তা মূল্যায়ন করে।
- 36টি পরিকল্পনা ও সিদ্ধান্ত টাস্ক: প্রস্তুতি পরিকল্পনা, ঝুঁকি মূল্যায়ন এবং কার্যকর পরামর্শ পরীক্ষা করে।
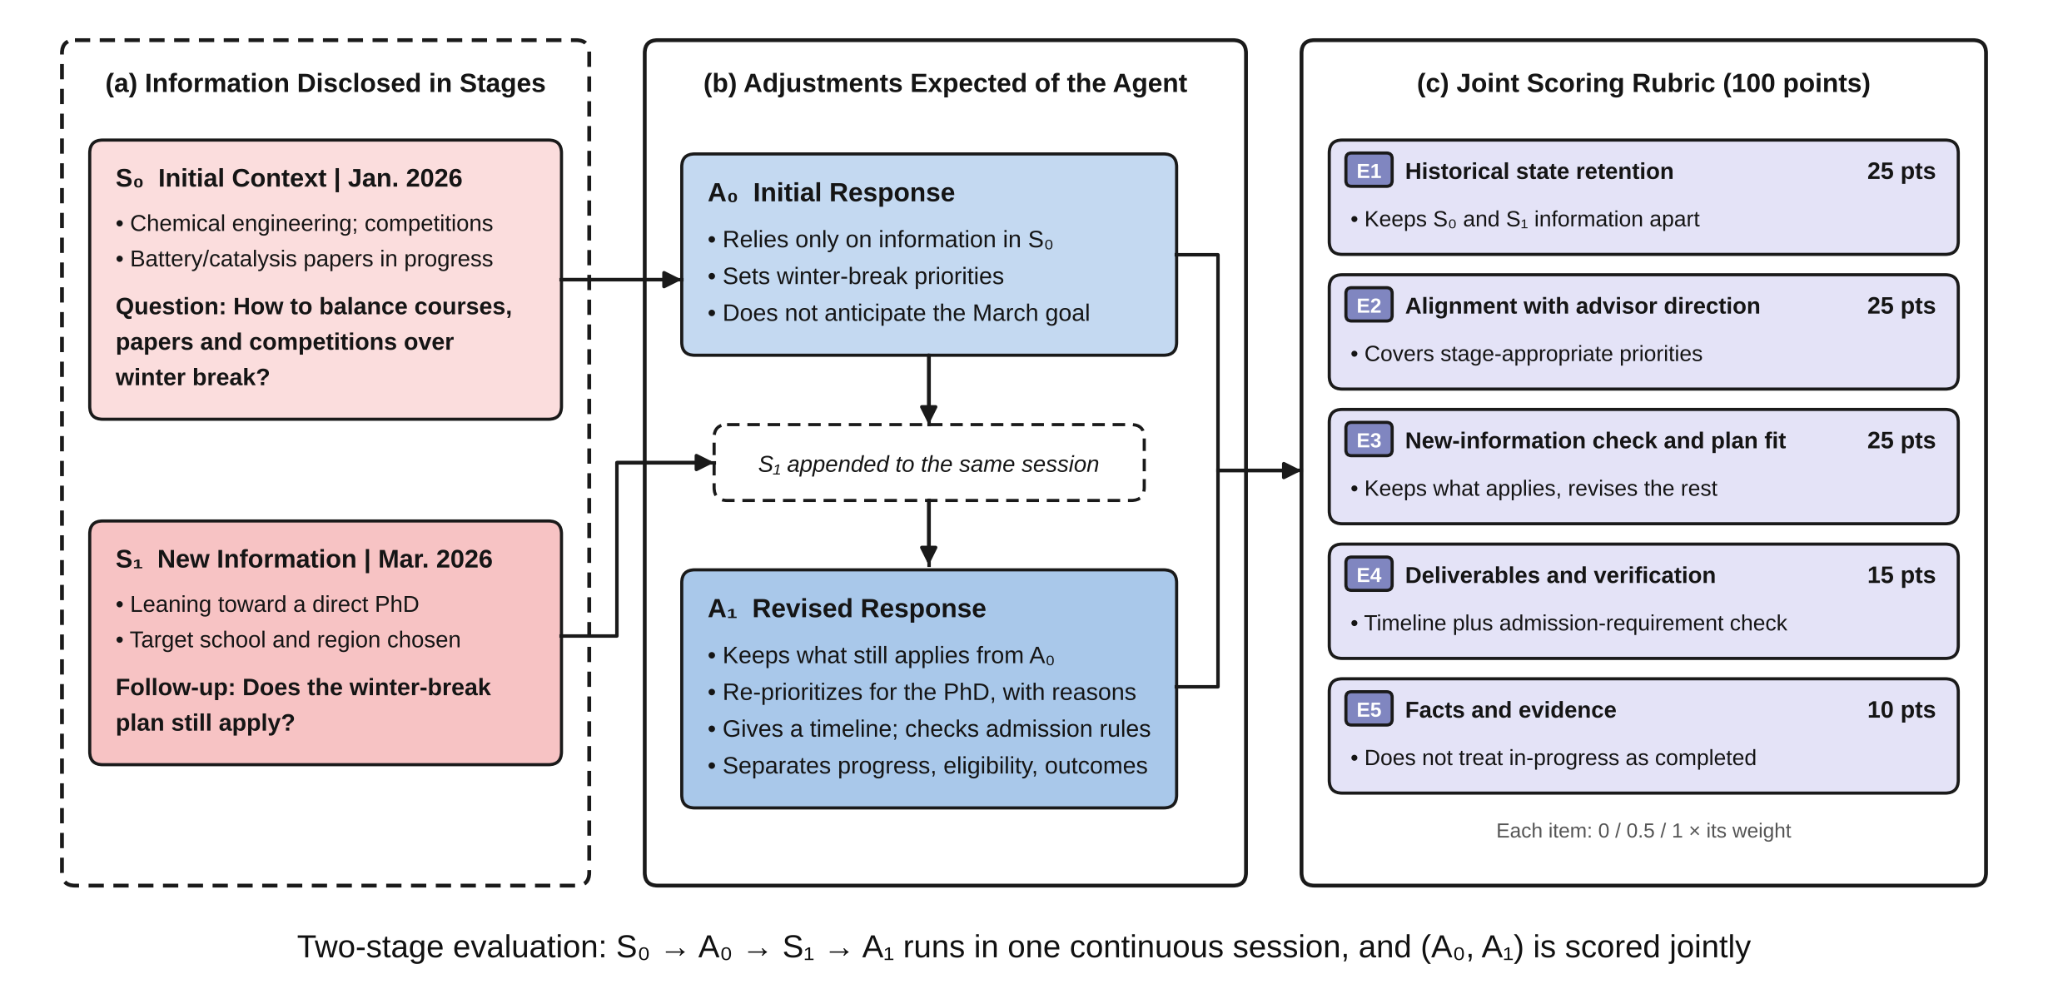
- 13টি দুই-ধাপের টাস্ক: একই সেশনে নতুন তথ্য দেয় এবং এজেন্ট তার আগের পরামর্শ সংশোধন করে কি না তা পরীক্ষা করে।
প্রতিটি টাস্কের মূল্য 100 পয়েন্ট। সুপারিশ টাস্কে রেফারেন্স প্রোগ্রামের সঙ্গে মিলের জন্য 70 পয়েন্ট এবং সুপারিশের মানের জন্য 30 পয়েন্ট বরাদ্দ থাকে। একজন পৃথক রিভিউয়ার সম্পূর্ণ উত্তর স্কোর করেন, আর রুব্রিকগুলো উত্তর দেওয়ার প্রক্রিয়ার বাইরে রাখা হয়।
দুই-ধাপের টাস্ক একটি প্রাথমিক প্রেক্ষাপট দিয়ে শুরু হয়, যাকে S₀ বলা হয়। এরপর হালনাগাদ তথ্য দেওয়া হয়, যাকে S₁ বলা হয়। এজেন্ট একই সেশনে একটি প্রাথমিক উত্তর, A₀, এবং একটি সংশোধিত উত্তর, A₁, তৈরি করে। উভয় উত্তর যৌথভাবে স্কোর করা হয়। পাবলিক O03-04 উদাহরণে জানুয়ারি থেকে মার্চ পর্যন্ত একটি পরিস্থিতি দেখানো হয়েছে, যেখানে শিক্ষার্থী সরাসরি PhD আবেদনের দিকে এগোনোর সিদ্ধান্ত পরিবর্তন করে।
পরিবেশ প্রস্তুত করুন
রিপোজিটরির রুট থেকে কমান্ড চালান। স্বয়ংক্রিয় নেটিভ এক্সিকিউশনের জন্য macOS Seatbelt এবং Python 3.10 বা পরবর্তী সংস্করণ প্রয়োজন। Kimi সাবস্ক্রিপশন কনফিগারেশনের জন্য Python 3.11 বা পরবর্তী সংস্করণ প্রয়োজন।
ফ্রেমওয়ার্কটি কেবল Python-এর স্ট্যান্ডার্ড লাইব্রেরি ব্যবহার করে, তাই রিপোজিটরিতে pip install ধাপের প্রয়োজন নেই। তবে আপনি যে কনফিগারেশন চালাতে চান, তার অফিসিয়াল ক্লায়েন্ট ইনস্টল করতে হবে এবং সাবস্ক্রিপশন লগইন বা API কী প্রস্তুত করতে হবে।
উপলভ্য ক্লায়েন্টগুলোর মধ্যে রয়েছে Codex, Claude Code, Antigravity, DeepSeek Harness, Qwen Code এবং Kimi Code। ক্লায়েন্টভেদে প্রমাণীকরণ পদ্ধতি আলাদা: কিছু কনফিগারেশন সাবস্ক্রিপশন বা OAuth ব্যবহার করে, আর প্রকল্পের ডকুমেন্টেশনে বর্ণিত অনুযায়ী DeepSeek ও Qwen API-ভিত্তিক প্রমাণীকরণ ব্যবহার করে।
একটি এজেন্ট কনফিগারেশন বেছে নিন
এজেন্ট আইডিগুলো রিপোজিটরির বর্তমান রেজিস্ট্রি config/agents-cli.example.json থেকে নেওয়া হয়। এগুলো বেঞ্চমার্ক কনফিগারেশন আইডেন্টিফায়ার, সরাসরি মডেল আর্গুমেন্ট নয়।
gpt-6-astraCodex-এর সঙ্গে GPT Astra 6-এর জন্যgpt-6-1-solCodex-এর সঙ্গে GPT Sol 6.1-এর জন্যclaude-opus-5-5Claude Code-এর সঙ্গে Claude Opus-এর জন্যclaude-sonnet-5-5Claude Code-এর সঙ্গে Claude Sonnet-এর জন্যantigravity-gemini-3-8-flash-highAntigravity-এর সঙ্গে Gemini Flash-এর জন্যdeepseek-v4-1-flashDeepSeek Harness-এর সঙ্গে DeepSeek Flash-এর জন্যqwen3-8-max-0902Qwen Code-এর সঙ্গে Qwen Max-এর জন্যkimi-k3Kimi Code-এর সঙ্গে Kimi K3-এর জন্য
দ্রুত শুরু করার ওয়ার্কফ্লো চালান
প্রতিটি কনফিগারেশনের জন্য বেঞ্চমার্ক একই ওয়ার্কফ্লো ব্যবহার করে। প্রথমে AGENT শেল ভেরিয়েবলে একটি এজেন্ট আইডি নির্ধারণ করুন:
AGENT=gpt-6-1-solএরপর স্থানীয় কনফিগারেশন সংরক্ষণ করুন:
python3 -m benchmark setup --agent "$AGENT"
নির্বাচিত ক্লায়েন্ট ও প্রমাণীকরণ প্রস্তুত আছে কি না পরীক্ষা করুন:
python3 -m benchmark cli-check --agent "$AGENT"চেকের ফল ready_for_trial হলে বর্তমান টাস্ক নির্বাচন ব্যবহার করে একটি ব্যাচ চালান:
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
  --agent "$AGENT" --out "./runs/current-$AGENT"
ডিফল্টভাবে ব্যাচ এক্সিকিউশন 70টি টাস্ক ও 83টি ধাপের প্রিভিউ দেখায়, কিন্তু মডেল কল করে না। আপনার অ্যাকাউন্টের বরাদ্দ ব্যবহার করতে প্রস্তুত হলে --execute যোগ করুন:
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
  --agent "$AGENT" --out "./runs/current-$AGENT" \
  --execute
cli-check সফল হওয়ার পর একটি ট্রায়াল টাস্ক দিয়ে শুরু করুন। পূর্ণ ব্যাচ চালানোর আগে এটি ক্লায়েন্ট, প্রমাণীকরণ পদ্ধতি, স্যান্ডবক্স এবং আউটপুট অবস্থান ঠিকমতো কাজ করছে কি না নিশ্চিত করতে সাহায্য করে।
একাধিক কনফিগারেশন চালান
প্রতিটি ক্লায়েন্ট আলাদাভাবে কনফিগার ও পরীক্ষা করুন, তারপর একটি ব্যাচ কমান্ডে একাধিক --agent অপশন দিন। একটি নতুন আউটপুট ডিরেক্টরি ব্যবহার করুন, যাতে বিভিন্ন কনফিগারেশনের ফলাফল একে অপরকে ওভাররাইট না করে।
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
  --agent gpt-6-1-sol \
  --agent claude-opus-5-5 \
  --out "./runs/comparison" \
  --execute
প্রতিটি কনফিগারেশনের প্রমাণীকরণ মোড রেজিস্ট্রিতে তালিকাভুক্ত ক্লায়েন্টের সঙ্গে সামঞ্জস্যপূর্ণ রাখুন। সাবস্ক্রিপশন-ভিত্তিক কনফিগারেশনে সেটির সমর্থিত সাবস্ক্রিপশন লগইন ব্যবহার করা উচিত, আর API কনফিগারেশনে প্রয়োজনীয় API শংসাপত্র ব্যবহার করা উচিত।
টাস্ক ও ফলাফল পরিদর্শন
টাস্ক ইনডেক্সটি config/selections/current.json-এ পাওয়া যায়। প্রশ্ন, মানদণ্ড ও স্কোরিংয়ের সংজ্ঞার জন্য প্রশ্ন ও স্কোরিং, ডেটা ফরম্যাট নির্দেশিকা এবং স্কোরিংয়ের নিয়ম দেখুন।
প্রকাশিত ফলাফল বিভিন্ন আকারে পাওয়া যায়:
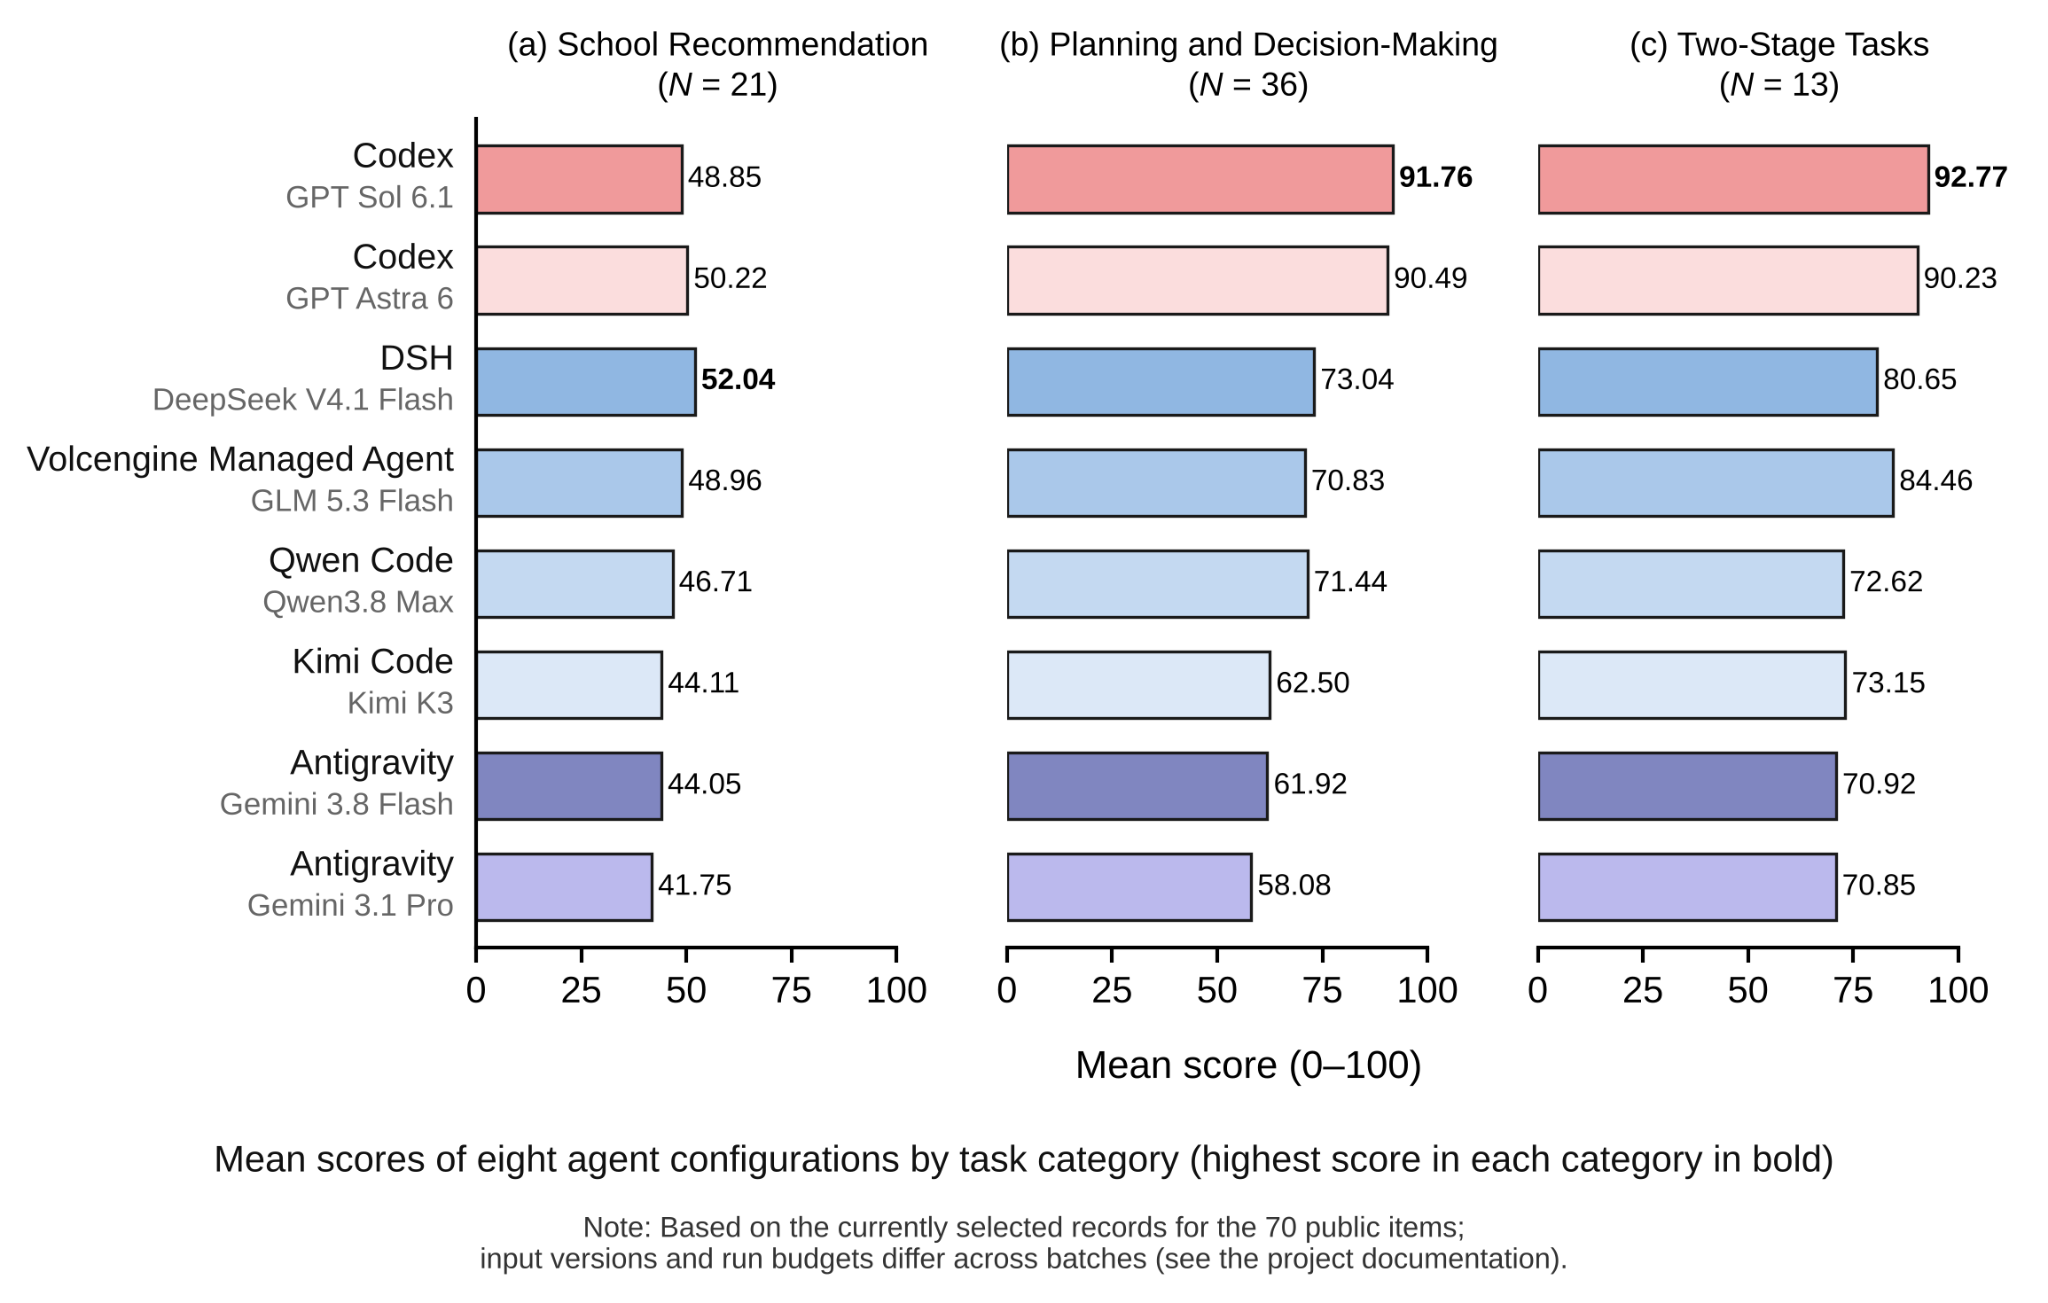
- সমষ্টিগত ফলাফলের জন্য স্কোরের সারাংশ।
- বিস্তারিত টাস্ক-স্তরের রেকর্ডের জন্য প্রতি-টাস্ক ফলাফল।
- প্রকাশ্য উত্তর ও মূল্যায়ন-সংক্রান্ত তথ্যের জন্য কনফিগারেশন অনুযায়ী উত্তর ও স্কোর।
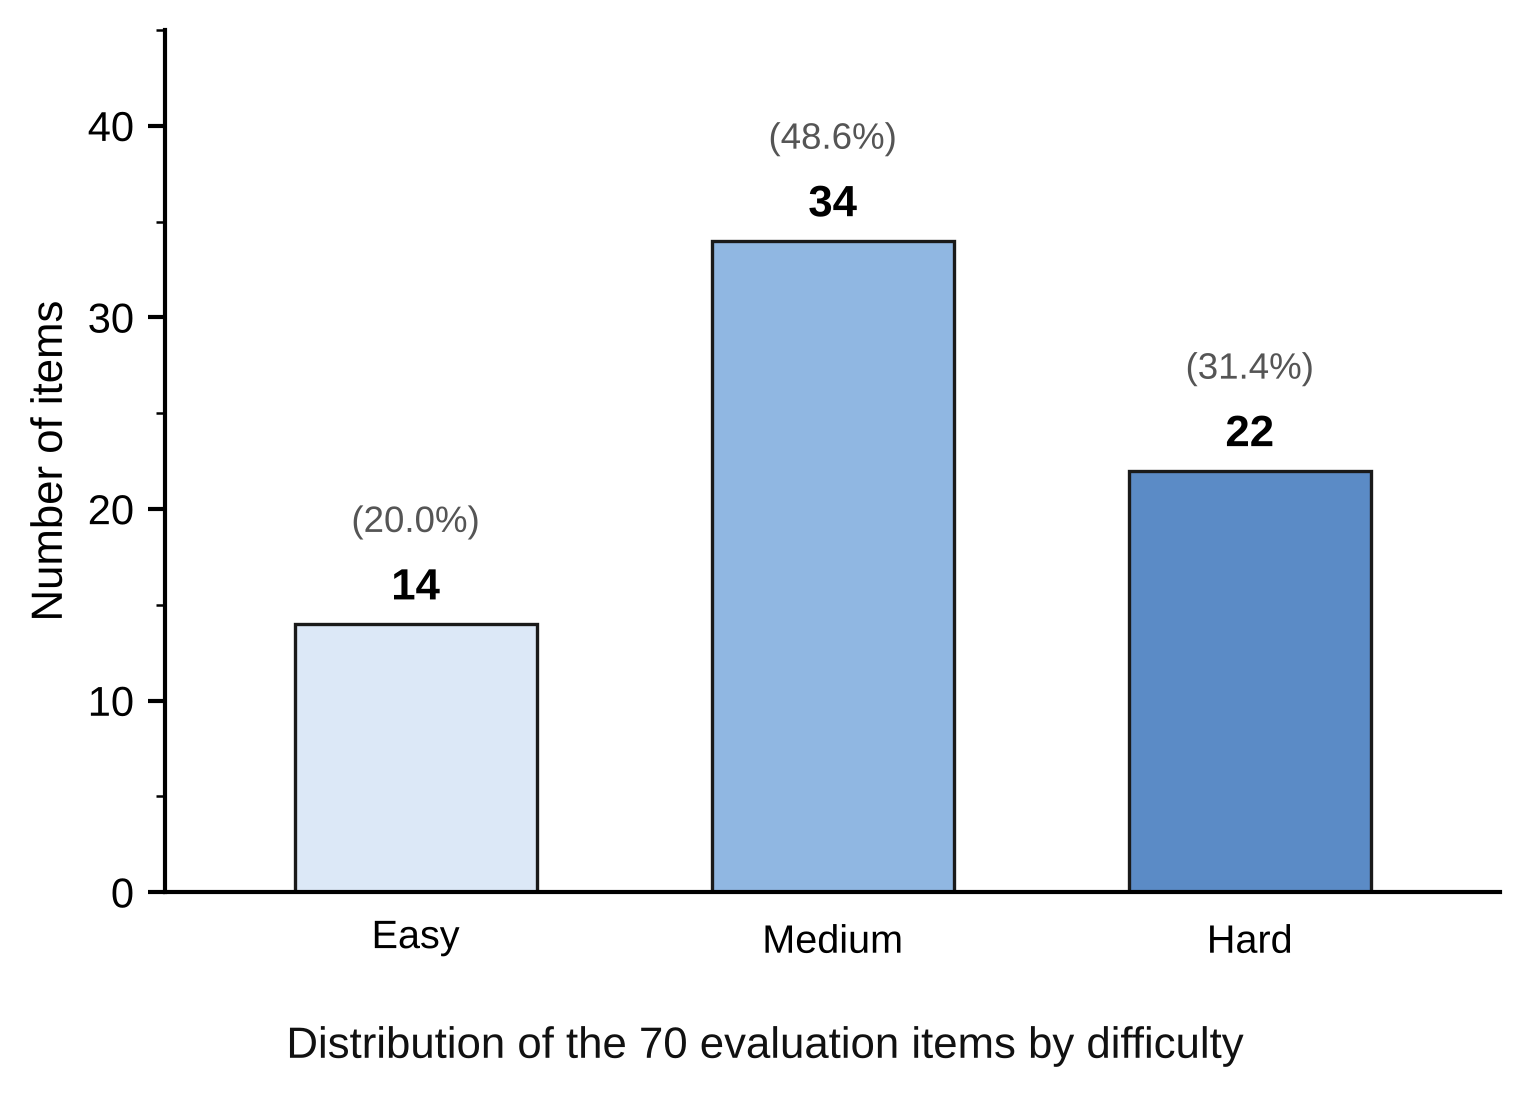
প্রকাশিত লিডারবোর্ডে মূল্যায়ন করা আটটি কনফিগারেশনের গড় স্কোর ও সম্পন্নের হার দেখানো হয়েছে। বর্তমান টাস্কগুলোর কঠিনতার লেবেলও রিপোজিটরিতে নথিবদ্ধ আছে: ১৪টি সহজ, ৩৪টি মাঝারি এবং ২২টি কঠিন। শিক্ষক-ক্যালিব্রেশনের মাধ্যমে মালিক এগুলো নিশ্চিত করেছেন; এগুলোকে স্বতন্ত্র দ্বৈত পর্যালোচনা হিসেবে উপস্থাপন করা হয়নি।
স্কোরিং ও পর্যালোচনার পরামর্শ
রপ্তানি করা উপকরণ পর্যালোচনার জন্য স্কোরিংয়ে আলাদা Codex সাবস্ক্রিপশন সেশন ব্যবহার করা হতে পারে। ঐচ্ছিক API বিচার ব্যবস্থার জন্য অতিরিক্ত কনফিগারেশন প্রয়োজন। উত্তর দেওয়ার প্রক্রিয়াকে স্কোরিংয়ের উপকরণ থেকে আলাদা রাখুন, কারণ মূল্যায়নাধীন এজেন্টকে রুব্রিক বা রেফারেন্স প্রোগ্রাম দেখালে তুলনাটি অবৈধ হয়ে যেতে পারে।
নিজস্ব রানগুলোর তুলনা করার সময় এজেন্ট আইডি, ক্লায়েন্ট সংস্করণ, ইনপুট সংস্করণ, এক্সিকিউশন বাজেট, আউটপুট ডিরেক্টরি এবং প্রাসঙ্গিক কনটেন্ট হ্যাশ নথিবদ্ধ করুন। প্রকল্পটি সতর্ক করে যে প্রকাশ্য লিডারবোর্ডের সব রান অভিন্ন এক্সিকিউশন পরিস্থিতিতে সম্পন্ন হয়নি; তাই পদ্ধতিবিদ্যা ও রান রেকর্ডের সঙ্গে মিলিয়ে ফলাফল তুলনা করুন।
পুনরুৎপাদনযোগ্য পরীক্ষার জন্য পুনরুৎপাদন নির্দেশিকা অনুসরণ করুন, যেখানে স্থির ইনপুট, সাবমিশন ও স্কোর যাচাই নিয়ে আলোচনা করা হয়েছে। পদ্ধতিবিষয়ক নথি-তে মূল্যায়নের সেটিংস ও সীমাবদ্ধতা ব্যাখ্যা করা হয়েছে, আর নেটিভ CLI নির্দেশিকা-তে ইনস্টলেশন, প্রমাণীকরণ ও একাধিক ধাপ সম্পর্কে আরও বিস্তারিত দেওয়া আছে।
উপসংহার
Graduate Admissions Agent Benchmark একটি কাঠামোবদ্ধ উপায়ে পরীক্ষা করতে সাহায্য করে যে ভর্তি-সংক্রান্ত এজেন্টরা সঠিক সুপারিশ, কার্যকর পরিকল্পনা-পরামর্শ এবং শিক্ষার্থীর পরিস্থিতি বদলালে উপযুক্ত আপডেট দিতে পারে কি না। সমর্থিত ক্লায়েন্ট সেট আপ করুন, রেজিস্ট্রি থেকে একটি এজেন্ট আইডি নির্বাচন করুন, cli-check দিয়ে সেটি যাচাই করুন, ব্যাচের প্রিভিউ দেখুন, তারপর ট্রায়াল বা পূর্ণাঙ্গ মূল্যায়ন চালান। স্কোর দায়িত্বশীলভাবে ব্যাখ্যা করতে এবং তুলনা পুনরুৎপাদন করতে প্রকাশিত টাস্ক সংজ্ঞা, ফলাফল ও পদ্ধতিবিষয়ক নথি ব্যবহার করুন।