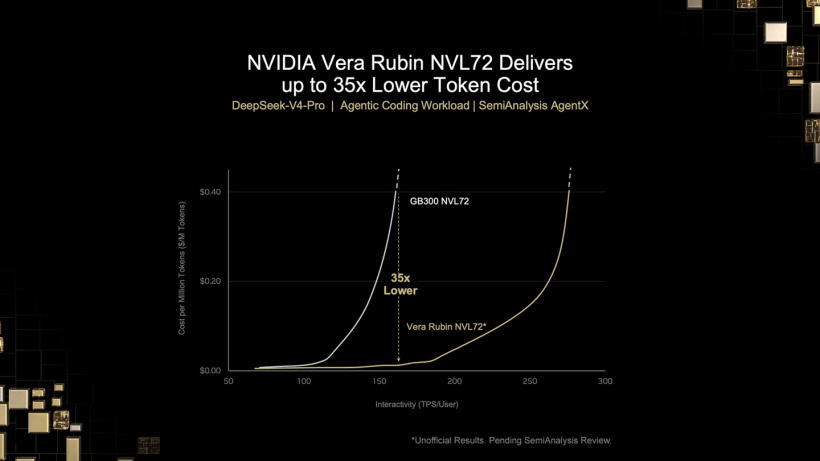
NVIDIAは昨日、SemiAnalysis AgentXワークロードを使用し、DeepSeek-v4-PRO 1.6Tモデルで評価テストを実施しました。その結果、Vera Rubinの1メガワット当たりスループットはBlackwellの30倍に達しました。
1メガワット当たりスループット(Tokens per Megawatt、略称 tokens / MW)は、AIデータセンターが限られた電力枠でどれだけのAIトークンを生成できるかを測る中核的な電力効率指標です。
IT之家がブログ記事を引用して紹介したところによると、SemiAnalysis AgentXは4つの指標を通じて、エージェント型コーディング推論ワークロードを重点的に評価します。
エンドツーエンドの正規化インタラクティビティは、リクエストの送信から最終トークンの到着までの全時間で算出し、最初のトークンを待つ時間を含む、ユーザーが目にする出力効率を反映します。
標準インタラクティビティは、最初のトークンから最後のトークンまでの生成段階のみを集計します。
エンドツーエンド遅延は、1回のリクエストの送信から最終出力トークンの到着までに要する総時間を集計します。
初回トークン遅延(TTFT)は、リクエストの送信から最初の出力トークンが到着するまでの時間を集計します。
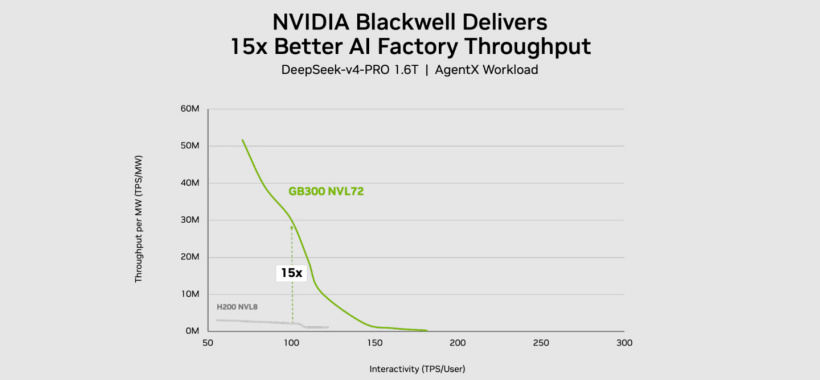
DeepSeek-v4-PRO 1.6Tワークロードでは、GB300 NVL72を採用したGrace Blackwellサーバーの1メガワット当たりスループットは、H200 NVL8 Hopper構成の15倍に達しました。
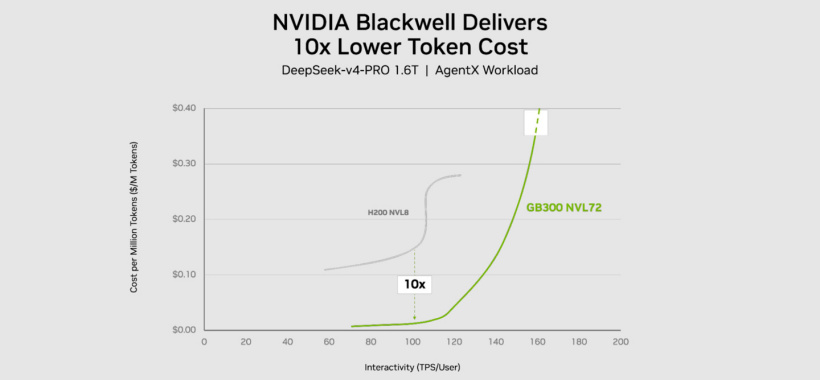
Blackwellの100万トークン当たりコストは前世代の約10分の1です。運用者は同じ電力とインフラ予算でより多くのエージェントをサポートできるほか、より低い運用コストで同じエージェント容量を維持できます。
Vera Rubinはこの優位性をさらに高めます。DeepSeek V4 Proモデルにおいて、Vera Rubin NVL72の1メガワット当たりスループットはGB300 NVL72の約30倍です。
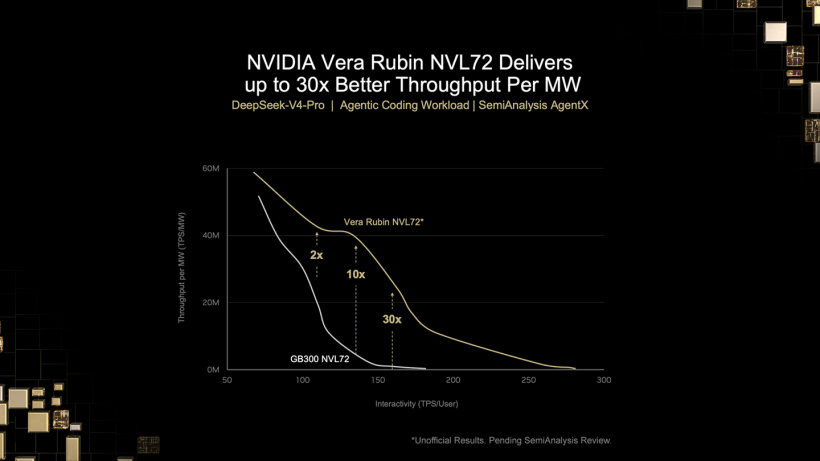
Vera Rubin NVL72の100万トークン当たりコストはGB300 NVL72の35分の1であり、エージェントを継続的かつ大規模に稼働させ、顧客のさまざまなワークロードのニーズに応えられます。