

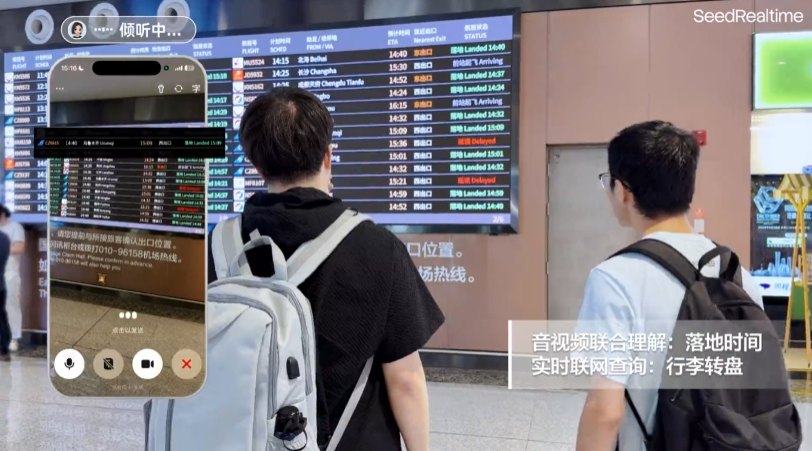
ByteDanceのSeedは本日、ネイティブ音声・映像全二重モデル「SeedRealtime」を発表し、全モーダルによる自然なインタラクションの実現に向けて前進しました。
SeedRealtimeは、統一アーキテクチャで音声・映像・テキストをネイティブに融合し、連続するマルチモーダル情報ストリーム上でリアルタイムに対話できます。「見ながら、聞きながら、話す」という新しい体験を実現します。主なブレークスルーは次の3点です。
音声・映像の統合理解:音声、映像、時間情報の高度な融合をネイティブにサポートします。モデルはシーンを踏まえて同音異義語の曖昧さを解消できるだけでなく、映像内の時間的な指示も正確に理解し、見たもの、聞いたもの、話した内容を一体化します。
能動的なインタラクション能力:継続的な環境認識と能動的な発話能力を備えています。映像の状態変化(重要な対象の出現など)を察知すると自発的に知らせることができ、ツールを呼び出して表現に取り入れることもできます。インタラクションを受動的な応答から能動的な協働へと進化させます。
スムーズな対話のリズム:ユーザーの会話状態や交流のテンポをリアルタイムに把握し、適切なタイミングで自然に会話へ参加したり、間を置いたり、応答したりできます。同時に高い耐干渉性も備え、周囲の雑談や背景ノイズを聞き分け、干渉による誤起動を防ぎながら、円滑で一貫したコミュニケーションを維持します。
エンドツーエンドの人手評価では、カスケード型モデルと比較して、SeedRealtimeの音声・映像対話におけるリズムの問題が半減しました。話すタイミングの把握がより自然になり、「話し終わる前に割り込まれる」「話し終わっても応答が遅れる」「背景の雑音や雑談で誤起動する」といったつまずきが大幅に減少しました。また、1回の対話を完全かつスムーズに進められる確率も大きく向上しています。
現在、SeedRealtimeは豆包アプリで全面的に提供されており、業界に先駆けて音声・映像全二重技術の大規模導入を実現しました。豆包アプリを最新バージョンに更新し、対話画面で「電話をかける」を選択してビデオ通話画面に入ると体験できます。
プロジェクトのホームページ:
https://seed.bytedance.com/seedrealtime