

Alibabaは本日、音声認識大規模モデル「Qwen-Audio-3.0-ASR-Flash」を発表しました。簡単に言えば、AIが専門用語をより正確に聞き取れるようにするモデルです。
Qwen-Audio-3.0-ASR-Flashは、文脈の一貫性、業界用語の認識、ホットワードのカスタマイズという3つの側面で体系的な最適化を実施しました。さらに、音声を整える機能も備え、構造化テキストを直接出力できます。
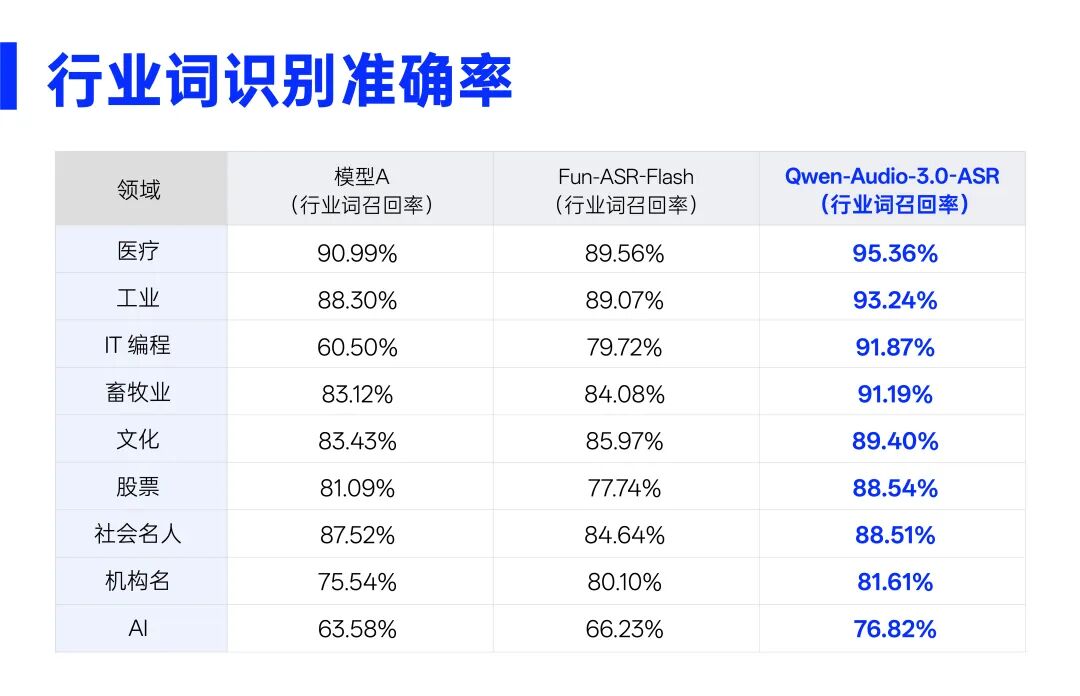
研究チームは医療、ITプログラミング、株式、著名人などの分野から専門用語を継続的に収集し、複数の業界をカバーする高品質な用語集を構築しました。これにより、専門用語や珍しい単語の認識能力を高めています。最新の業界用語に関する内部評価では、新モデルの各業界における専門用語の「聞き取り率」が大幅に向上し、特に医療分野では95.36%を突破しました。
現在、Qwen-Audio-ASR-Flashシリーズは、会議議事録の作成、リアルタイム字幕、教育動画の録画、スマートカスタマーサービスなどの場面で検証されています。AI評価プラットフォームArtificial Analysisでは、誤字率1.7%で世界1位を獲得した実績もあります。
Qwen-Audio-3.0-ASRは、Alibaba Cloud百炼プラットフォームを通じて利用でき、3つのバージョンを提供しています。
Qwen-Audio-3.0-ASR-Flash:音声認識、最長5分
Qwen-Audio-3.0-ASR-Filetrans:オフラインファイルの文字起こし
Qwen-Audio-3.0-ASR-Streaming:リアルタイム音声認識
Qwen-Audio-3.0-ASR-Flashの体験ページは以下のとおりです。
Qwen-Audio-3.0-ASR-Flash:
https://help.aliyun.com/zh/model-studio/non-real-time-speech-recognition-for-fun-asr-flash
Qwen-Audio-3.0-ASR-Flash-Filetrans:
https://help.aliyun.com/zh/model-studio/fun-asr-recorded-speech-recognition-http-api
Qwen-Audio-3.0-ASR-Flash-Streaming:
https://help.aliyun.com/zh/model-studio/fun-asr-realtime-websocket-api