

Googleは本日、最新のGemini 3.7 Flash、3.6 Flash、3.5 Flash-Liteモデルに、エージェント型動画理解(agentic video understanding)機能を導入したと発表しました。この新機能により、動画分析の精度を高めながら、分析プロセスで使用するToken量とコストを大幅に削減できます。
この機能は標準のGemini API Token料金で利用でき、追加の機能料金はかかりません。
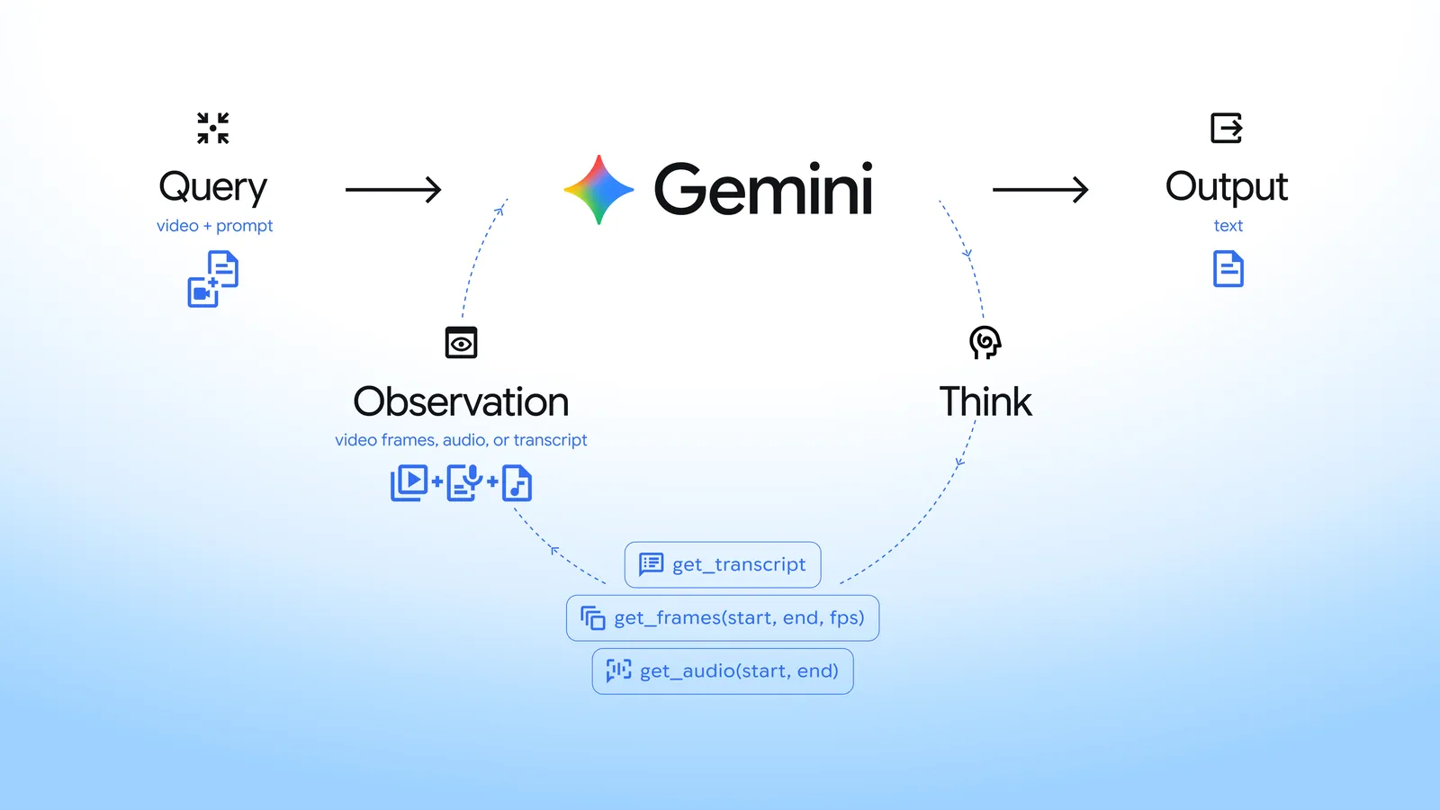
従来の「静的」な処理方式では、モデルが固定フレームレートで動画を読み取ります。デフォルトは1 FPSで、APIから変更できます。一方、エージェント型動画理解では、モデルの中核推論とネイティブ動画ツールを組み合わせ、映像フレーム、音声、文字起こしテキストから対象動画の部分を動的に検索、スキャン、確認できます。
標準的な動画分析ベンチマークテストでは、エージェント型動画理解を搭載したGeminiモデルにより、分析コストを最大66%、Token消費量を最大88%削減しながら、精度を最大7%向上できます。この効率向上は長時間動画の場面で特に顕著です。従来の静的処理では、開発者は高いTokenコストと重要な細部の見落としの間で妥協せざるを得ませんでした。
Googleによると、Gemini 3.7 Flashとエージェント型動画理解の組み合わせは、総合的に最高の品質を実現します。同時に、品質とコスト効率の最適なバランスを達成し、動画理解タスクにおいて精度とコストのパレート最適フロンティアに位置します。
静的処理ではモデルが固定フレームレートでメディアストリームを読み取りますが、エージェント型動画理解では、Geminiがどの内容をどの速度で見るか、どのモダリティ(フレーム、音声、文字起こしテキスト)から情報を取得するかを、目的に応じて主体的に判断できます。必要な部分とシグナルだけを抽出する仕組みです。これまで開発者が手動で行っていた操作を、エージェント型動画理解ではGeminiがインテリジェントなループを通じて実行し、内部ツールを呼び出して動画の関連部分を読み込むことで、開発作業の負担を大幅に軽減できます。
IT之家が確認したところ、この機能により、開発者は長時間動画の処理でさまざまな新機能を利用できるようになります。
1秒未満の時点検索:1 FPSでは見逃しやすい瞬間的な状態変化や短い編集カットの境界を正確に特定し、高精度な動画編集を自動化できます。
長時間動画からの「針探し」検索:数時間に及ぶ動画について、数百万Tokenを消費することなく複雑なクエリに回答できます。
異常検出:関心のある時間帯をより高いフレームレートで再サンプリングし、高速な動きや微細な映像アーティファクトを確認できます。
動作と物体のカウント:時間の経過に伴う反復的な物理動作や異なる物体を正確に追跡できます。
現在、この機能はGoogle AI StudioとGemini Enterprise Agent PlatformのGemini APIで提供されており、動画のアップロードとYouTube動画の分析に対応しています。開発者はAPI設定で処理モードを「agentic」に設定するだけで、この機能を有効化できます。
Googleは今後、この機能を一般ユーザー向けのより多くの製品にも展開する計画です。近日中に、GeminiアプリのすべてのFlashおよびFlash-Liteモデルユーザーへ提供される予定です。今後数か月以内には、エージェント型動画理解がYouTube動画視聴ページの「Ask YouTube」機能にも利用され、Geminiによって動画映像に基づく、より質の高い回答を提供します。