

アリババ傘下の百霊大規模モデルは昨日、次世代のネイティブ混合推論モデルLing-3.0-flashが正式にオープンソース化されたと発表した。
Ling-3.0-flashは、総パラメータ124B、アクティブパラメータ5.1BのMoEアーキテクチャを採用している。公式は基盤モデルに加え、FP8、FP4、INT4など複数のバージョンも同時に提供し、次の3種類の導入方法を用意している。
API呼び出し:迅速な接続を希望し、自前の推論サービスを構築する必要がない開発者向け。Ling-3.0-flashはクラウドAPIから直接呼び出せる。
単一マシンでのプライベート導入:データを外部に持ち出せない企業やチーム向け。MXFP4およびINT4バージョンは、1台のNVIDIA DGX Spark上でエンドツーエンド推論を実行できる。
高性能デプロイ:1リクエストあたりのレイテンシーが重視される高性能サービス向け。指定されたGPUテスト構成では、平均出力速度が1100 tokens/sを超えた。
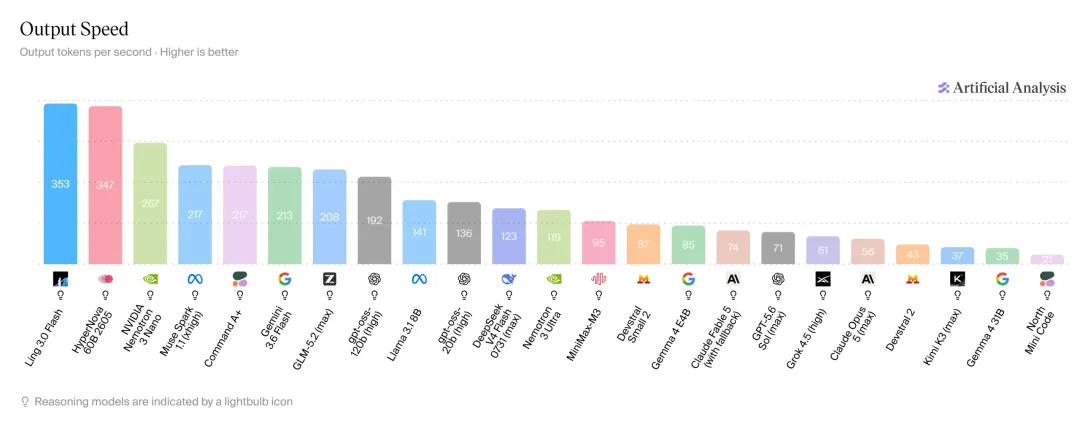
製品の迅速な検証やAgentアプリケーションのリリースを目指す開発者・プロダクトチームにとって、APIは最も導入のハードルが低い方法だ。Artificial Analysisのランキングでは、Ling-3.0-flashの出力速度は353 tokens/sに達している。
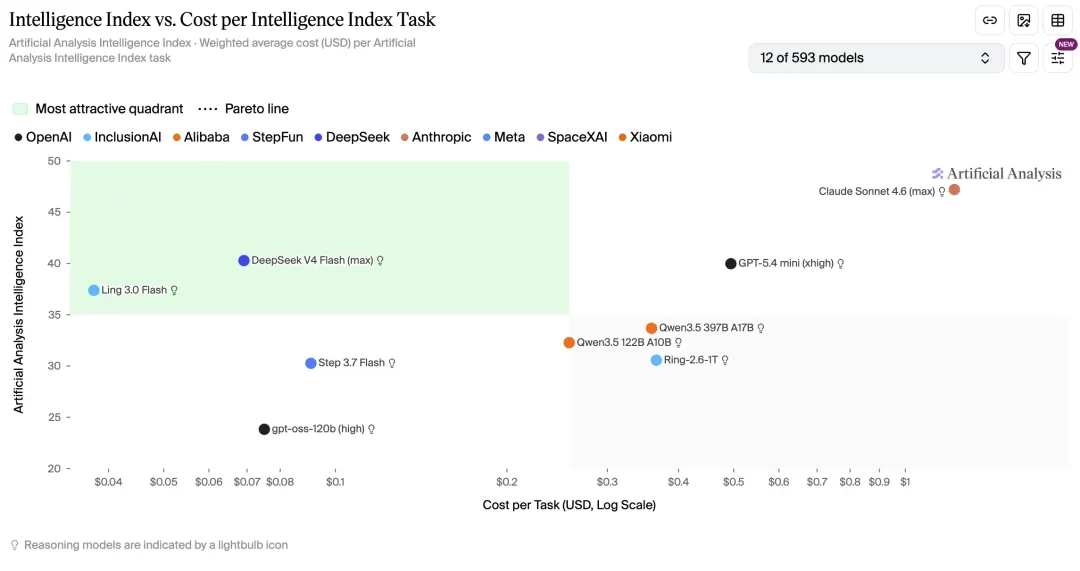
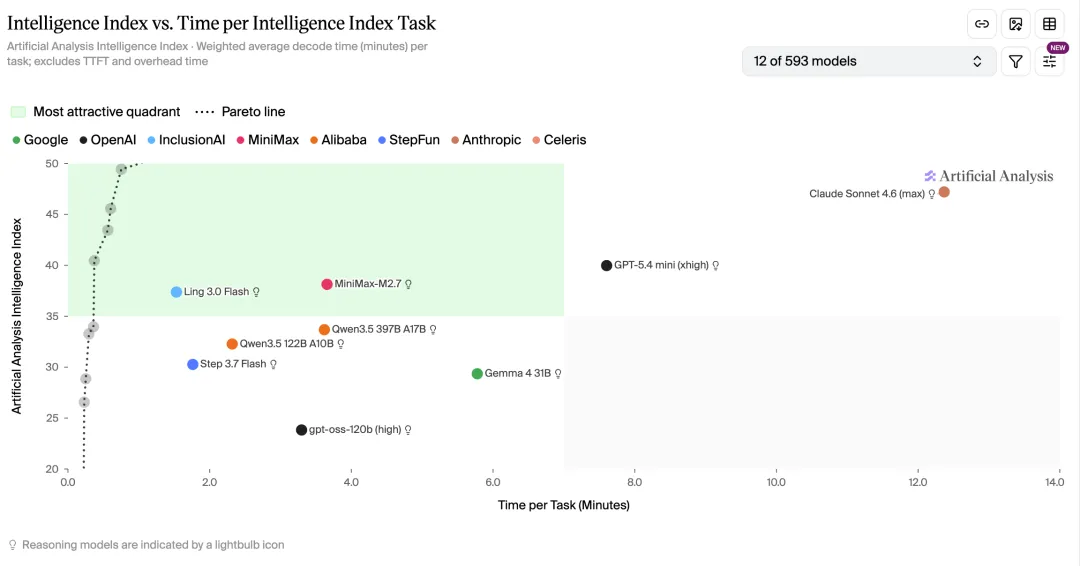
AA Intelligence Indexのランキングでは、Ling-3.0-flashのタスクごとの加重平均呼び出しコストは約0.04ドル(現在の為替レートで約0.27人民元)、加重平均デコード時間は約1.4分となっている。また、「知能レベル — タスクコスト」と「知能レベル — タスク所要時間」の両方で優位性のある領域に入っている。
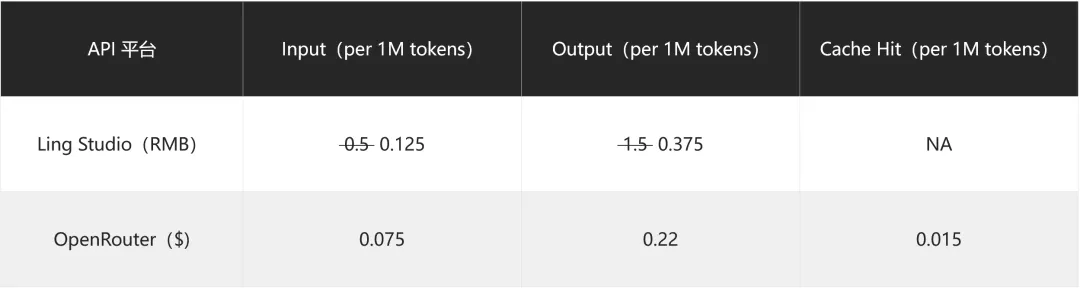
公式によると、2026年8月7日00:00から8月31日24:00まで、Ling-3.0-flashはLing Studioで期間限定の75%割引が適用される。9月1日00:00から通常価格に戻る。
オープンソースリンク:
Hugging Face: https://huggingface.co/inclusionAI/Ling-3.0-flash
ModelScope: https://modelscope.cn/models/inclusionAI/Ling-3.0-flash