具身知能企業のDyna Roboticsがロボット基盤モデル「DYNA-2」を発表した。100万時間を超える一人称視点の人間動画で学習し、タスク成功率は最大90%に達する。
DYNA-2は、公式にはワールド・アクション・モデル(World Action Model)と位置付けられており、人間の活動を観察することで、動作が物理世界をどのように変化させるかを学習することを目指す。関連するスクリーンショットは以下のとおり。
学習面では、DYNA-2の事前学習は人間の動画データだけに依存しており、100万時間を超える一人称視点の人間動画を使用する。これは人間の経験に換算すると170年分に相当する。
共同創業者のJason Ma氏は、汎用ロボットは長年データ不足に制約されており、物理的な遠隔操作データを人手で収集する方法では汎用知能にまで拡張するのが難しいと説明。DYNA-2は人間の活動を観察することで、動作が物理世界をどのように変化させるかを学習するという。
同社によると、DYNA-2は動作を起こす前に物理世界がどのように動くかを予測することで、従来の視覚言語モデル(vision-language models)に不足していた空間推論能力と接触物理の能力をロボットに補える。
このモデルは、動画の次のフレームの内容と、実行すべき動作を予測する2つの学習目標を通じて、空間関係や動き方、物体が接触を受けた際の反応などに関する情報を獲得する。
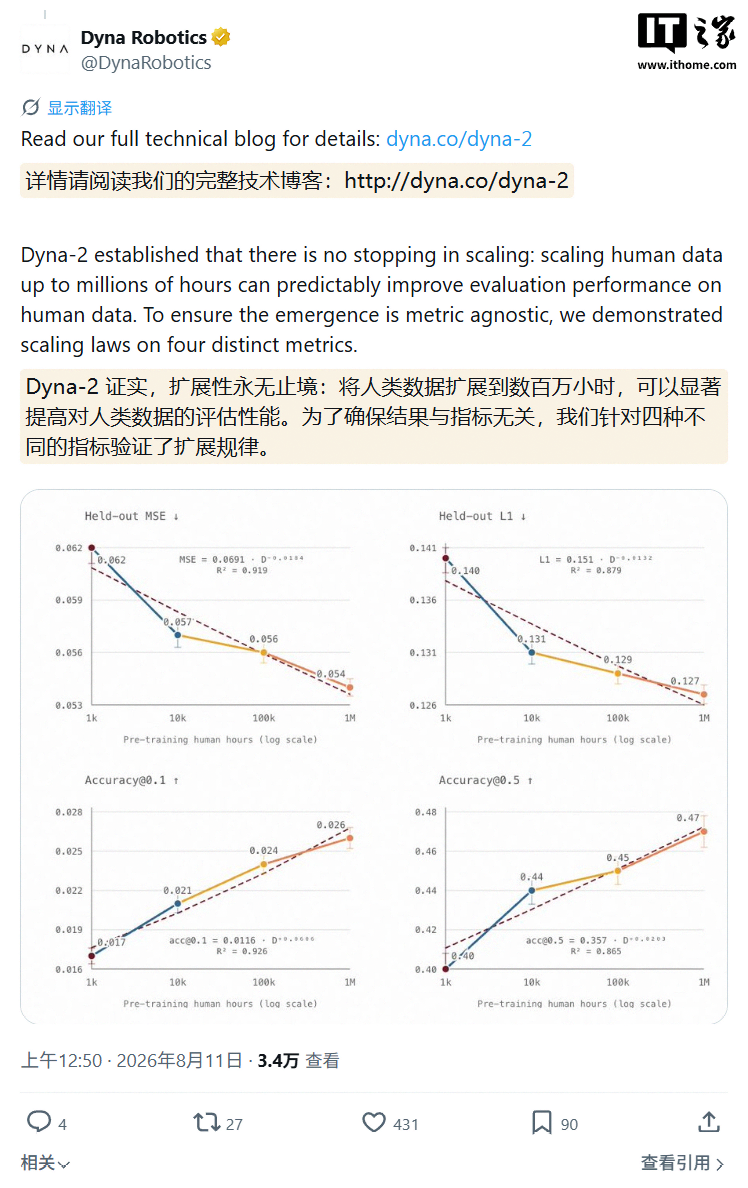
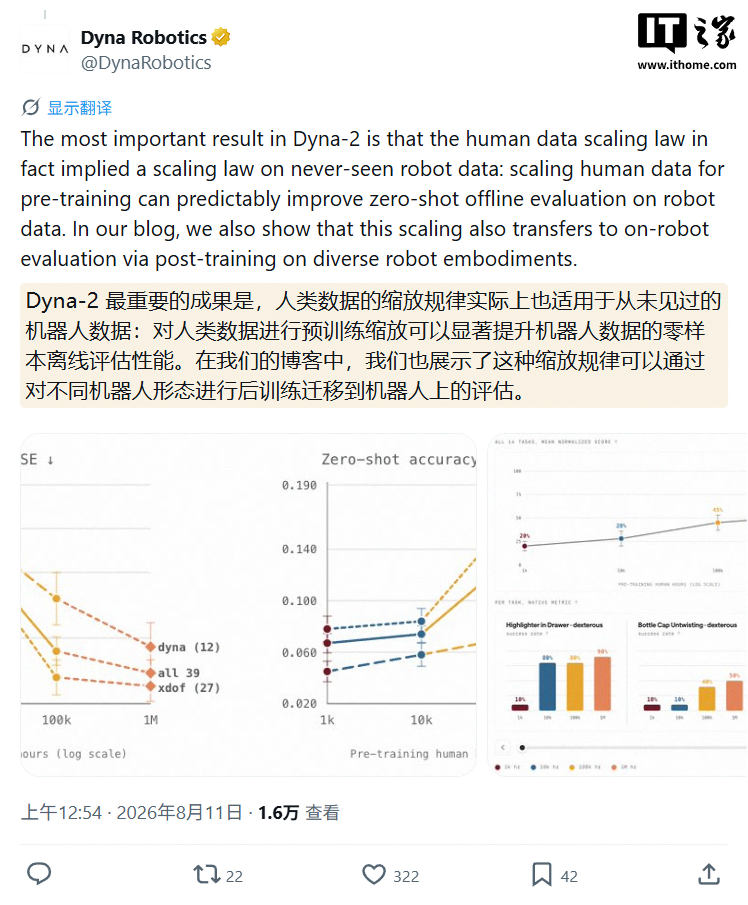
Dyna Roboticsが公開した結果によると、事前学習段階に人間の動画データを追加するほど、ロボットの15項目のベンチマークタスクにおける性能が向上した。同社はこの現象を「人間からロボットへのスケーリング則」と呼び、学習データの規模が拡大するにつれて、性能は比較的予測可能な形で向上するとしている。
ある実験では、ロボット専用データ13分分だけで、5本指のロボットハンド2台がボトルキャップを開けられるようになった。製造タスクでは、後学習データセットを変えないまま、事前学習の規模を拡大すると、成功率は約20%から80~90%へ向上した。
Dyna Roboticsはさらに、Dyna-2が1件の顧客導入で87%の品質合格率を達成したと説明している。前世代のDyna-1は46%だった。ユーザーの指示に応じて異なる動作を実行する必要があるタスクでは、動画との協調学習によりスコアが133%向上した。