

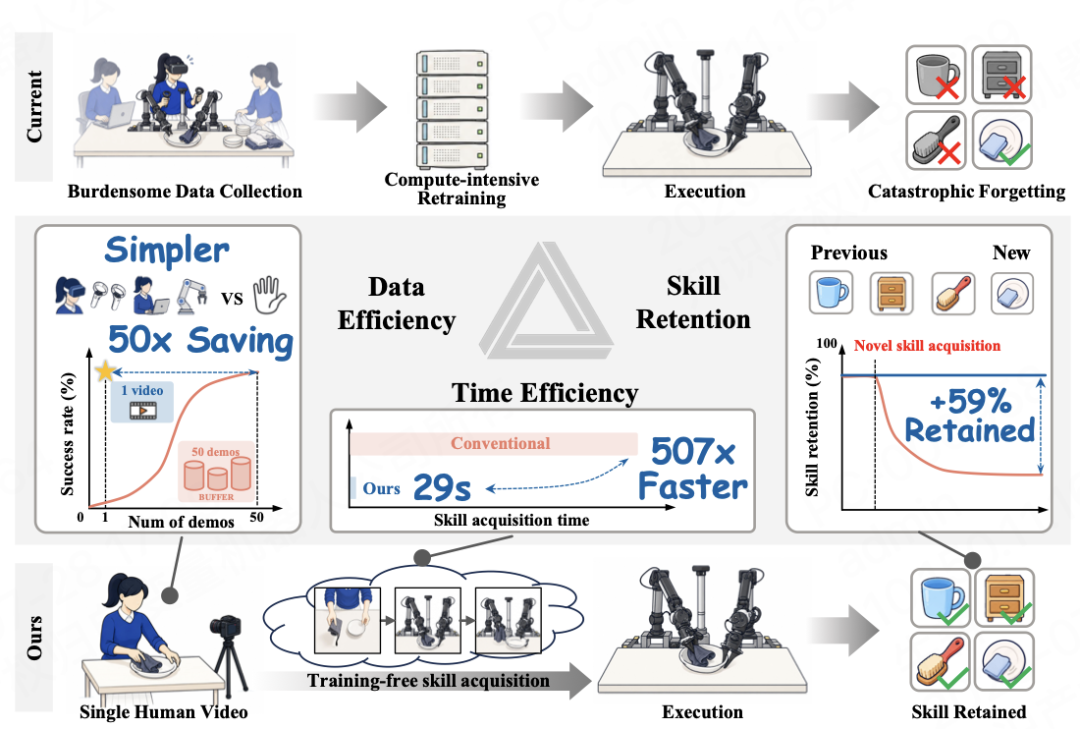
自变量ロボットは本日、HOSTフレームワーク(Human-to-robot One-Shot Skill AcquisiTion、人間からロボットへのワンショット・スキル獲得)を発表し、オープンソース化した。同社によれば、ロボットは数十秒間の人間の動画を見るだけで新しいスキルを習得でき、すでに身につけたスキルも保持できるという。
HOSTは画期的な手法を採用している。人間の動作をロボットの動作に翻訳して模倣させるのではなく、まず動作を実行した後の結果をロボットに想像させ、その結果から必要な動作を分解して導き出す。この新しい手法は良好な成果を上げている。ロボットが29秒間の人間の動画からスキルを学習した場合、成功率は最高62%に達し、ゼロショットのベースラインである45%を上回った。Pi-0.5+ファインチューニング方式と比べ、HOSTに必要なデータ量は50分の1、スキル学習速度は500倍になった。
HOSTの発想は、認知科学における「観察学習」理論に由来する。人間は不慣れなタスクに直面した際、長期間の練習や総当たりによる試行を必要とせず、既存の能力を使って脳内で動作の予想結果をシミュレーションし、その後に対応する動作を実行する。自变量の研究者はこれに着想を得て、HOSTの学習方式を「訓練時のファインチューニングループ」から「推論時のスキル獲得」へと転換し、ロボットが人間のタスク実行を観察して新しいスキルを学習できるようにした。
ロボットがまず解決しなければならない問題は、自身のタスク実行の進捗と動画内の進捗をどのように同期させるかという点だ。
例えば、同じく10秒間作業したとしても、動画内の人間はすでに食材を切り終えて炒め始めている一方、ロボットはまだ食材を切っている可能性がある。単純に時間だけで同期すると、ロボットはタスクの進捗を失ってしまう。
これに対してHOSTは、「タスクの進捗に応じたアライメント」を行う。HOSTは動画の各フレームとロボットの操作の各ステップを、同じベクトル空間内のベクトルに変換する。その後、「動的時間伸縮」アルゴリズムを利用して、「人間の動画のXフレーム目」と「ロボット操作のYステップ目」を自動的に対応付ける。これにより、ロボットは各ステップを実行する際、常にタスクの進捗に対応したフレームを見ることができる。
この手法により、HOSTはタスク進捗の同期における時間誤差を1桁削減し、ロボットの実行と動画のデモンストレーションを正確に同期できるようにした。
HOSTの中核は、視覚予測機能を備えたカスケード型ポリシーモデルだ。2つの専門家からなるMoTアーキテクチャを採用しており、役割の明確に分かれた2つの脳のように機能する。「視覚の脳」(動画専門家)は動画の映像処理、タスクの進捗の特定、未来の状況の予測を担当し、「動作の脳」(動作専門家)は予測された状況を実行すべき動作に変換し、その実行を制御する。
モデルの訓練では、自变量チームは訓練過程を「同一身体による事前訓練」と「人間・ロボット動画訓練」の2段階に分けた。同一身体による事前訓練の段階では、ロボット自身がタスクを実行する動画を学習し、タスク完了後の状態を予測するとともに、対応する動作を生成する。人間・ロボット動画訓練の段階では、ロボットはさらに人間のデモンストレーション動画を学習し、人間によるタスク実行の過程をロボット視点でのタスク結果に変換する。そのうえで、目標結果からタスク完了に必要な動作を推論し、人間のデモンストレーションからロボットのスキルへの移行を実現する。
現在、HOSTの研究論文とコードはすべてオープンソース化されている。将来、家庭内で作業するロボットは、専門的なデータ収集や訓練の過程を省き、人間による直感的なデモンストレーションを見るだけで新しいスキルを習得できるようになる可能性がある。
参考
プロジェクトホームページ
論文リンク
Githubリンク
Huggingfaceリンク