

本日、MiniMaxは次世代の汎用動画モデルMiniMax H3を正式にオープンソース化しました。
紹介によると、MiniMax H3は汎用型の全モーダル生成システムです。テキスト、画像、動画、音声で構成されるマルチモーダルコンテキストを統合的に理解し、最大2K解像度、最長15秒、ネイティブステレオ音声付きの動画を生成できます。タスクの汎化を重視したシステム設計により、H3は事前学習段階から幅広いマルチモーダルコンテキストの理解・生成能力を備えており、複雑なマルチモーダル指示にも優れた形で従うことができます。
H3は以下の入力・出力仕様に対応しています。
出力時間:4–15秒
出力アスペクト比:21:9、16:9、4:3、1:1、3:4、9:16など、複数のアスペクト比に対応
出力解像度:複数の解像度に対応し、デフォルトでは短辺を768ピクセルに設定。H3-Regenerate-2Kを使用すると2K解像度で生成可能
出力フレームレート:24 FPS
出力音声:32 kHzステレオ
対応する会話言語:アラビア語、中国語、英語、フランス語、ドイツ語、イタリア語、日本語、韓国語、ポルトガル語、ロシア語、スペイン語の11言語を安定してサポート。その他の言語にも一定程度対応
モデルバージョンと入力仕様:
① H3-Base-FL2VA
始端・終端フレームモード:0枚、1枚、または2枚の画像入力に対応:
画像を入力しない場合は、テキストから動画を生成するモードです。
始端フレーム画像を入力すると、始端フレームからの動画生成モードになります。
終端フレーム画像を入力すると、終端フレームからの動画生成モードになります。
始端フレームと終端フレームの画像を同時に入力すると、始端・終端フレームからの動画生成モードになります。
② H3-Base-Ref2VA
全モーダル参照モード:
画像:最大9枚
動画:最大3本。各動画の長さは2–15秒、合計時間は15秒以内
音声:最大3本。音声は画像または動画と一緒に入力する必要があり、単独入力は不可。各音声の長さは2–15秒、合計時間は15秒以内
混合入力:すべての種類の入力ファイルを合計12個まで
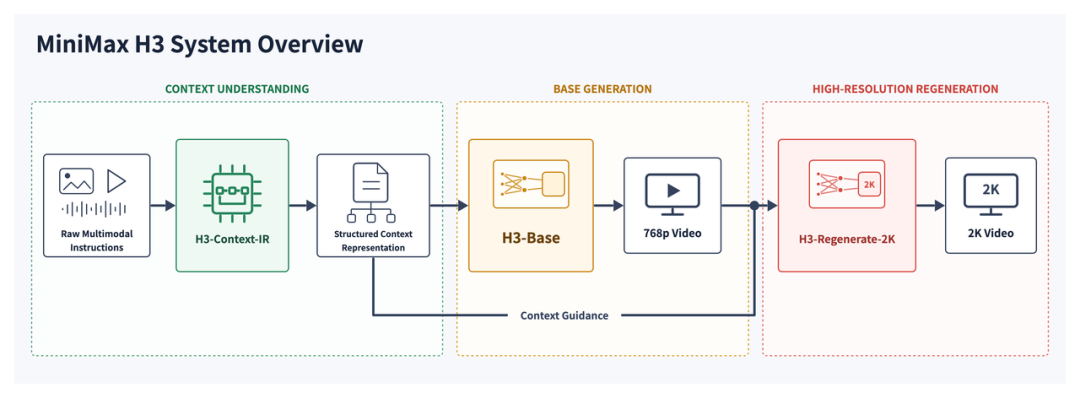
H3システム全体は、以下の3つのモジュールで構成されています。
H3-Contex t-IR:入力がますます複雑になる中、私たちは入力されたマルチモーダル指示を深く理解・抽出し、H3が理解しやすく、生成に直接利用できる形式であるContext Intermediate Representation(コンテキスト中間表現)へ変換する専用システムを構築しました。H3-Context-IRは最終出力の品質にとって非常に重要です。そのため、H3-Context-IR APIを生成フローに組み込むことを強く推奨します。また、プロンプトガイドを参考に独自のコンテキスト処理システムを構築することもできます。
H3-Base:H3-Context-IRの出力に基づいて音声と動画を生成し、768p解像度の結果を出力します。
H3-Regenerate-2K:768pの生成結果を元のコンテキストとともにH3へ再入力し、2K解像度で出力を再生成します。これにより、H3の強力な生成能力を活かしながら、元のコンテキストに含まれる豊富な情報も十分に利用でき、細部の正確性と映像の忠実度がより高い高解像度の結果を生成できます。
MiniMax H3はMiniMax H3 Community Licenseに基づいて公開されています。
オープンソース: huggingface.co/MiniMaxAI/MiniMax-H3