

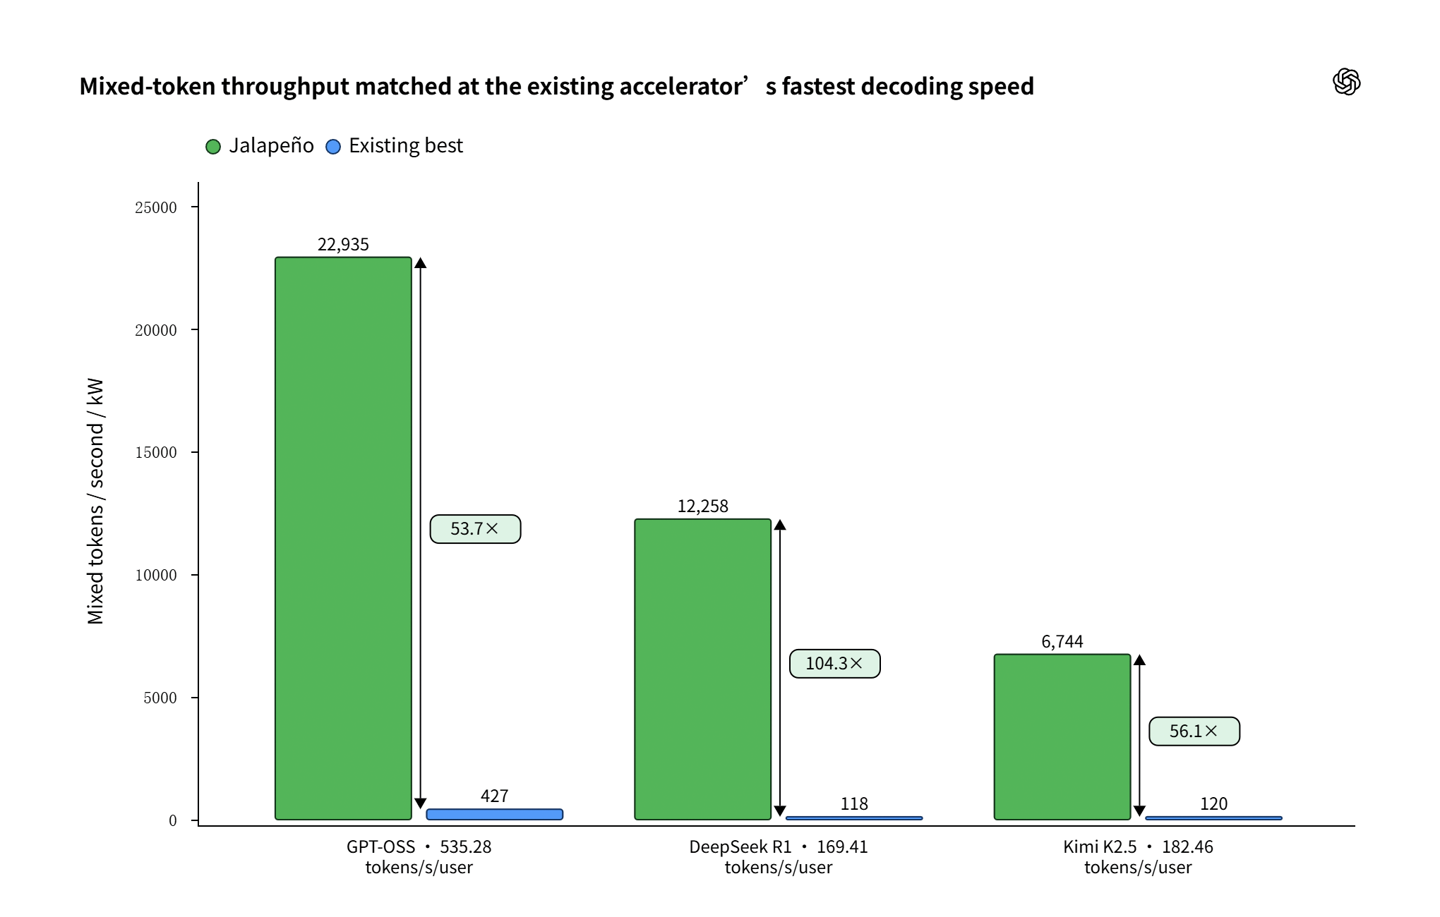
OpenAIは昨日(8月25日)、初の自社開発Jalapeñoチップを紹介するブログ記事を公開し、単一ユーザーでのトークン処理量、1キロワット当たりのスループットのいずれも、現在市場にある最先端の推論プロセッサーを上回ると説明した。
公式ブログ記事でOpenAIは、半導体研究企業SemiAnalysisが開発した公開ベンチマークツールInferenceXを使い、GPT-OSS 120B、DeepSeek R1 670B、Kimi K2.5 1Tの3モデルでテストを実施した。
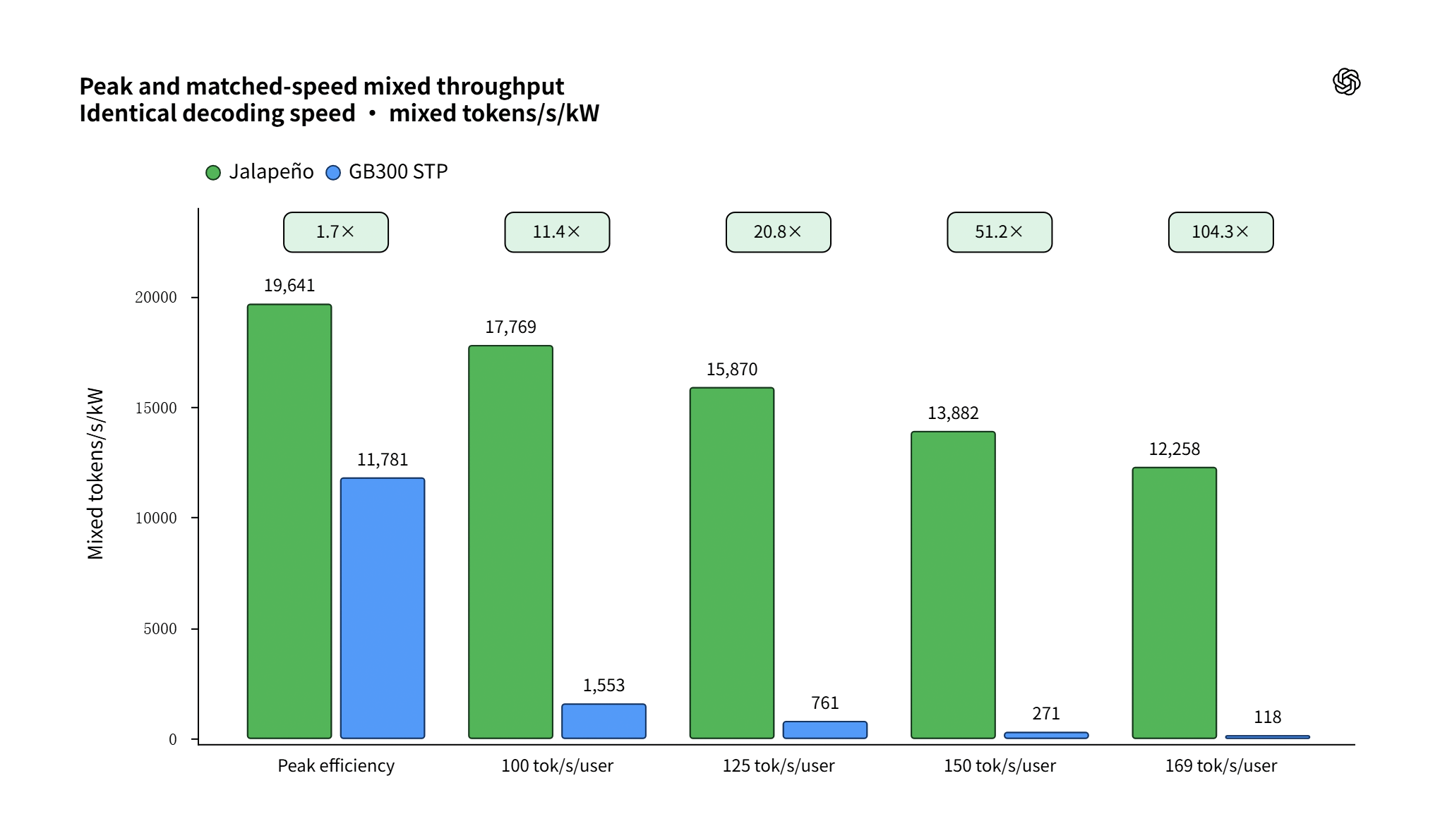
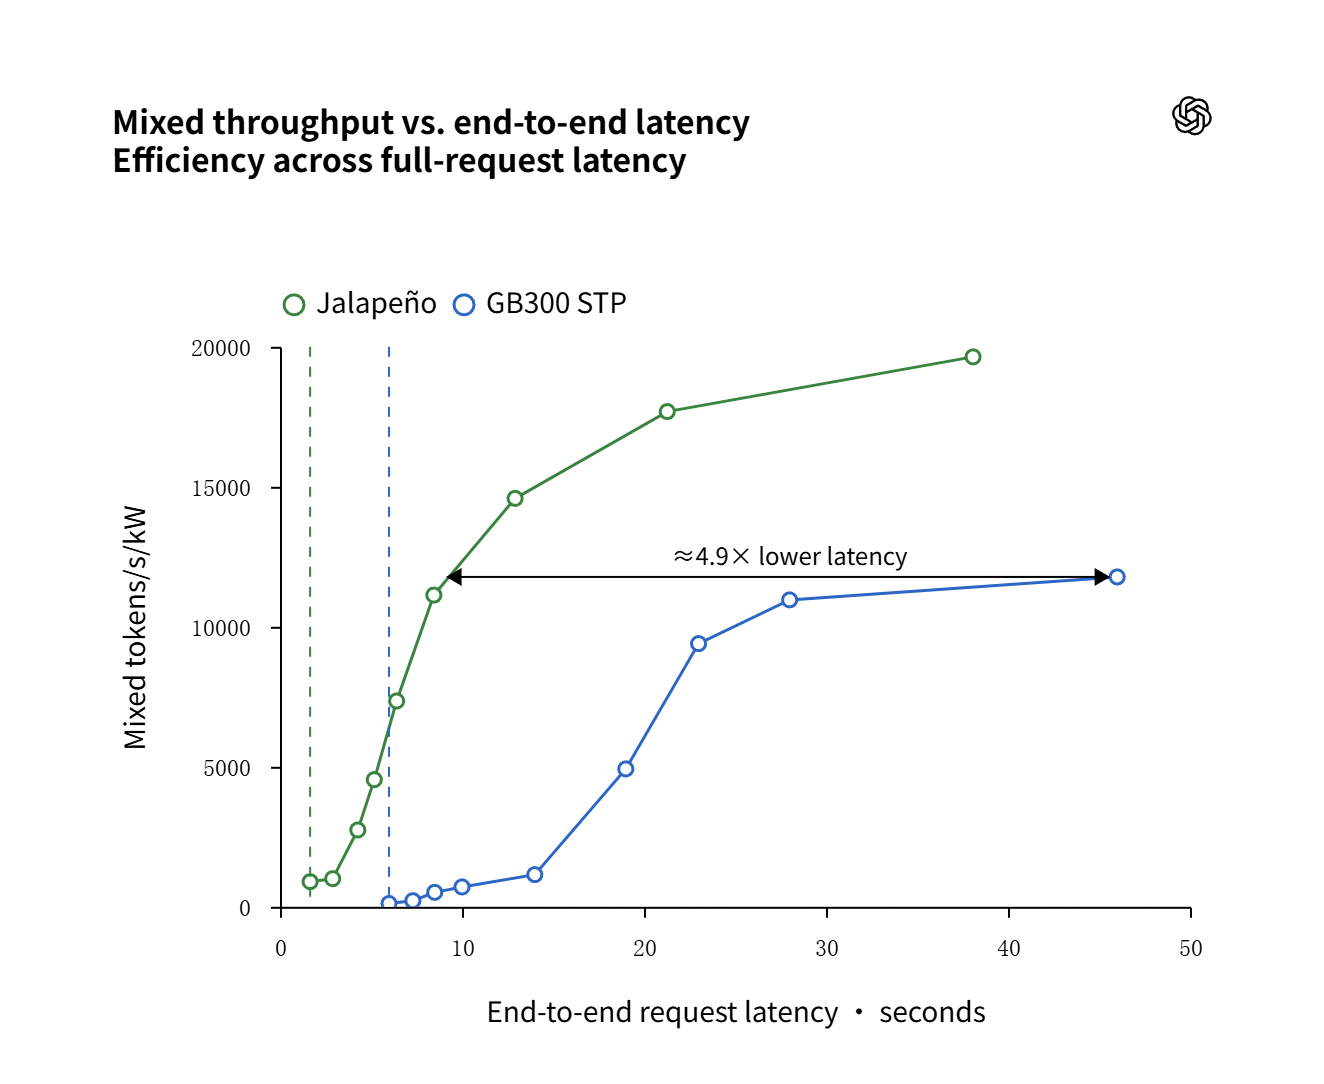
テストによると、市場をリードするAIシステム(GB200およびGB300)と比較した場合、1ワット当たりのAIスループットは比較対象システムの1.5~1.9倍で、エンドツーエンド遅延は比較対象システムの約28%~59%だった。
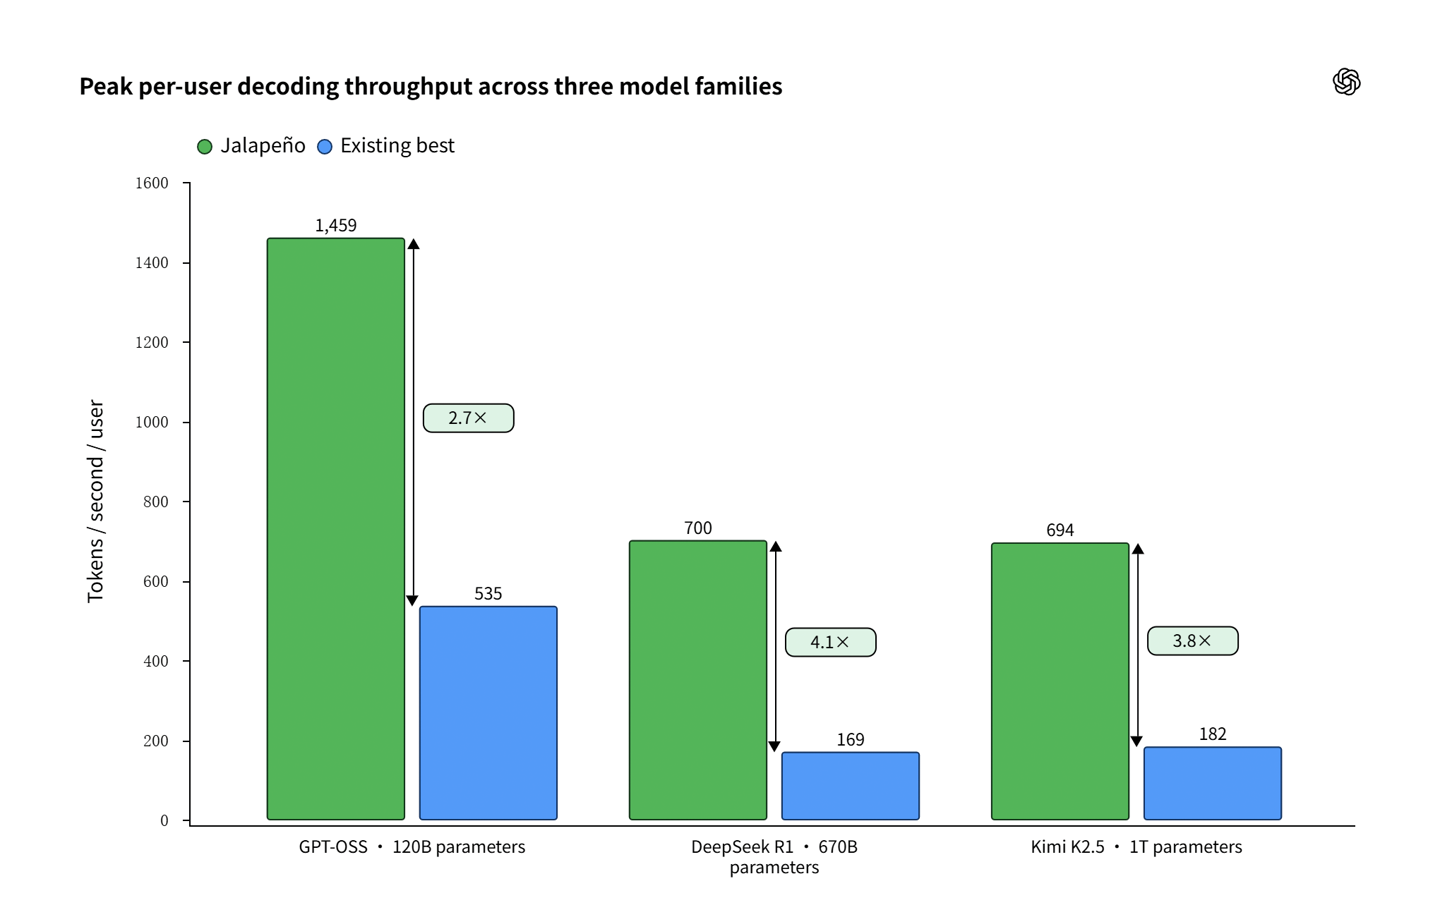
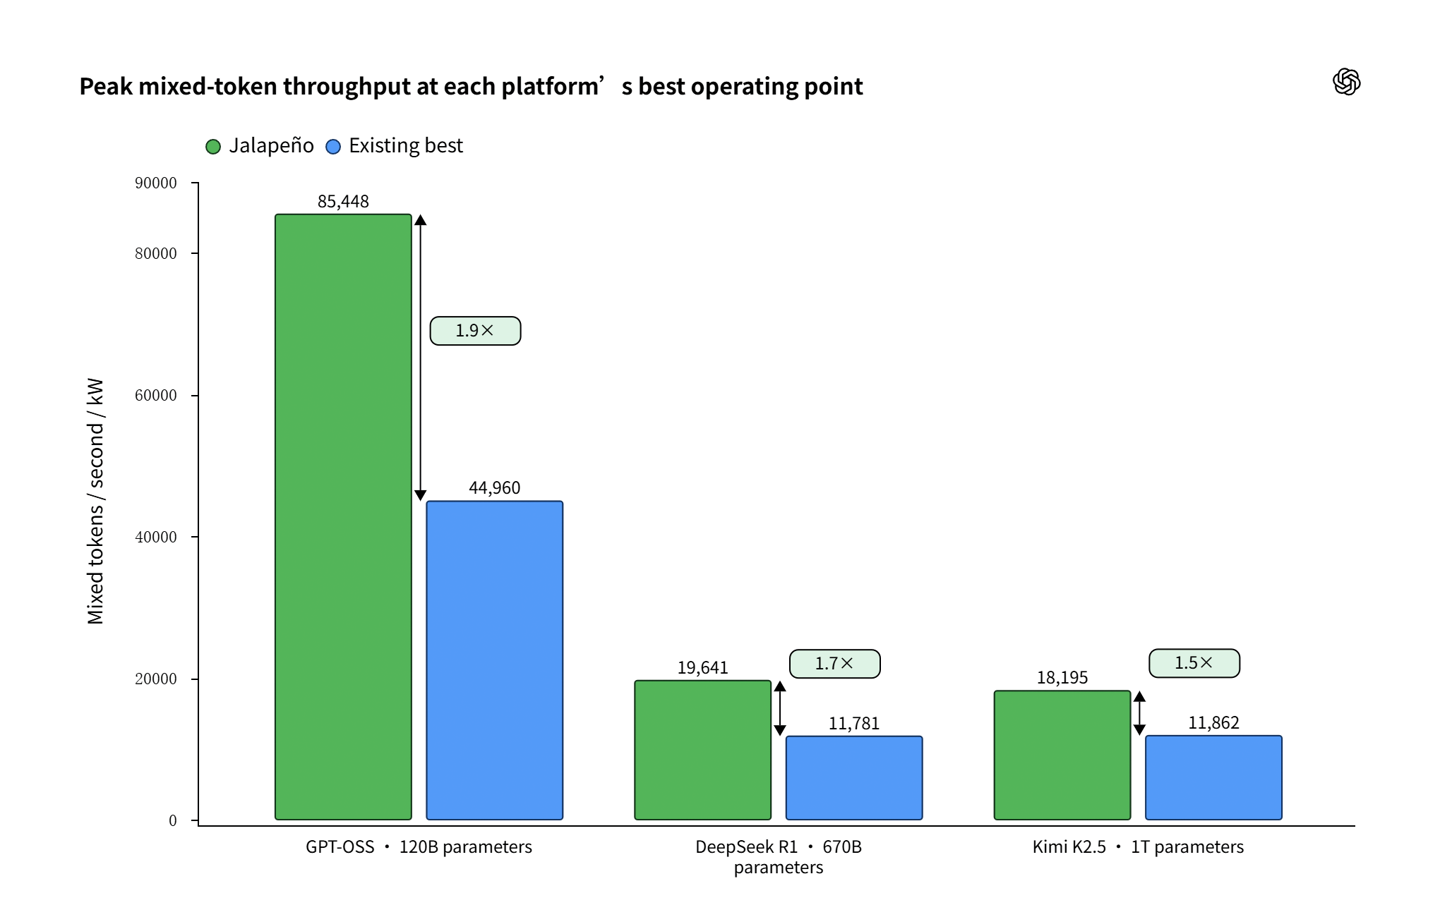
OpenAIによると、JalapeñoはGPT-OSS 120Bの実行時、1キロワット当たりのピークスループットがGB200システムを約1.9倍上回った。
DeepSeek R1では、1ワット当たりの性能がGB300を約1.7倍上回り、Kimi K2.5では約1.5倍上回った。Jalapeñoの定格電力は700ワットだが、テストのワークロード中の持続消費電力は550ワット以下に維持された。関連画像は以下のとおり。
JalapeñoはOpenAI初の自社開発AI推論チップで、OpenAIとBroadcomが共同開発し、TSMCが3nmプロセスで受託製造した。2026年6月24日に初めて対外公開された。このチップはASIC(特定用途向け集積回路)で、systolic array(シストリックアレイ)アーキテクチャを採用し、HBM高帯域幅メモリを搭載している。大規模言語モデルの推論用途に特化して設計され、モデルのトレーニングには使用されない。チップおよび関連サーバーシステムは外部販売されず、OpenAI内部のみで使用される予定で、自社のGPU調達およびコンピューティング運用コストの削減を目指している。OpenAIのハードウェア責任者Richard Hoがこのチップの開発を率いた。同氏は以前Googleに約9年間勤務し、Cloud TPUプロジェクトの中核エンジニアを務めていた。Jalapeñoはアーキテクチャ設計からテープアウト完了まで約9カ月しかかからず、OpenAIはこれを高性能な先端半導体分野で史上最速級のASIC開発期間の一つとしている。OpenAI独自のAIモデルもチップ設計プロセスに深く関与し、設計の最適化を加速させた。現在、第2世代Jalapeñoチップは開発後期段階に入り、今後数カ月以内のテープアウト完了が見込まれている。第3世代チップのコンセプト設計もすでに開始された。OpenAIは2026年末までにJalapeñoの小規模展開を開始し、2027年に段階的に展開規模を拡大する計画だ。なお、今回のJalapeñoのテストではNVIDIAのGB200およびGB300システムを比較対象としており、NVIDIAの最新世代Vera Rubinチップとの比較テストはまだ実施されていない。OpenAIは、NVIDIAが依然として重要なパートナーであり、今後も膨大なコンピューティング需要に対応するため、複数サプライヤー戦略を継続すると説明している。