

アリババ通義千問チームは今夜、Qwen3.8-Flashを正式に発表しました。通義チームは同時にQwen3.8-Flash-Nextのオープンソース版の重みも公開しており、Nextの新アーキテクチャは、まったく新しい次世代Qwen4シリーズモデルの原型となります。
これはマルチモーダルMoEモデルで、メインモデルのパラメータ数は125B、さらに51BのN-gram Embeddingを搭載し、1 tokenあたり6Bパラメータをアクティブ化します。ネイティブで262,144 tokensのコンテキストに対応し、YaRNによって1M tokensまで拡張できます。
紹介によると、Qwen3.8-Flashは以下の4つの方向で体系的なアップグレードを実施しました。
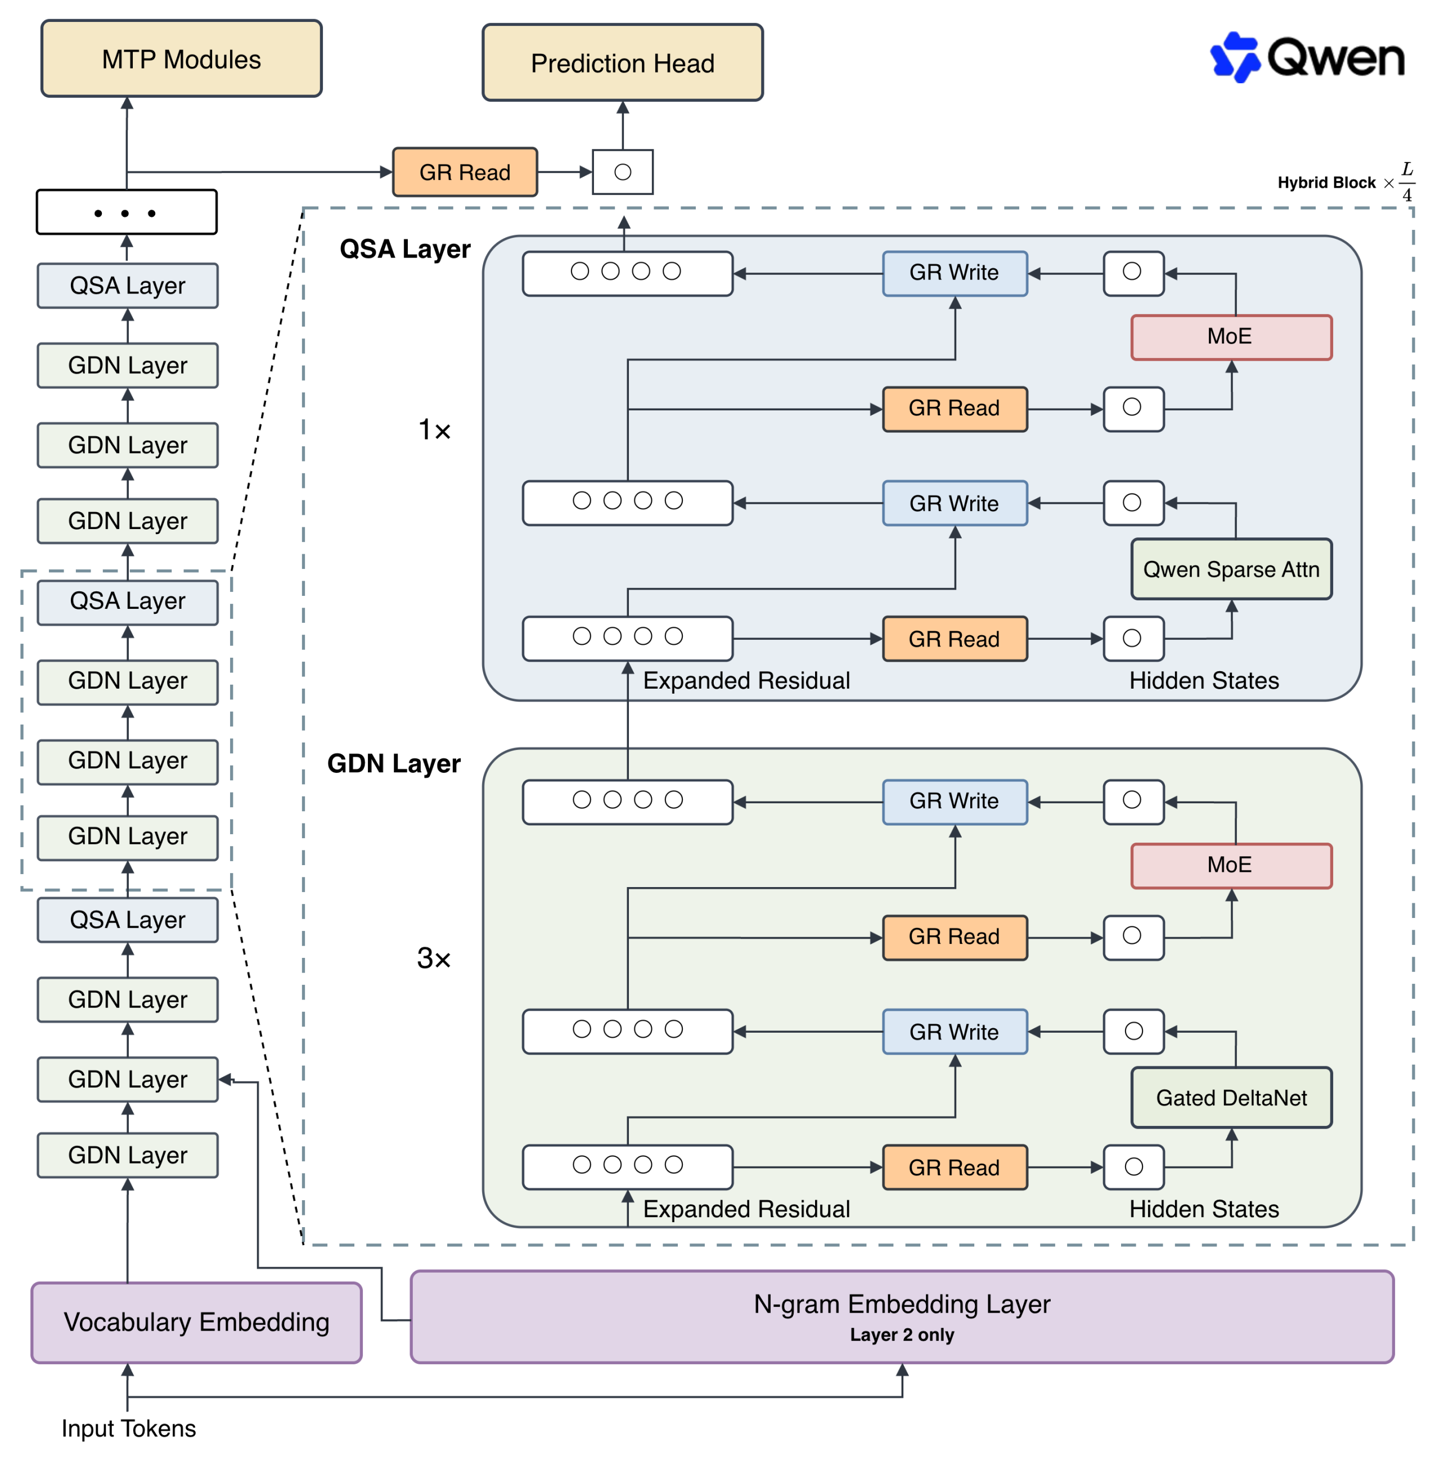
Attentionでは、GDN(Gated DeltaNet)+ QSA(Qwen Sparse Attention)の混合アーキテクチャを採用しています。GDNは過去の情報を効率的に圧縮し、QSAは軽量なIndexerによってmicro-block単位で重要なコンテキストを選別し、長いシーケンスにおけるAttentionの負荷を大幅に削減します。1M tokenの超長文脈に対して、QSAのAttention KernelはPrefillとDecodeの各段階で、それぞれ最大7.6倍、4.9倍の高速化を実現します。
Residualでは、Gated Residual(GR)メカニズムを導入し、残差ストリームを4つの並列ブランチに拡張して、動的なGateで情報の読み書きを制御します。残差状態はFP8で保存でき、メモリアクセスの負荷を大幅に軽減します。
Embeddingでは、51BパラメータのN-gram Embeddingを導入し、局所的なコンテキストを利用したテーブル参照によってモデル容量を拡張します。これらのパラメータはHost Memoryにオフロードでき、非同期Prefetchによってモデル計算と重ね合わせられるため、GPUメモリを長時間占有しません。
Optimizationでは、Muon Optimizerを採用し、直交化精度、パラメータの役割分担、融合行列の分割などの戦略を最適化しています。新アーキテクチャ向けにScaling Lawも再フィッティングしました。
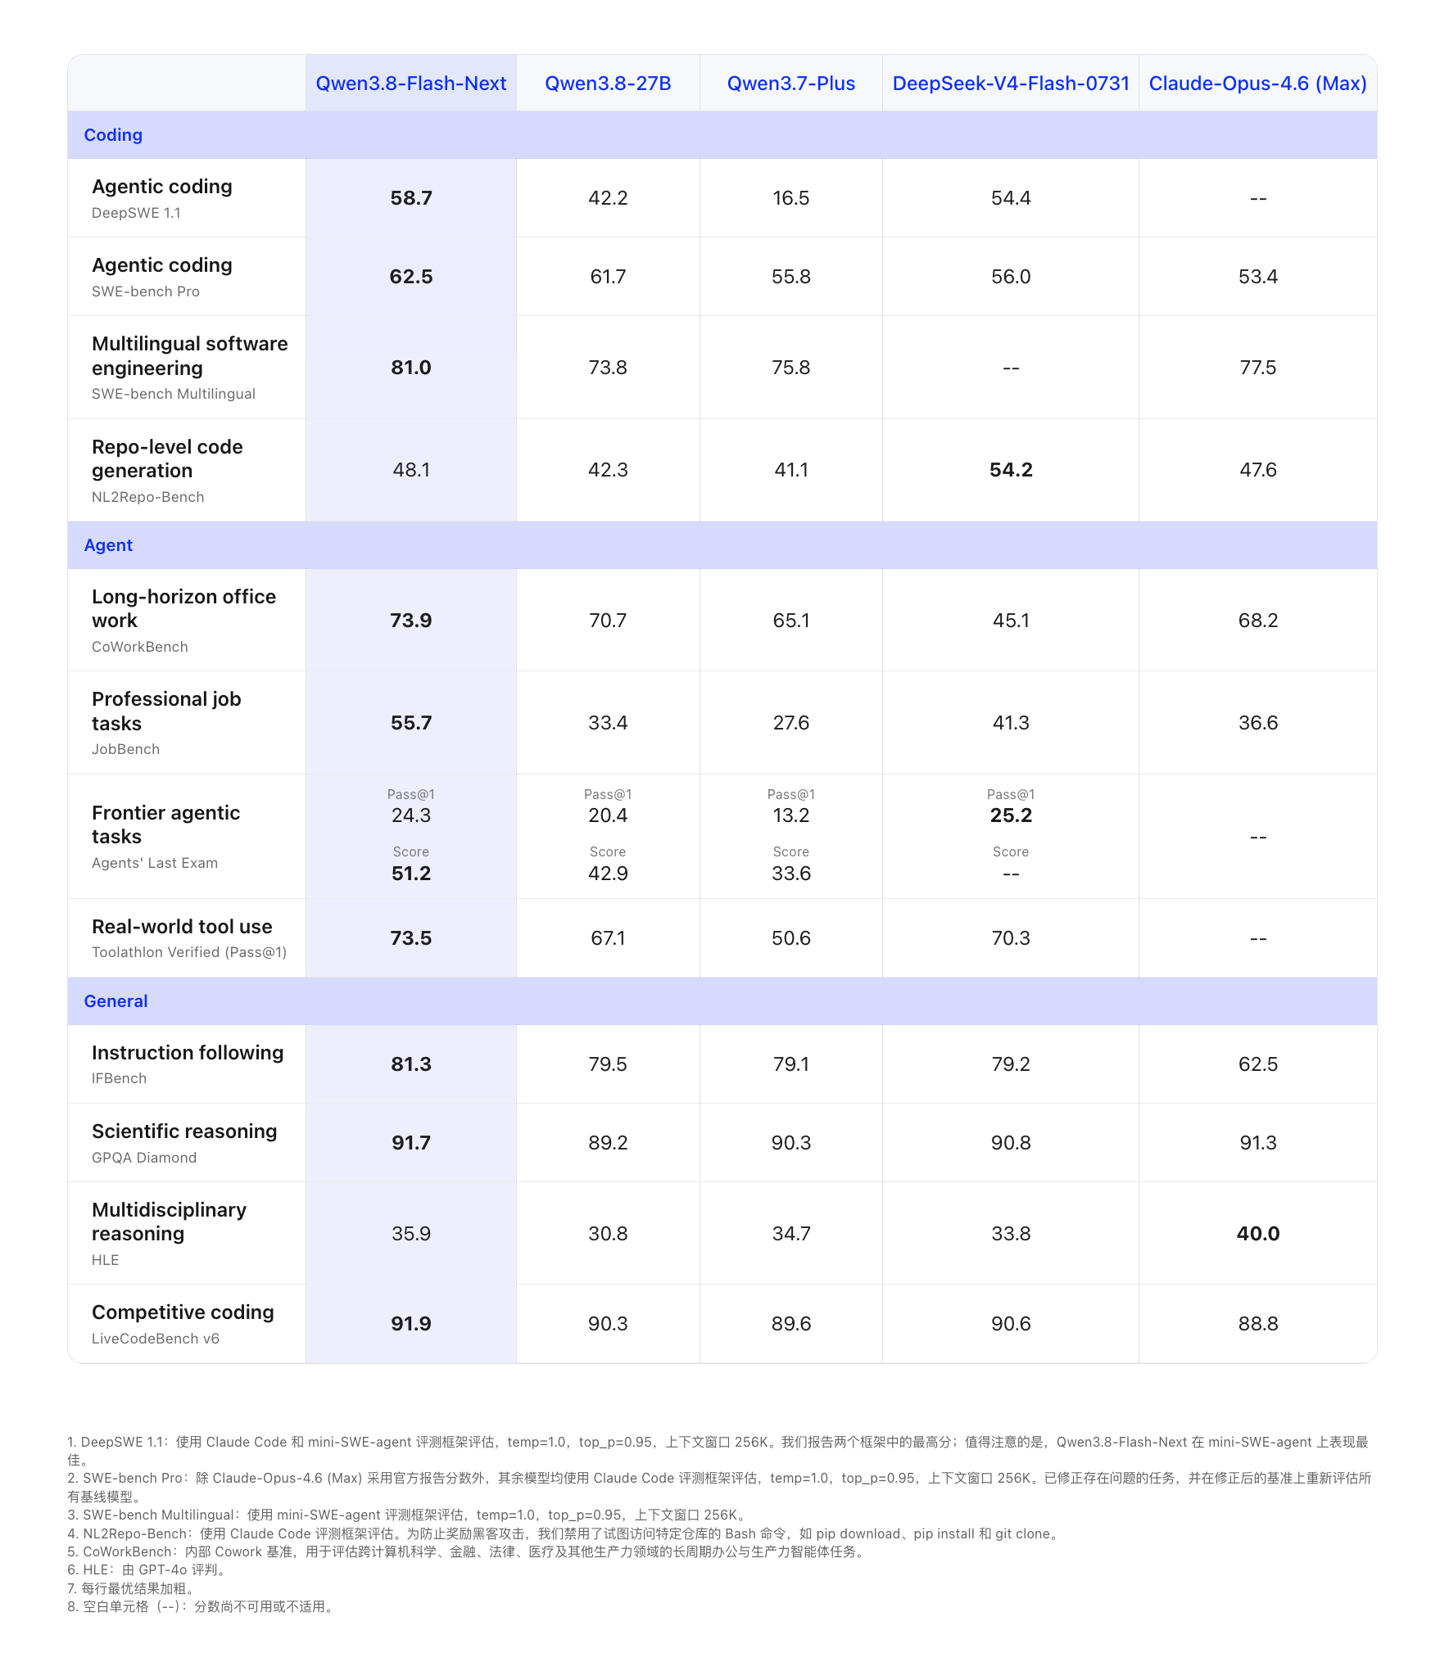
Qwen3.7-Plusと比較すると、Qwen3.8-Flashの学習コストは前者の約9分の1にすぎませんが、コーディングやオフィス業務のタスクではより高い能力を備えています。
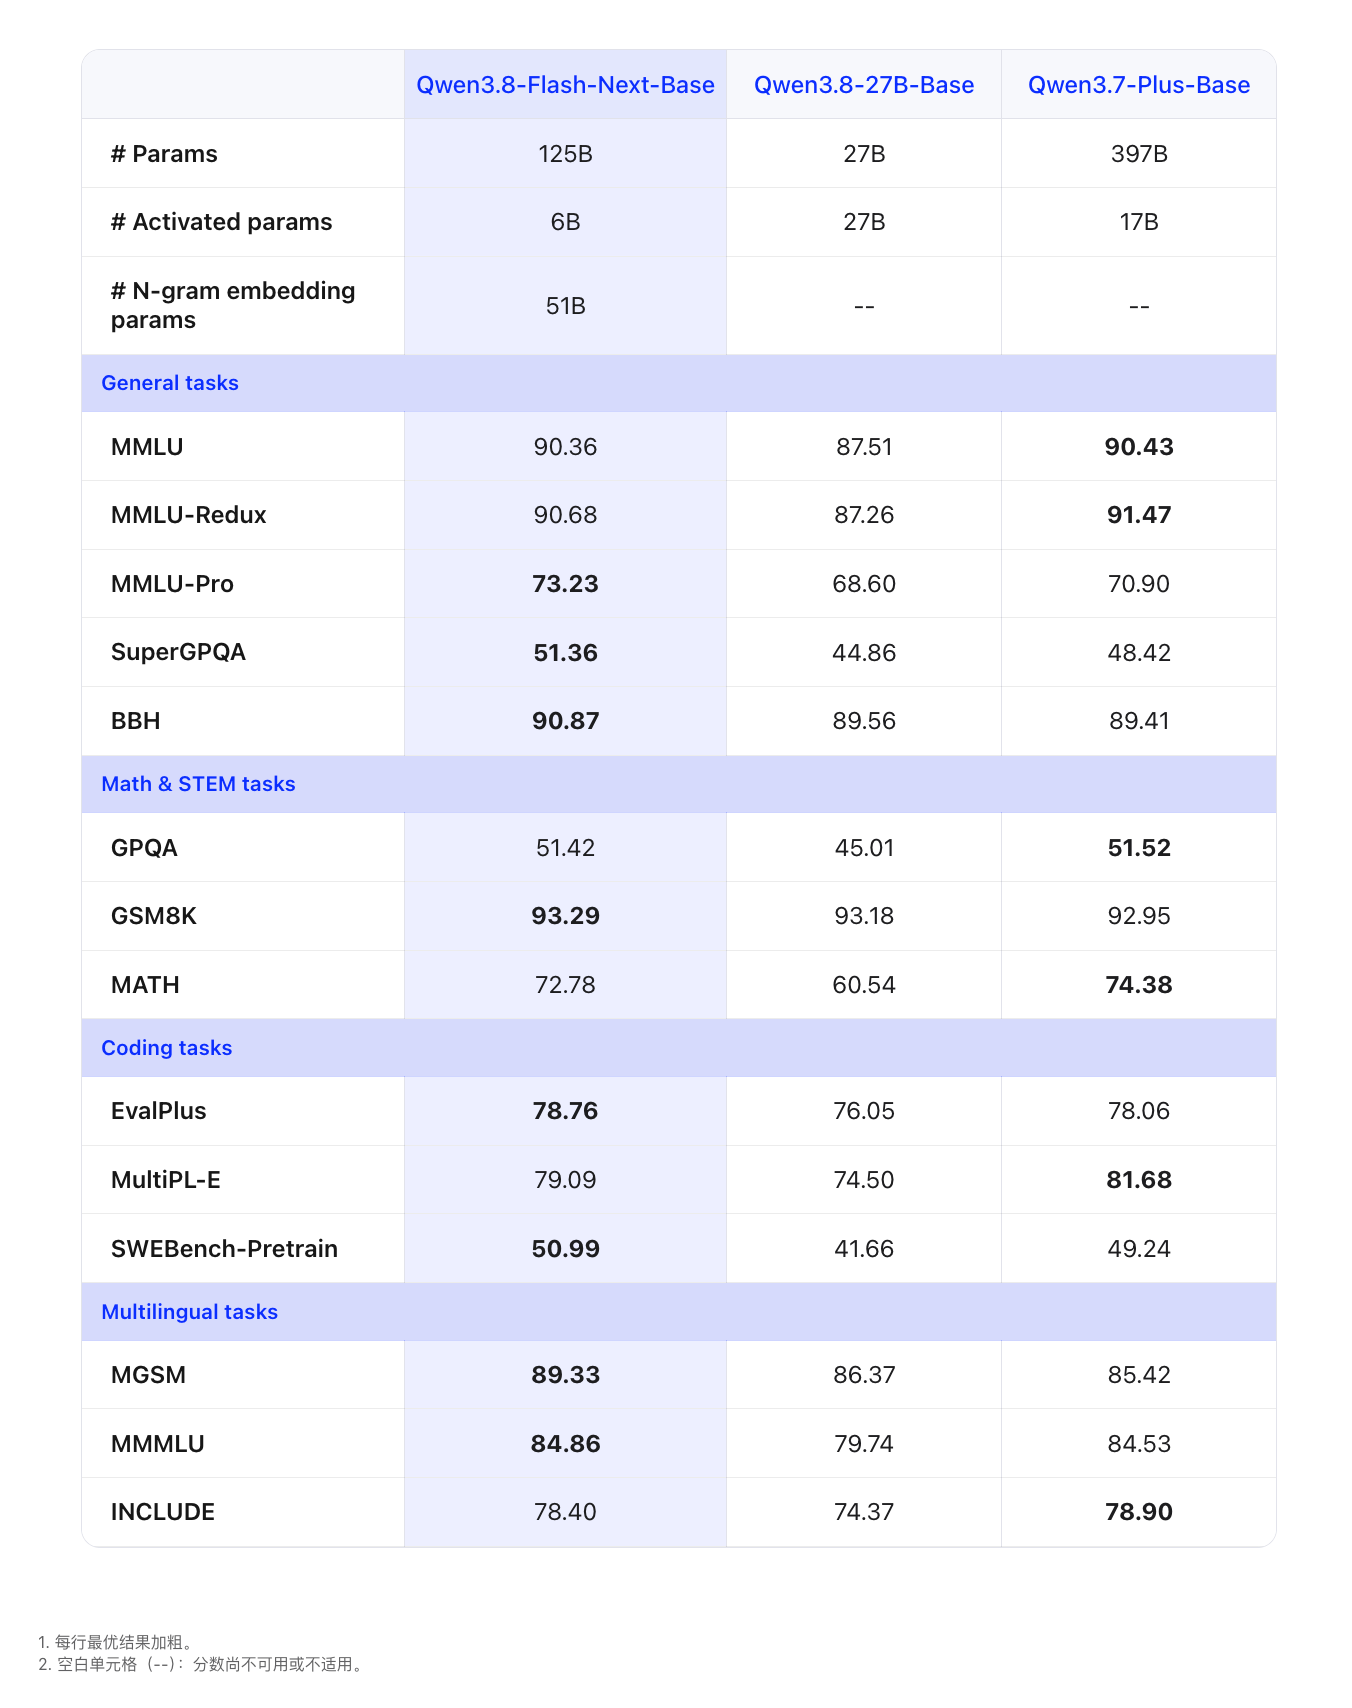
6Bのアクティブパラメータで、Qwen3.8-Flash-Next-Baseは14のベンチマークのうち8つで最高の結果を達成しました。MMLU-Pro、SuperGPQA、BBH、SWEBench-Pretrain、MGSM、MMMUなどが含まれます。
テキストのみ:
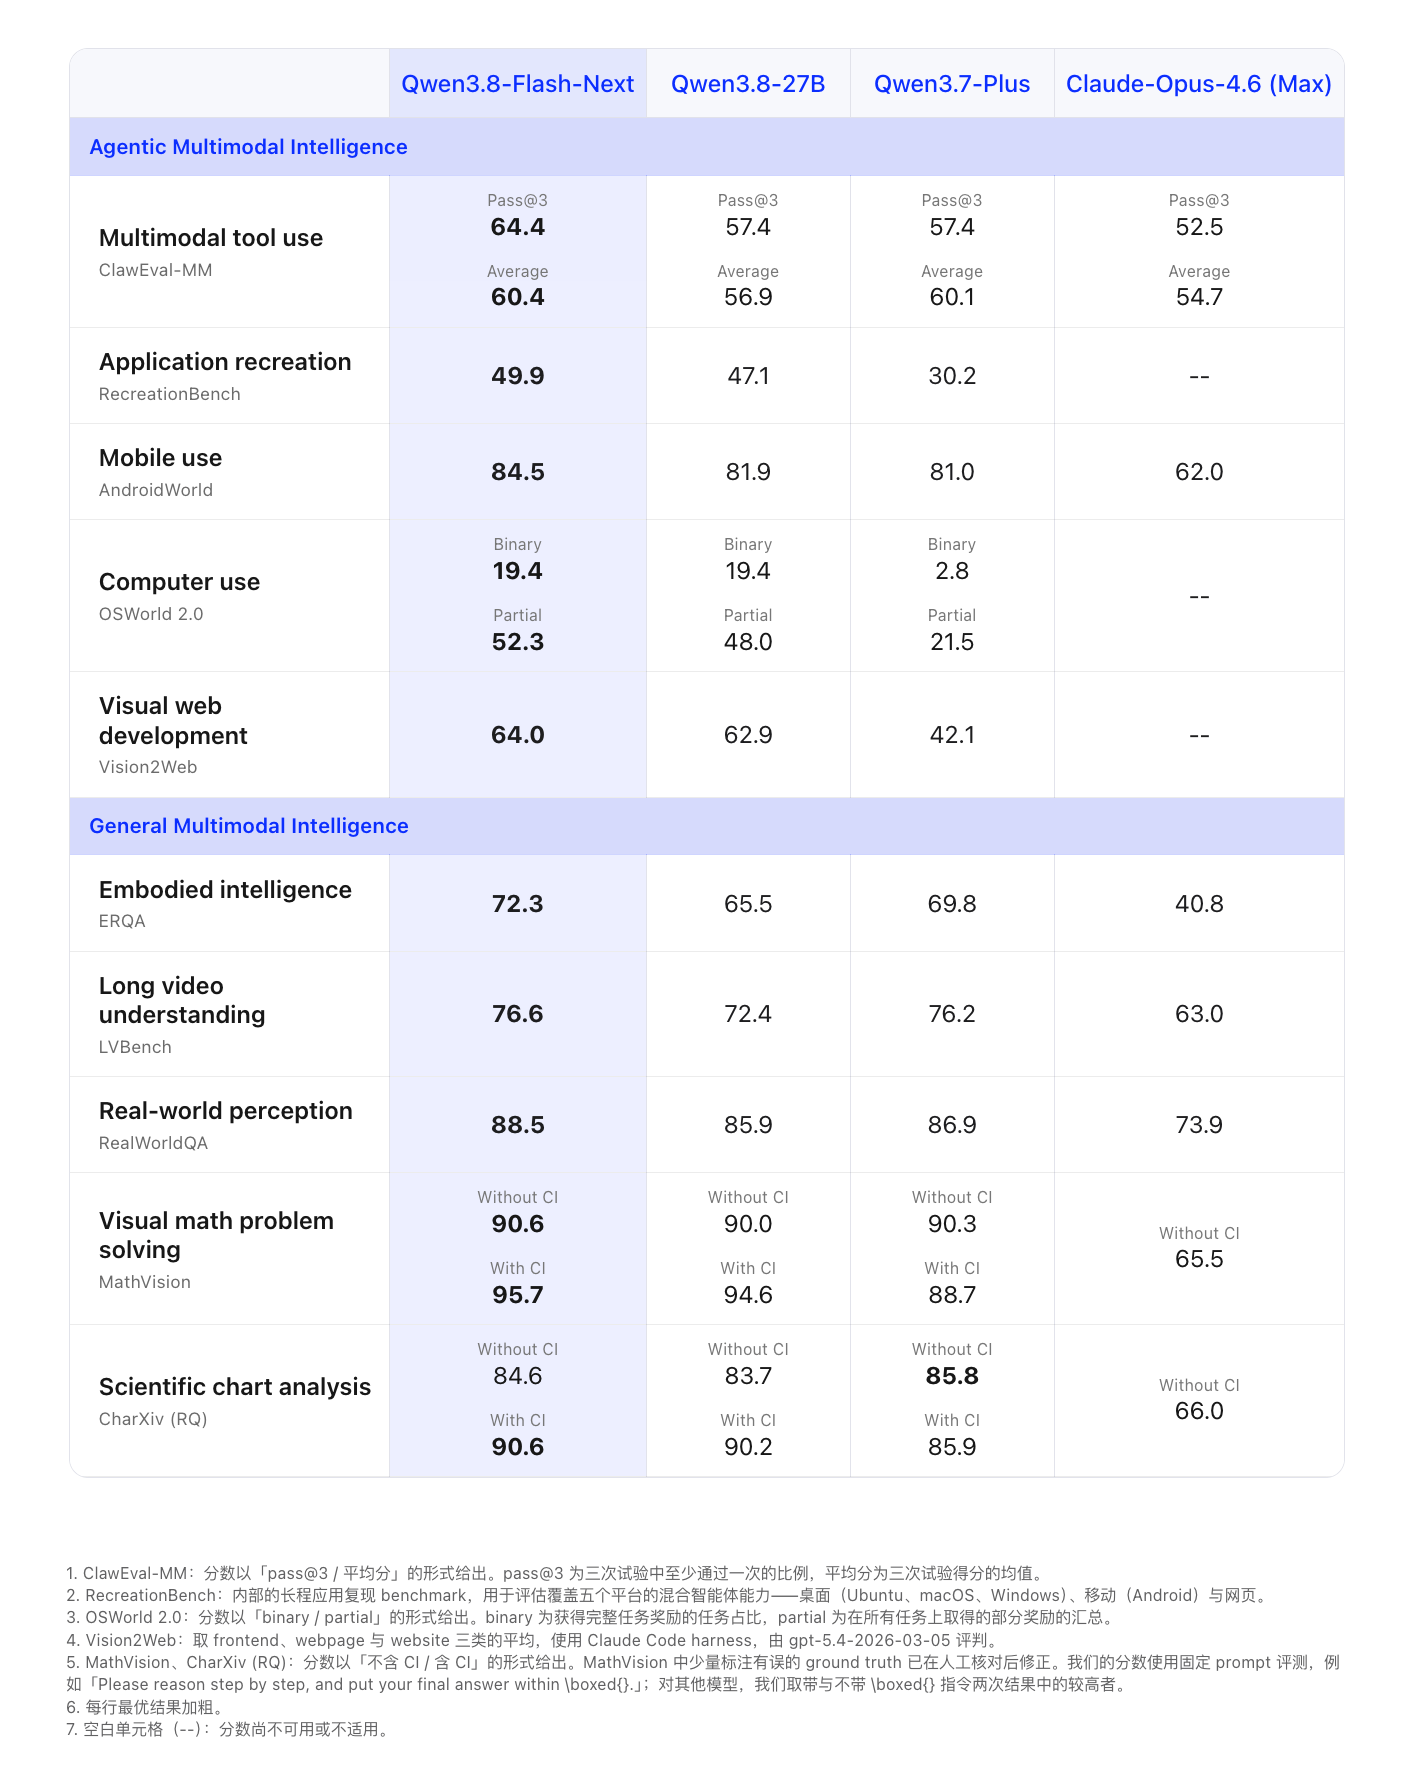
マルチモーダル:
モデル構造:
Baseモデルの性能:
Qwen3.8-Flashは近日中に千問AIプラットフォームで提供開始され、APIサービスを外部向けに提供します。料金は100万Tokensあたり、入力1元、出力3元です。
モデルの重みは北京時間8月26日23:00にHugging FaceとModelScopeのプラットフォームでオープンソース公開され、同時にFP8量子化版もリリースされました。Qwen3.8-Flash-Nextはデフォルトで1Mコンテキストに対応し、公式ツールを内蔵しています。
参考資料:
技術レポート: https://github.com/ QwenLM / Qwen3.8-Flash-Next / blob / main / tech_report.pdf
技術ブログ: https://qwen.ai/ blog?id=qwen3.8-flash-next
Hugging Face: https://huggingface.co/Qwen/Qwen3.8-Flash-Next ?spm= a2ty_o06.30285417.0.0.1d73c921FsyOPe& ;amp;amp;file=Qwen3.8-Flash-Next
ModelScope: https://modelscope.cn/models/Qwen/Qwen3.8-Flash-Next ?spm= a2ty_o06.30285417.0.0.1d73c921XAP2dV& ;amp;amp;file=Qwen3.8-Flash-Next