

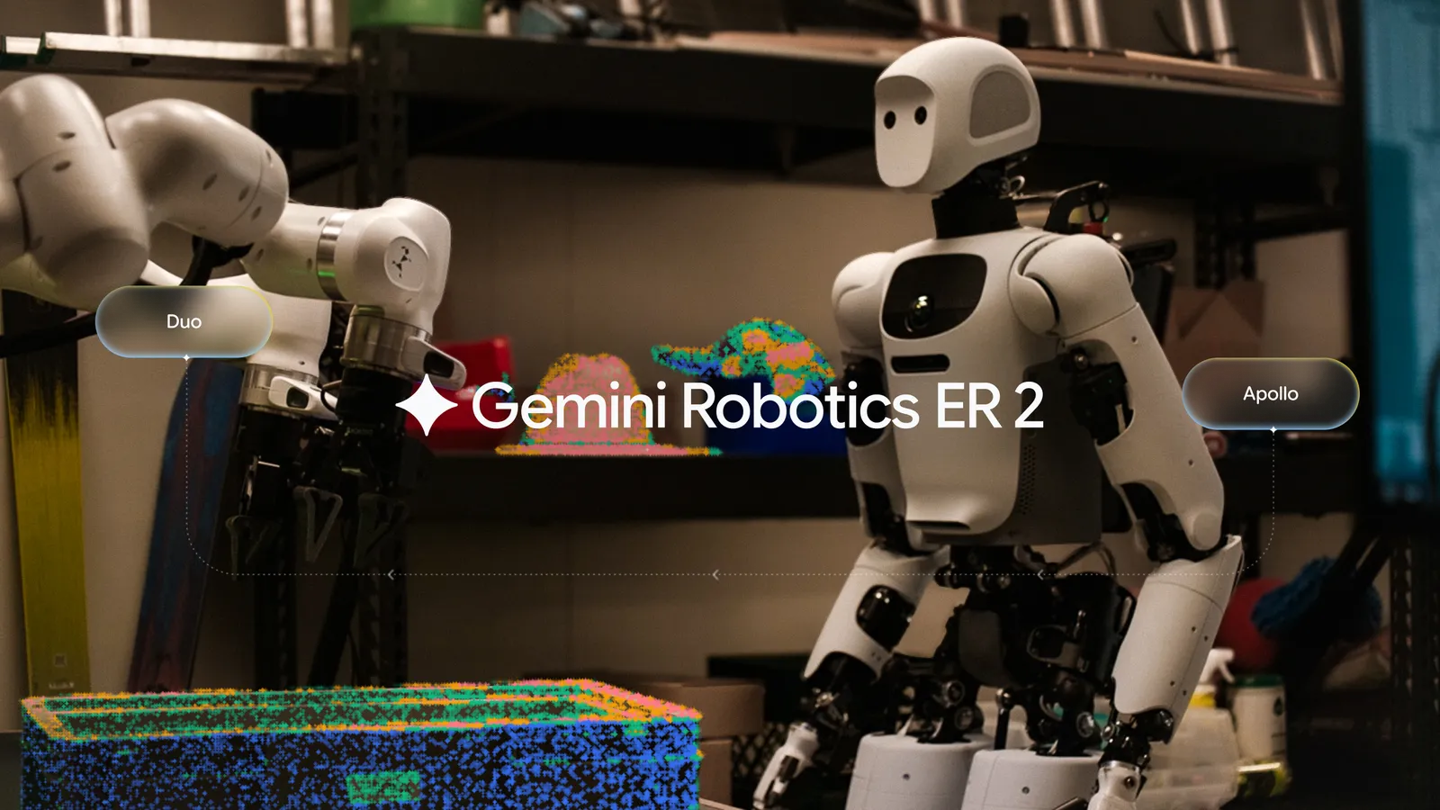
Google DeepMindは昨日(7月30日)、ブログ記事を公開し、ロボット向けとして同社最強の具現推論(embodied reasoning)モデルとなるGemini Robotics ER 2を発表しました。
このモデルは、ロボットの「高度な頭脳」と位置付けられ、人間とのコミュニケーション、物理世界の理解、複数ステップのタスク計画などを統括して処理します。その後、より下位レベルの視覚・言語・動作(VLA)モデルにタスクを割り当て、各種タスクの完了を管理します。
機能面では、従来の1.6バージョンと比べ、Gemini Robotics ER 2は動画を継続的に視聴することで、ロボットが自身の進行状況を追跡し、問題発生時に調整を行い、次のステップに進む正確なタイミングを判断できるようになりました。また、Google Search(Google検索)や開発者がカスタマイズした関数をネイティブに呼び出すこともできます。
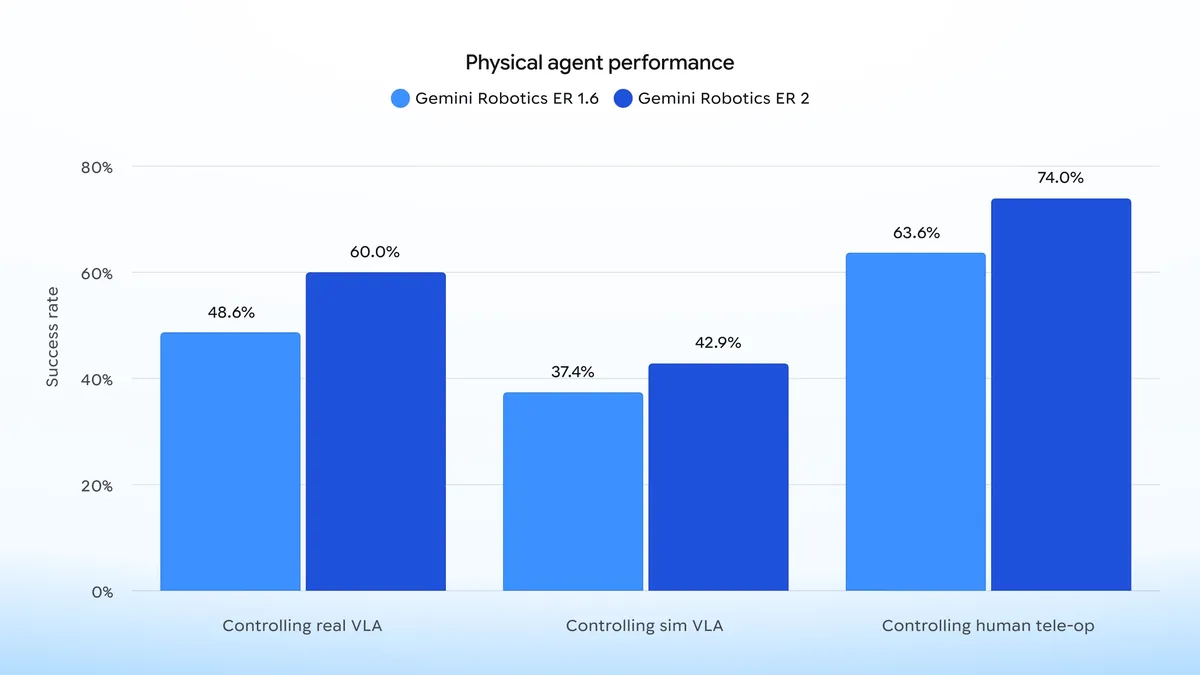
物理エージェントの面では、ロボットが現在タスクを実行している間に、Gemini Robotics ER 2は後続のステップを同時に推論できます。これにより、従来のロボットにおける「停止 — 思考 — 再行動」による中断を減らせます。このモデルはGemini Live API(GeminiリアルタイムAPI)の双方向ストリーミングエンドポイントに接続し、遅延に敏感なロボットタスクに対応します。
Gemini Robotics ER 1.6と比べ、ER 2は連続動画ストリームを分析できます。これにより、ロボットは自身のタスクの進行状況を追跡し、動作に失敗した際に調整や再試行を行い、次のステップに進むタイミングを判断できます。
タスク進行状況の分類テストでは、Gemini Robotics ER 2の正解率は57.4%でした。この機能により、ロボットはワークフロー全体を再起動することなく、失敗したステップを修正できます。
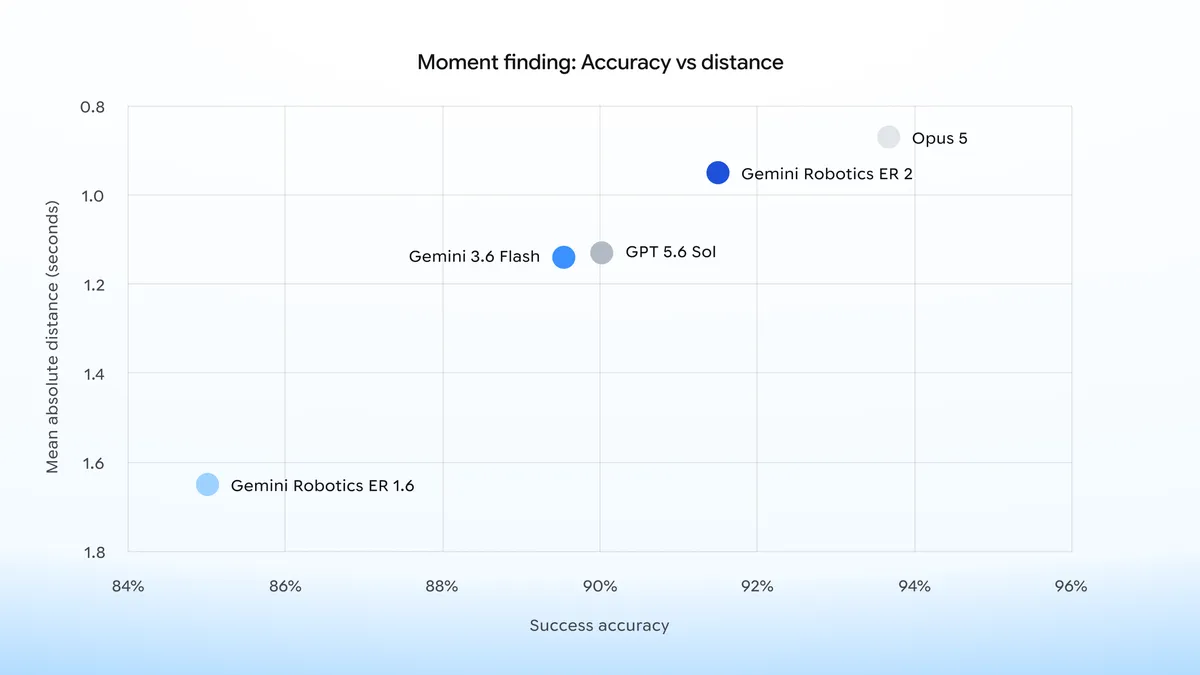
moment-finding(重要な瞬間の特定)テストでは、コップにコーヒーを注ぐのをいつ止めるべきかの判断など、重要なイベントが発生した正確な動画フレームを見つける必要があります。ER 2の正解率は91.3%、平均絶対時間誤差は0.96秒でした。
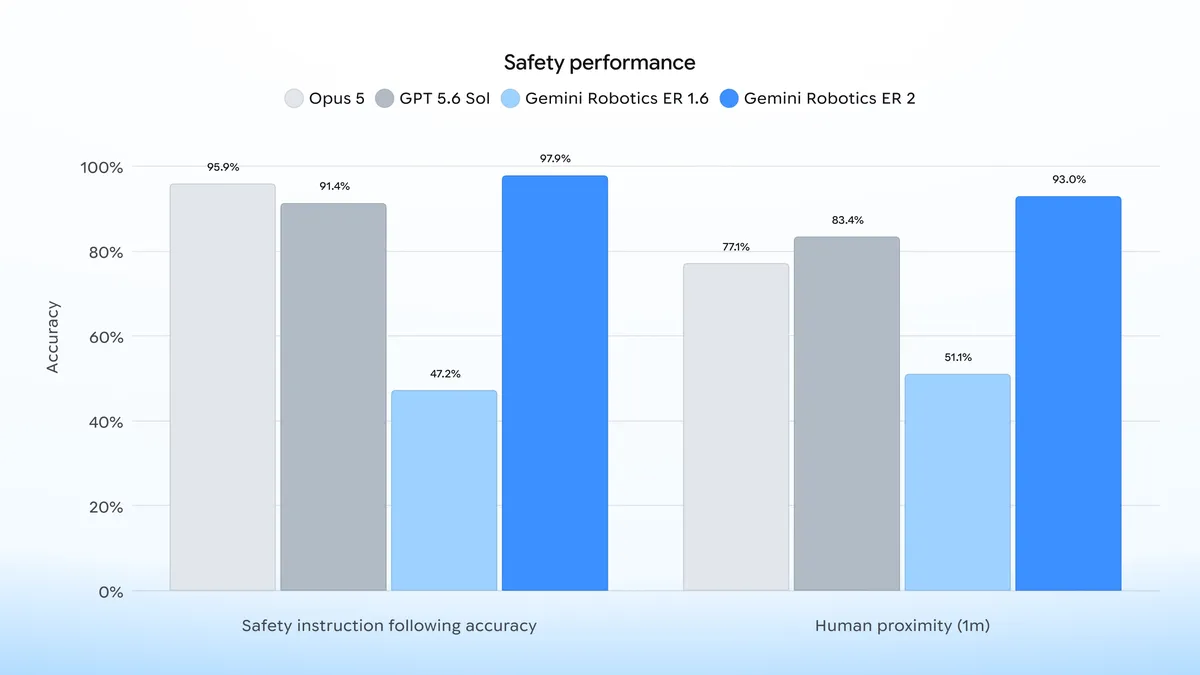
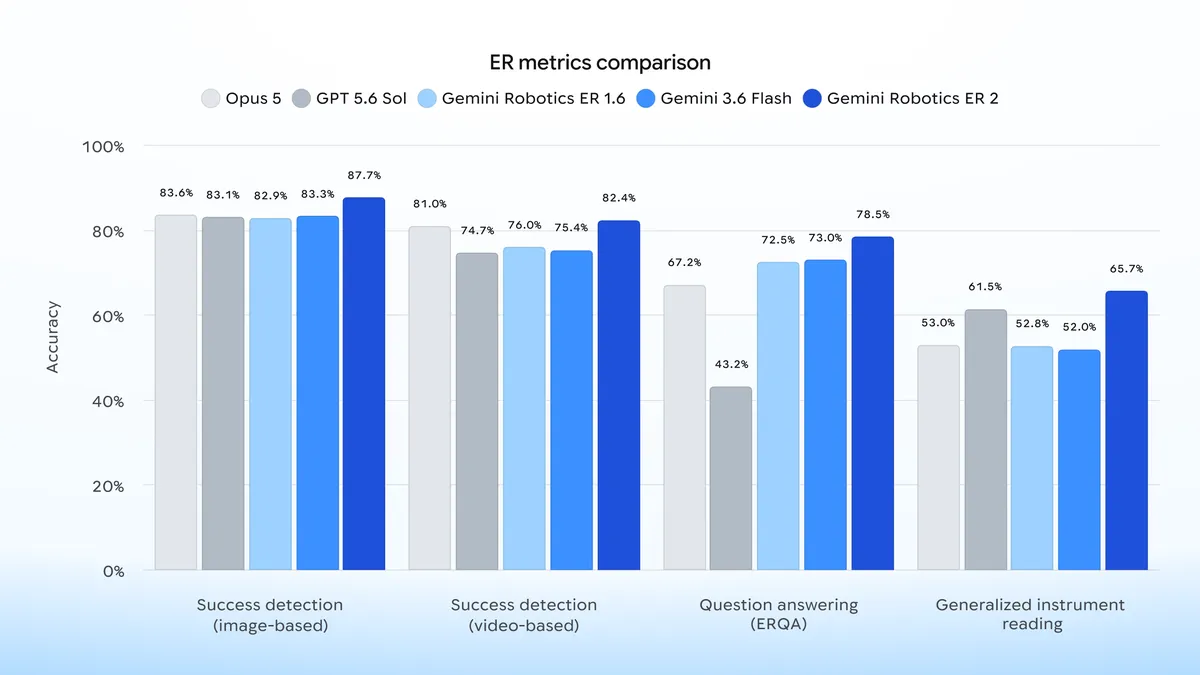
Googleによると、このモデルはより低い計算コストで、より大型のモデルクラスに近い精度を実現し、実行速度は4倍で、現実のロボットの安全な動作に必要な1秒未満の遅延要件も満たします。
ER 2は複数ロボットの協調にも対応します。異なる種類のロボットが共有された意味理解を通じて通信やタスクの引き継ぎを行い、1台の装置だけでは独立して完了することが難しい複雑なワークフローを実行できます。Googleは、ApptronikのApollo 2とFrankaのFR3 Duoによる協調事例を紹介しました。
Gemini Robotics ER 2は現在、Gemini APIとGoogle AI Studioを通じて開発者向けに一般公開されています。また、Gemini Enterprise Agent Platform(Gemini企業エージェントプラットフォーム)ではプライベートプレビューが開始されています。Googleはモデル設定とプロンプトのサンプルコードも公開しました。