

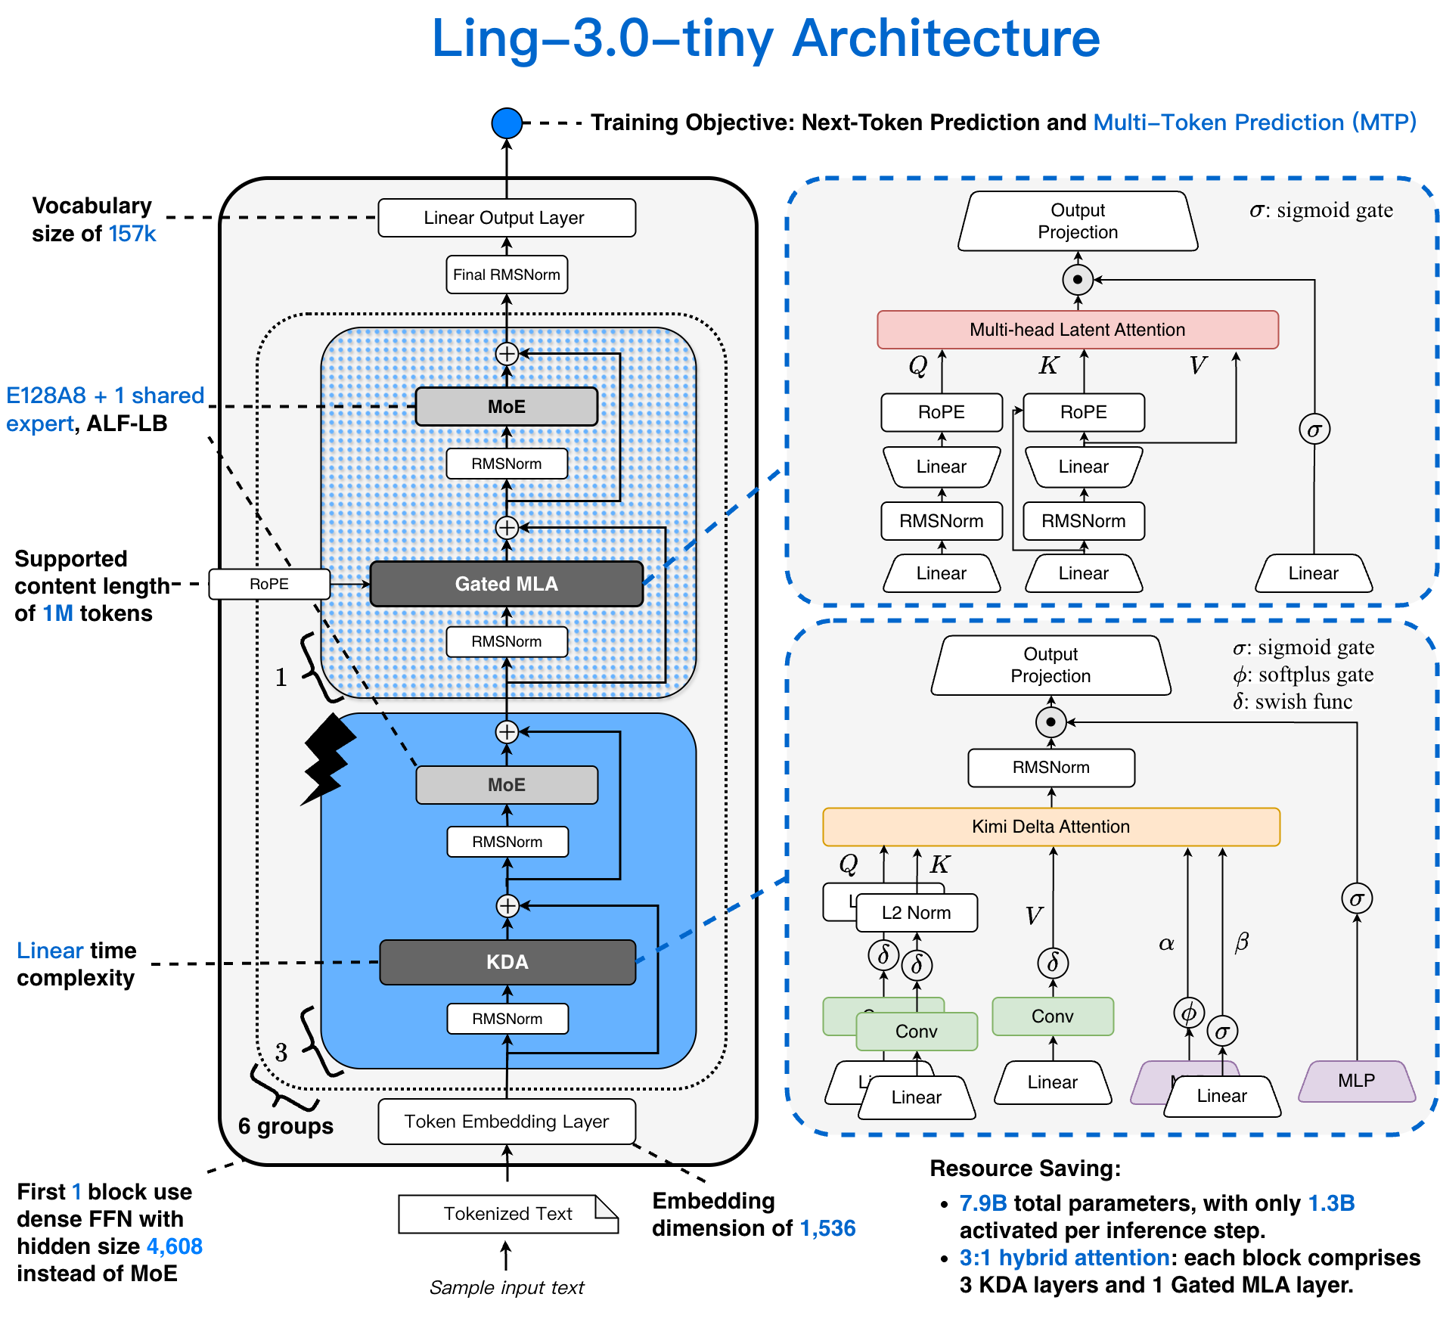
蚂蚁百灵は本日、Hugging FaceプラットフォームでLing-3.0-tinyモデルをオープンソース化しました。同モデルは軽量なハイブリッド推論MoEアーキテクチャで、総パラメータ数は7.9B、1トークンあたり1.3Bのパラメータをアクティベートします。公式はBF16、FP8、INT4の重みバージョンを提供し、各プラットフォームの展開ニーズに対応しています。
紹介によると、Ling-3.0-tinyは低コスト推論を主眼とし、効率的なハイブリッド線形アーキテクチャを採用しています。KDA(Kimi Delta Attention)とMLA(Multi-Head Latent Attention、マルチヘッド・潜在アテンション)を3:1の割合で交互に積み重ねています。128個のルーティングエキスパート(routed experts)を含むスパースMoEフィードフォワードネットワーク(FFN)を採用し、コンテキスト処理能力と計算コストのバランスを実現しています。
同モデルは高速応答モードと多段階推論モードに対応し、ローカル展開向けに設計されています。公式はNVIDIA DGX Spark、Apple Silicon搭載MacBook、Mac miniなどのコンピューターで検証済みです。M4 Pro搭載MacBookでは、約86~90 Token/sの推論速度を実現でき、コンテキスト長8Kの場合、ピーク時のメモリ使用量は約8.34 GiBです。
参考:
inclusionAI/Ling-3.0-tiny · Hugging Face