

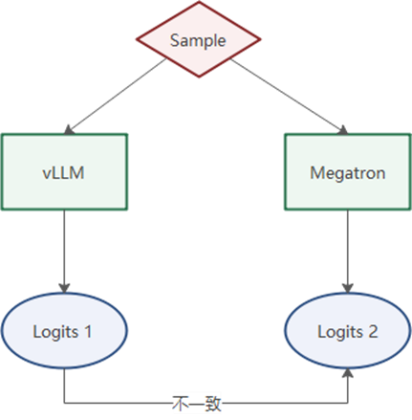
強化学習は大規模モデルの訓練における主流の手法となり、モデル技術の業界中核シーンへの実用化を促進しています。その中でも訓練と推論の一貫性は極めて重要です。推論と訓練のプロセスは密接に結び付いており、インフラの違いが不確実性を拡大させやすいためです。
ファーウェイのコンピューティング部門は8月5日、昇腾がAscend Cプログラミング言語に基づき、訓練・推論一貫性を実現する完全な演算子セットを提供すると公式発表しました。Qwen3-30B MoEモデルでのテストではLogdiff 0を実現し、昇腾に最適化されたFA演算子により、Eagerモードで20%-60%の性能向上を達成しました。開発者に効率的で信頼性の高い強化学習訓練ソリューションを提供します。
RLの後訓練における訓練・推論の不一致の最も根本的な原因は、基盤となる計算時の加算順序が保証されないことです。訓練エンジンと推論エンジンの各加算順序を上から下まで一致させるには、フレームワーク側と演算子側の双方で対応する必要があります。モデルのパラメータが大きいほど、この問題はさらに拡大します。テンソル並列やエキスパート並列などの分割戦略、集合通信の経路など、どの段階でも整合しなければ、最終的なtrue-on-policyを実現できません。演算子は複数の呼び出しシーンにも対応し、重要な計算ステップに制約を加えながら、性能低下を実用可能な範囲に抑える必要があります。これはシステム全体に関わる工学的な課題です。
訓練・推論の不一致とは、Rollout(推論)エンジンと訓練エンジンの間における数値の不一致を指します。両者がまったく同じモデル重みを使用していても、同じToken列から計算した対数確率(logprob)にはわずかな差が生じる可能性があり、この差は通常logdiffで測定されます。
昇腾はAscend Cプログラミング言語に基づき、訓練・推論経路における主要演算子に体系的な制約と整合処理を施しました。中核となる考え方は、訓練と推論が「加算すべき箇所」で同じ数値計算経路を通るようにすることです。主な変更点は次の4つです。
注意機構の意味を統一:訓練時のマスクSoftmaxと推論時のステップごとの注意機構について、有効位置における計算範囲を整合させ、可視Token集合の違いによる数値差を解消します。
reduceの加算順序を固定:訓練時のFA、推論時のPFA / PagedAttentionについて、リダクション次元における分割と還元の順序を制約し、「同じテンプレートでも分割が異なる」ことによる加算順序の不一致を防ぎます。
オンラインSoftmaxの分割戦略を整合:分割サイズと還元のタイミングを統一し、decoder側の複数ブロックを結合するSoftmaxと訓練側の分割Softmaxの不一致を防ぎます。
重要経路の精度を整合:Softmaxの累積など影響を受けやすいステップで精度変換の方式を統一し、混合精度実装の違いによる仮数誤差を低減します。
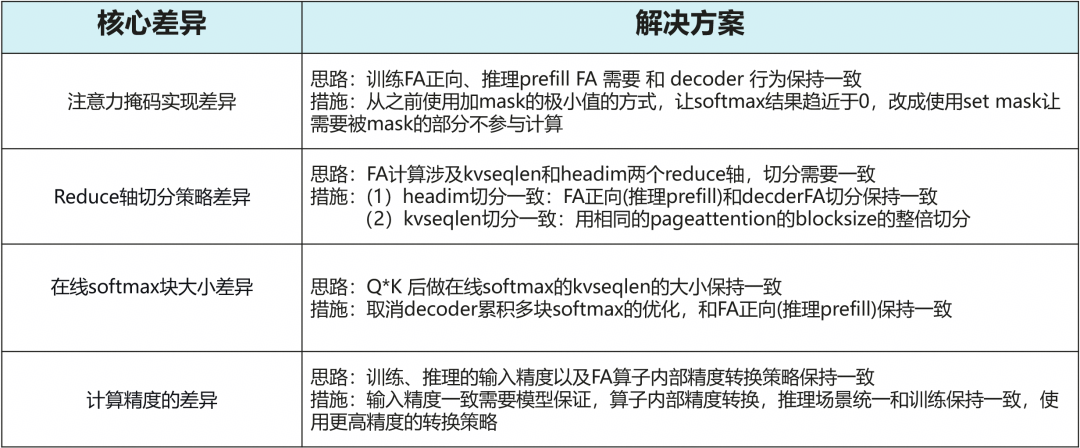
これに加えて、FAのディスパッチとスケジューリングを最適化することで、訓練・推論の一貫性を実現するために大幅な性能低下を受け入れる必要がなくなり、実測でlogdiff=0とエンドツーエンドの高速化を同時に達成しました。
ファーウェイは関連インフラをオープンソース化したと発表しており、残存するlogdiffの調査や、演算子経路の問題なのかフレームワーク実装の差異なのかを特定できる「訓練・推論一貫性問題識別Skill」も提供する予定です。
オープンソースのアドレス:
https://github.com/verl-project/verl-ascend-recipe/tree/main/true_on_policy