

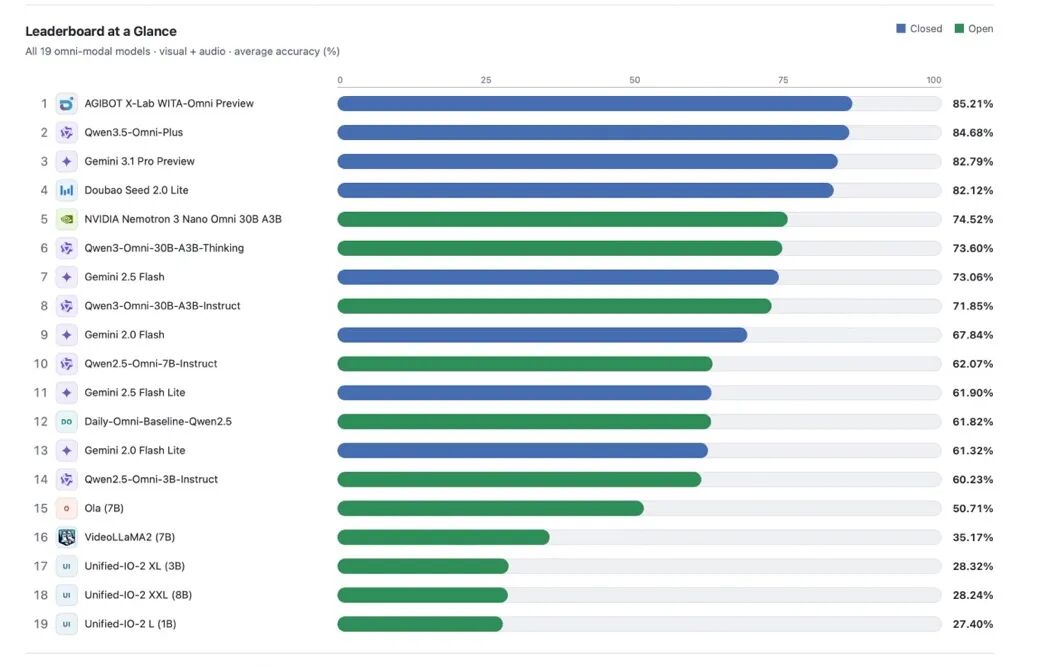
智元AGIBOTのWeChat公式アカウントによると、先日、具身全モーダル理解の権威あるランキング「DailyOmni」の最新評価結果が発表された。智元が独自開発した具身ネイティブ全モーダル大規模モデル「WITA-Omni Preview」は、先進的な音声・映像の統合理解と時系列推論能力により、総合85.21点で首位を獲得した。千問、Gemini、豆包、NVIDIAなど国内外の主要モデルを上回り、8つの細分化指標のうち6項目で1位となった。
IT之家の取材によると、DailyOmniは、音声・映像の時系列アライメントやクロスモーダル統合推論能力を検証する、業界で公認された第三者ランキングである。画像とテキスト、ショート動画を対象とする一般的な評価タスクとは異なり、このランキングでは実際の開放環境で収録された音声・映像素材を大量に使用する。映像と環境音の情報を融合し、音声と映像の対応関係、出来事の前後関係、クロスモーダルな意味を正確に識別する総合能力を重点的に評価しており、実際の物理空間で人型ロボットが人とインタラクションする際に必要な中核的知覚能力に非常に近い。
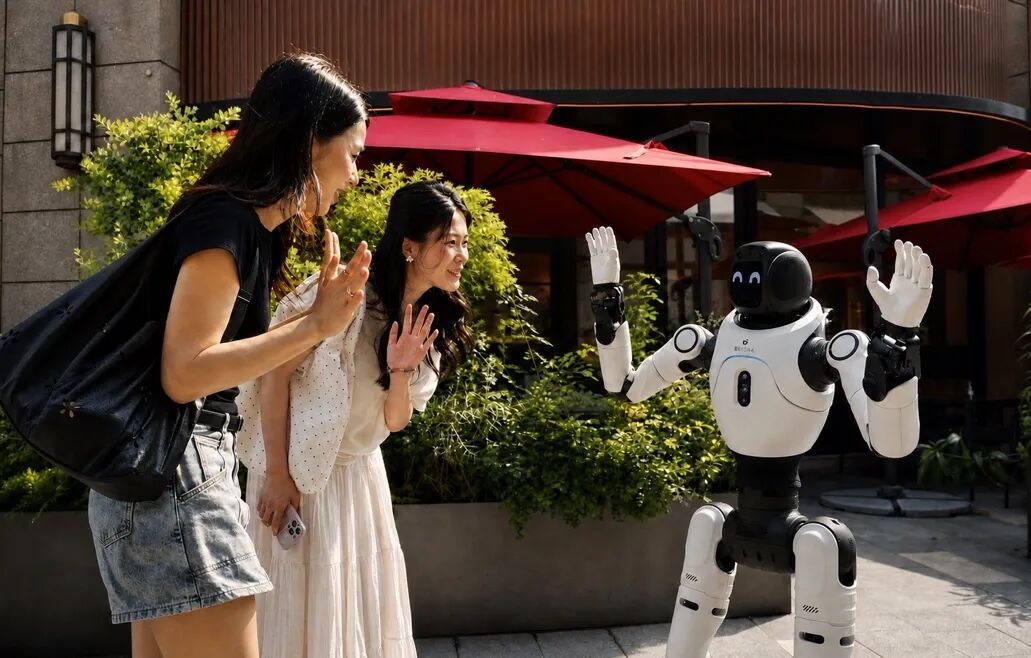
公式発表によると、WITA-Omniが優位に立つ鍵は、単にチャットモデルをロボットに「組み込んだ」のではなく、物理的な動作や表情を音声と並ぶ第一級の出力へと高め、ネイティブなエンドツーエンドモデルによって知覚、意思決定、表現を一元的に駆動する点にある。Thinker–Talkerのパラダイムをさらに拡張し、具身出力に対応したThinker–Talker–Actorアーキテクチャを構築している。
WITA-Omniの優位性は、単純にモデル規模へ依存したものではなく、具身全モーダルインタラクションを中心に構築した階層型データ体系と、目的に応じたトレーニング手法によるものだ。中間学習段階では、WITA-Omniは合計で数千万時間規模のオープンソースおよび自社保有のマルチモーダルデータを使用し、強力なテキスト・視覚基盤を、「聞き取り、理解し、音声と映像を統合して推論できる」全モーダルモデルへとさらに進化させた。
また、公開されている音声・映像データには通常、実際のインタラクションにおけるターンの切り替え、応答のタイミング、動作や表情に関する情報が不足しており、エンドツーエンドの具身インタラクションモデルを直接学習することは難しい。そこで智元は、人を中心に据え、実際のインタラクション場面を想定した大規模かつ高品質な全モーダルデータセットを構築し、音声、映像、言語、動作、表情の間にある自然な時系列関係を完全に保持した。