

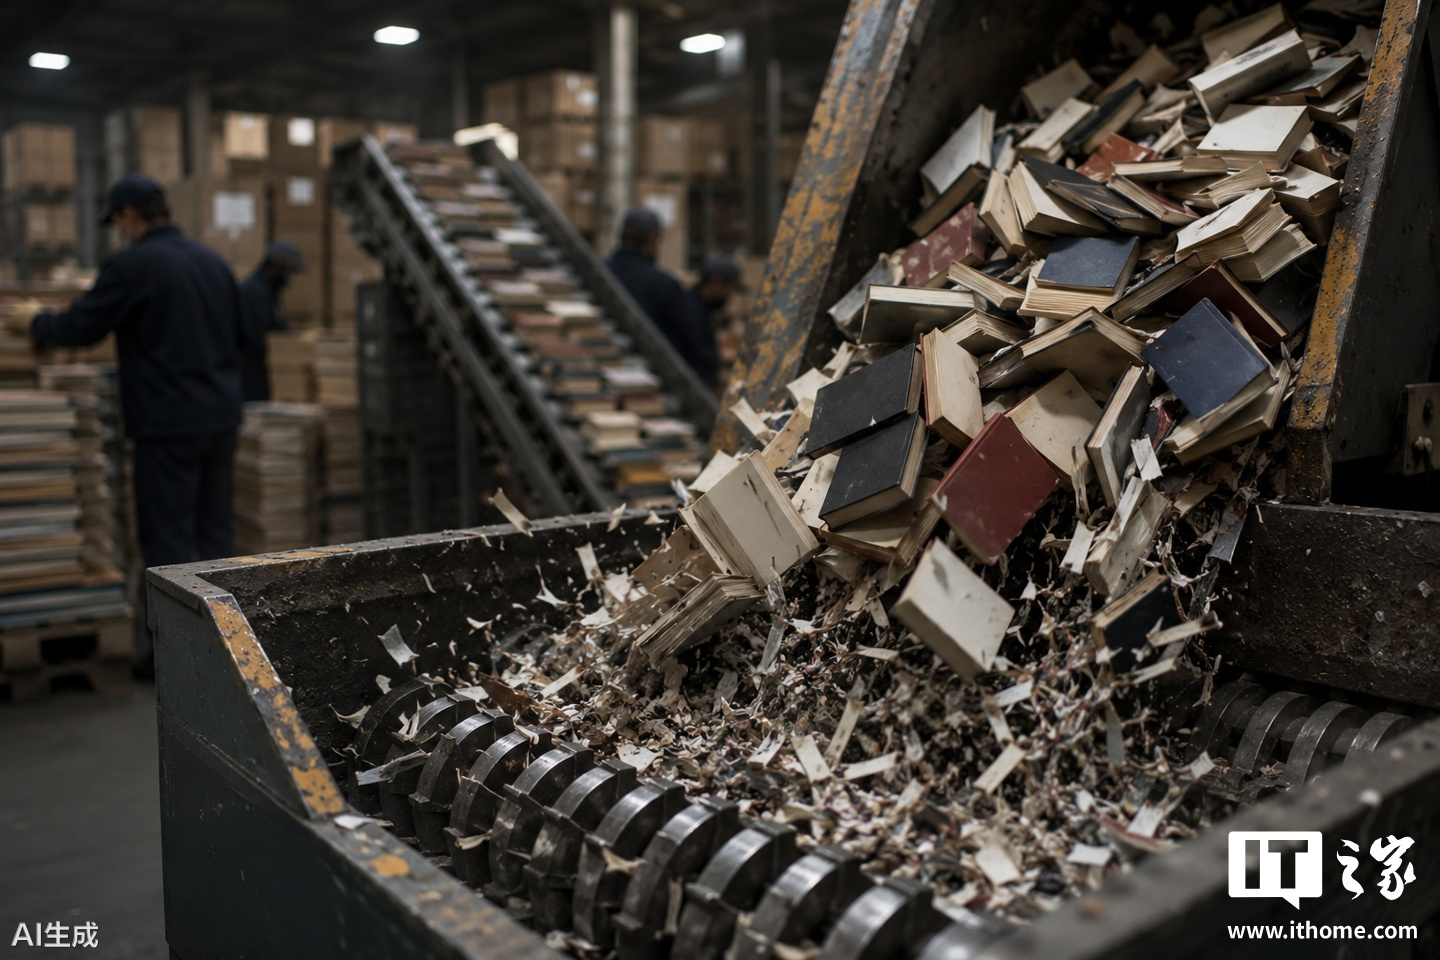
AI企業はメモリやストレージ資源の逼迫を進めた後、今度は人類の文学遺産に目を向けているようだ。調査報道メディア404 Mediaの最新報道によると、複数のAI企業が世論の反発を避けながらAIモデルの訓練に使う高品質な学習データを得るため、仲介業者を通じて中古書籍を大規模に購入している。
AIの発展には膨大なデータが欠かせないが、すべてのデータに価値があるわけではなく、重要なのはデータの品質だ。近年、AIが生成した低品質なコンテンツ、いわゆる「AI生成ゴミコンテンツ」がインターネット上にあふれ、データ環境を汚染するだけでなく、AIの継続的な学習効果も低下させている。そのため、先進的なAI企業は、人間が作成したコンテンツ、特に2022年以前に出版された紙の書籍を改めて探し始めた。こうした内容はオリジナル作品である可能性が高く、AI生成コンテンツによる汚染も受けていないと考えられるためだ。
実際、AI企業が紙の書籍を利用してモデルを訓練した前例はある。現在、著作権訴訟に巻き込まれている主要AI企業の一つであるAnthropicは、紙の書籍を大量に購入するため数百万ドルを投じ、内容を抽出してClaude AIモデルの訓練に利用した後、これらの書籍を廃棄した。同社はBetter World Booksから大量に書籍を購入したとされる。裁判所は、正規に購入した書籍をAIの訓練に利用することは著作権法上の「フェアユース」に当たると認定した一方、Anthropicが700万冊の海賊版書籍を含むデータベースを長期間保管していたことについては、著者や出版社の著作権を侵害したとして、最終的に15億ドル(注:現在の為替レートで約101.62億元)という巨額の賠償を命じた。
同様の論争はGoogleにも起きている。最近、ある出版社連合がGoogleを提訴し、著作権で保護された数百万冊の書籍を無断で使用してGemini AIモデルを訓練したと訴えている。
1.11億冊を超える書籍の書誌情報を収録するオンラインデータベースISBNdbは、長らく書店、図書館、流通業者にとって重要なプラットフォームだった。AI業界の急速な発展に伴い、ISBNdbも事業の方向性を調整し、AI企業向けに大規模な書籍購入サービスを開始した。
404 Mediaの報道によると、関連する注文規模は1回あたり1000冊から100万冊に及ぶ。
匿名を希望するある職業書店員は、今年4月以降、書籍の売上がかつてないほど伸びていると語った。以前、商売が好調な時でも1週間に売れる本は約20冊にすぎなかったが、ここ数か月は週間売上が数百冊に急増し、通常の約5倍に達しているという。
AlibrisやBiblioなどの中古書籍取引プラットフォームに出店するほかの書店員も、同様の大量購入現象が起きていると報告している。
現時点では、これらの購入行為が必ずしもISBNdbや特定のAI企業によるものだと証明する確かな証拠はない。しかし、異常な現象がいくつも見られる。例えば、大規模購入の対象はほぼすべて国際標準図書番号(ISBN)が付いた書籍である。この13桁の数字からなるコードは、世界中の書籍を一意に識別する標識だ。
さらに、こうした購入行為にはテーマ、ジャンル、著者に関する好みがほとんどなく、小説、教科書、専門書を問わず購入対象となっている。より驚くべきことに、買い手は価格をまったく気にしていないようで、一部の書籍が市場価格を明らかに上回っていても、そのまま購入している。
Anthropicの著作権訴訟の過程で、Google Booksプロジェクトに参加し、その後Anthropicの「パナマ計画(Project Panama)」デジタル化プロジェクトを担当したトム・ハーベイ(Tom Harvey)は、Anthropicが複数の専門文書スキャン会社に紙の書籍のデジタル化を依頼したことを証言した。
協力企業の一つがDatamation Information Servicesで、同社は非破壊スキャンと破壊スキャンという2種類の書籍デジタル化サービスを提供している。
非破壊スキャンでは通常、俯瞰型スキャナー、フラットベッドスキャナー、またはV字型スキャン装置を使い、書籍を解体せずにデジタル化する。一方、破壊スキャンでは書籍を直接分解し、各ページを高速の産業用スキャナーに送り込んで処理する。
破壊スキャンは効率が高く、コストも低いため、AI企業は一般的にこの方式を選択しており、その結果、数百万冊の紙の書籍が解体されている。
紙の書籍がAIにとって巨大な知識の宝庫であることは疑いない。しかし、この手法は倫理をめぐる議論もますます引き起こしている。
批判者は、AI企業がデジタル化の過程で、一般的な書籍と貴重な書籍、絶版本を区別しているかどうかは現時点で明らかではないと指摘している。こうした希少な書籍が解体されれば、永久に流通から失われる可能性がある。
さらに大きな問題は、スキャンされた内容が最終的にAI企業の非公開データベースに入り、AIの訓練にのみ使われ、一般の人々はアクセスできないことだ。
つまり、人々はより知能の高いAIを手に入れられるかもしれないが、その代償として、人類が蓄積してきた膨大な知識資源が、公開されアクセス可能な形で未来の世代に残されなくなる可能性がある。