

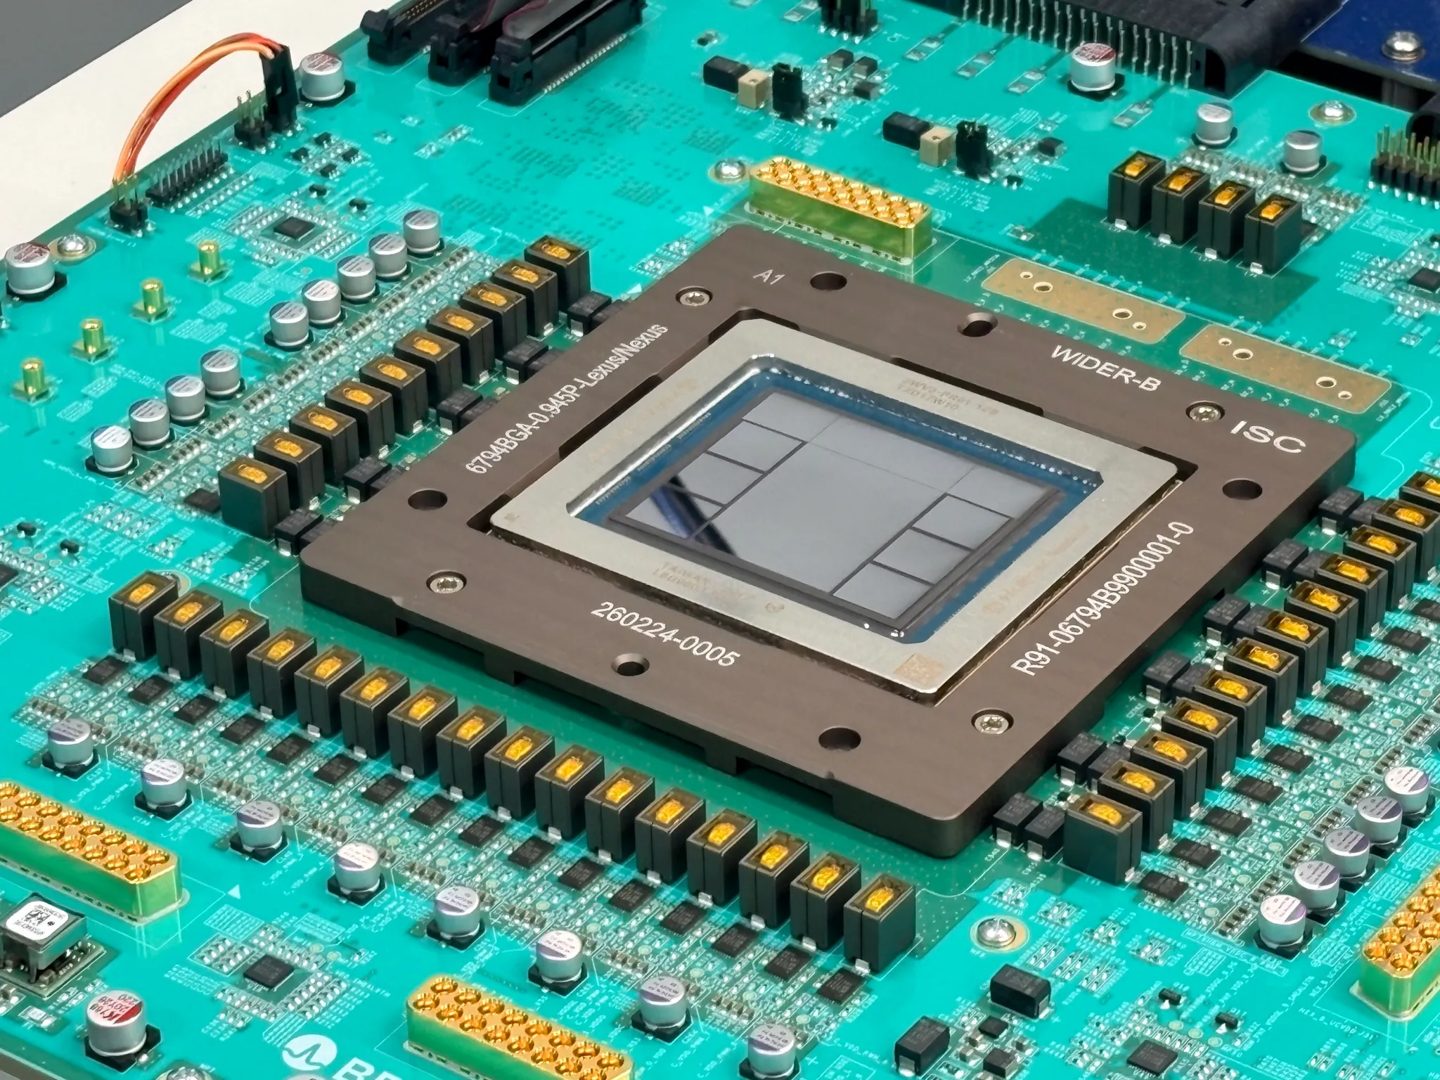
OpenAIは本日(25日)夜、Hot Chipsカンファレンスで新しい推論システム「Jalapeño」の詳細を発表し、ベンチマークテストの結果を初めて公開した。SemiAnalysisのInferenceXテストで、Jalapeñoは1ユーザーあたりのトークン処理量、1kWあたりのスループットのいずれも、現在市場にある最高水準の推論プロセッサーを上回った。
OpenAIのハードウェア責任者であるリチャード・ホー氏はメディア向け電話会見で、「テスト結果で最も重要な点は、Jalapeñoが現時点で最先端の製品と比べて非常に大幅な性能向上を実現したことです。同じ電力でより多くのAIワークロードを処理しながら、より速く応答できます。Jalapeñoは大規模なユーザーに効率よくサービスを提供できるだけでなく、非常に低いレイテンシーも維持できます」と述べた。
JalapeñoはOpenAIとブロードコムが共同開発したもので、OpenAI独自のモデルも開発に参加した。OpenAIはJalapeñoを複数世代にわたって発展させられる技術プラットフォームにし、AI製品、モデル、チップ、メモリを当初から協調設計することを目指している。
このチップは主にAI推論、つまり学習済みのAIモデルを実際に動作させ、タスクを完了したりAIエージェントを駆動したりする処理を担う。
OpenAIはInferenceXプラットフォームを使ってJalapeñoの推論性能をテストし、NVIDIA GB200およびGB300スーパー チップシステムと比較した。OpenAIによると、GPT-OSS 120B、DeepSeek R1、Kimi K2.5 1Tの3モデルにおいて、Jalapeñoが1ワットあたりに実行できるAIワークロードは比較対象システムの1.5~1.9倍で、エンドツーエンドのレイテンシーは比較対象システムの約28%~59%だった。
フルスタックでの協調開発により、OpenAIは推論プロセスで速度低下を招きやすい部分を直接最適化することも可能になった。Jalapeñoはプリフィルと通信段階のレイテンシー低減を重視しており、OpenAIはこの2つの段階が推論性能の主なボトルネックになりやすいと見ている。
OpenAIはテスト結果を発表したブログ記事で、Jalapeñoは設計当初からデータ移動と通信遅延をできる限り削減していると説明した。応答生成時に使用するKVキャッシュなどのモデル状態は、明確な形でローカルに保存・保持でき、システムは推論の各段階に応じて、適切な計算、メモリ、ネットワーク資源を割り当てる。
IT之家の情報によると、OpenAIは今年末までにまずJalapeñoを「小規模」に導入し、2027年に導入規模を段階的に拡大する計画だが、来年具体的に何個のチップを投入するかは明らかにしていない。
参考
OpenAI公式記事:Jalapeño’s first results show industry-leading speed and efficiency in AI inference