

ByteDanceは本日(7月31日)、中国国内でSeedance 2.5動画生成モデルを発表した。1回で30秒の高品質な動画クリップを生成でき、即夢AIと豆包プロ版で順次提供を開始している。APIサービスも近日中に火山方舟へ接続される予定だ。
公式によると、Seedance 2.5はSeedance 2.0の統合型マルチモーダル音声・動画同時生成アーキテクチャを継承し、長編ナラティブ、マルチモーダル参照、編集機能を重点的に強化した。
このモデルは、映像制作、広告、教育、工業製造、具身知能、自動運転などの分野を対象としており、動画生成を「1つのクリップを生成する」段階から「1つの作品を完成させる」段階へ進めることを目指している。
生成機能では、Seedance 2.5が1回あたりの動画生成時間を15秒から30秒へ延長し、複数回の延長にも対応した。公式によると、モデルは30秒以内に論理的につながる複数のショットを構成し、物語を導入、展開、転換、結末の流れで展開できる。
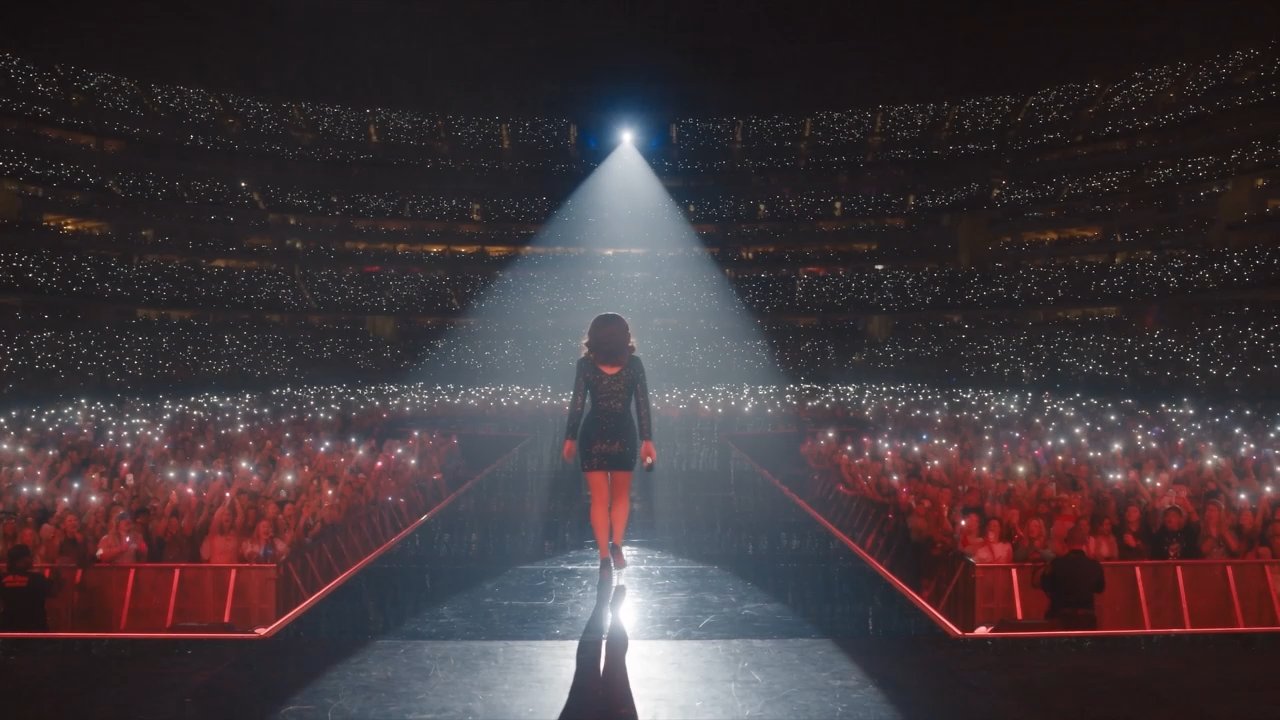
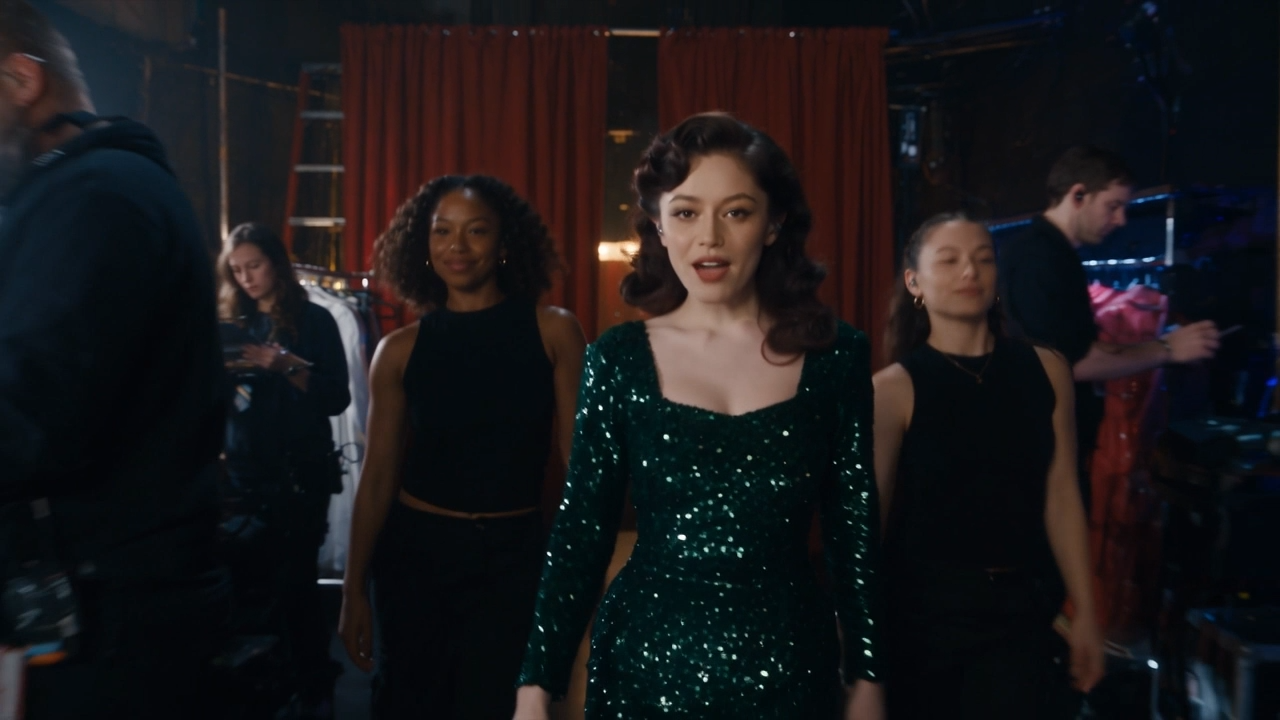
公式サンプルでは、歌手がワンカットでステージに登場してパフォーマンスする動画により、完整な物語表現が示された。カメラは赤く重厚な幕の隙間から進み、暖色系の楽屋へ入る。若い女性歌手がイヤホンを整え、スタッフが登壇を促す。歌手は楽屋裏の通路を通り、ダンサーと交流してマイクを受け取る。その後ステージに上がり、カメラは最終的に引いてスタジアム全景を映し、観客、応援ボード、ペンライト、歓声を捉える。
複数回の延長について、公式サンプルでは、既存の動画を基にさらに30秒を生成し、人物、シーン、映像スタイル、音声、効果音の一貫性を保つようモデルに求めている。サンプルのストーリーには、少年がサッカーボールを抱えて車内を走る、地下鉄が停車するとドアから飛び出す、男性主人公が追いかけて最終的に少年を捕まえるといった連続動作が含まれている。
Seedance 2.5は、ユーザーが1回の入力で最大30枚の画像、10本の動画、10本の音声を参照素材として指定できる。公式によると、モデルは異なる素材に含まれる画面構成、シーン、スタイル、人物、道具などの要素を総合的に理解し、指示に従って動画生成に利用できる。
複数人が同じフレームに収まる場面や群像劇では、Seedance 2.5は複数の人物の姿と声を同時に再現し、主要人物の特徴を安定して維持できる。公式が公開した30秒のコンサート映像は、16:9の横長画面と映画的なリアル調のスタイルを採用し、参照素材には会場、ピアニスト、チェロ、バイオリン、ボーカル、オーケストラ、合唱団、観客席が含まれている。
参考リンク
Seedance 2.5プロジェクトホームページ