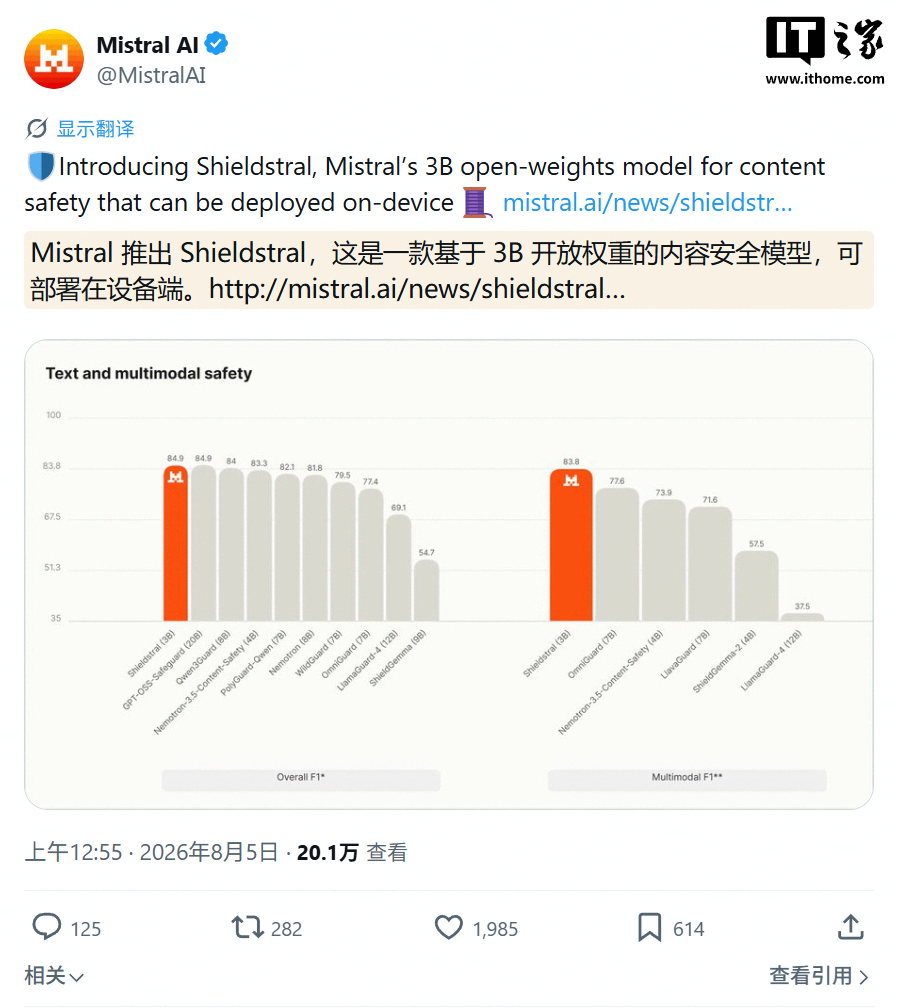
Mistral AIは昨日(8月4日)、ShieldstralコンテンツモデレーションAIモデルの提供開始を発表した。総パラメータ数は3B(30億)で、オープンウェイトを採用し、Apache 2.0ライセンスで公開される。
モデルはHugging Faceで公開されており、12言語に対応し、16GB GPU 1枚で実行できる。Mistralによると、同モデルはコンテンツの安全性において、7倍の規模を持つオープンモデルに匹敵する性能を発揮し、マルチモーダルコンテンツモデレーション分野でSOTAを達成している。
注:SOTAはstate-of-the-artの略で、特定の人工知能タスクやベンチマークテストにおいて最も優れた性能を示す、最先端のモデルやアルゴリズム群を指す。技術の進歩や新たな研究の発表に伴い、常に変化している。
Mistralによると、多くのガードモデルは有害性のカテゴリ体系をモデルの重みに固定している。製品の利用シーンを変更する場合、開発者は通常、モデルを再トレーニングする必要がある。
一方、Shieldstralはモデレーションポリシーを入力内容に組み込む。操作者は「はい」または「いいえ」で答えられる質問を記述し、評価シナリオと厳格さのレベルを指定できる。モデルはその後、単一の出力トークンからキャリブレーション済みの安全性スコアを生成する。
モデルは各モデレーションタスクを二値質問に変換し、入力にはラベル付きの3つのフィールドが含まれる:
<Instruct>:評価シナリオと厳格さのレベルを説明する。
<Query>:1つの「はい」または「いいえ」で答えられる質問を提示する。例:「このコンテンツは身体的暴力を助長していますか?」
<Document>:モデレーション対象のコンテンツを提供する。プロンプト、回答、プロンプトと回答の組み合わせ、または任意のテキストを添付した画像を指定できる。
推論時、モデルは「はい」と「いいえ」2つのトークンの論理値だけを読み取り、softmaxで正規化して連続スコアに変換し、0.5をしきい値として二値判定を出力する。この仕組みにより、プロンプト分類、回答モデレーション、拒否応答の検出、毒性検出に対応できる。