

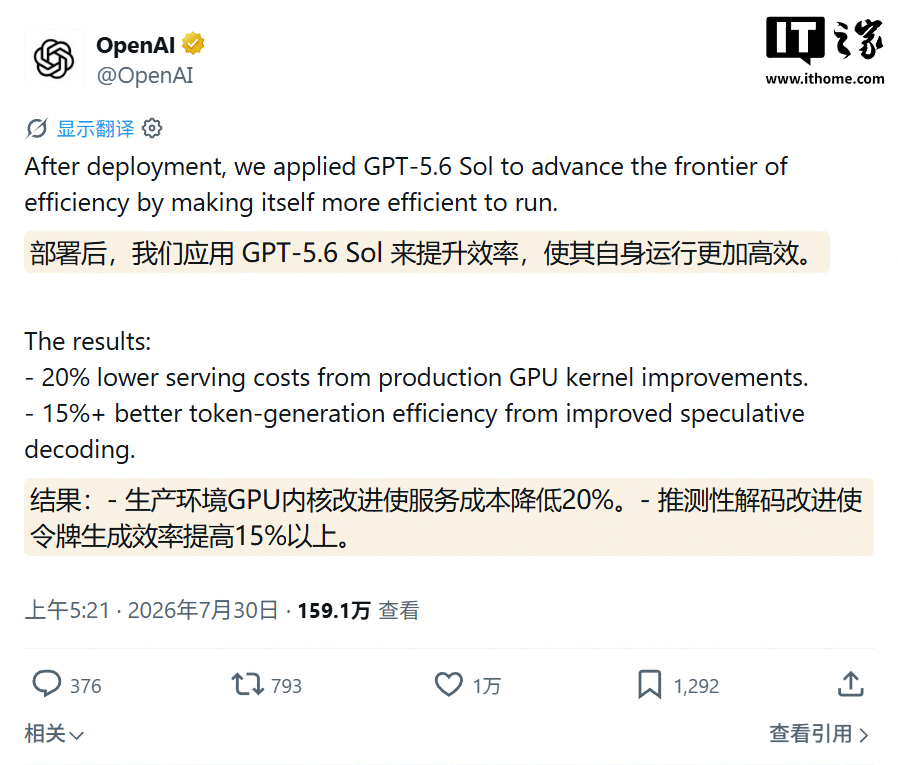
OpenAIは昨日(7月29日)、GPT-5.6 Solモデルを活用してGPT-5.6シリーズ自体のAI推論処理を最適化し、エンドツーエンドのサービスコストを最大20%削減したと発表しました。
OpenAIは7月9日、同社最強のAIモデルであるGPT-5.6シリーズを発表しました。その後のアーキテクチャ最適化において、公式チームはGPT-5.6 Solモデルを利用して自身の実行効率を改善し、計算コストを削減するとともに、GPUの利用効率を高めました。
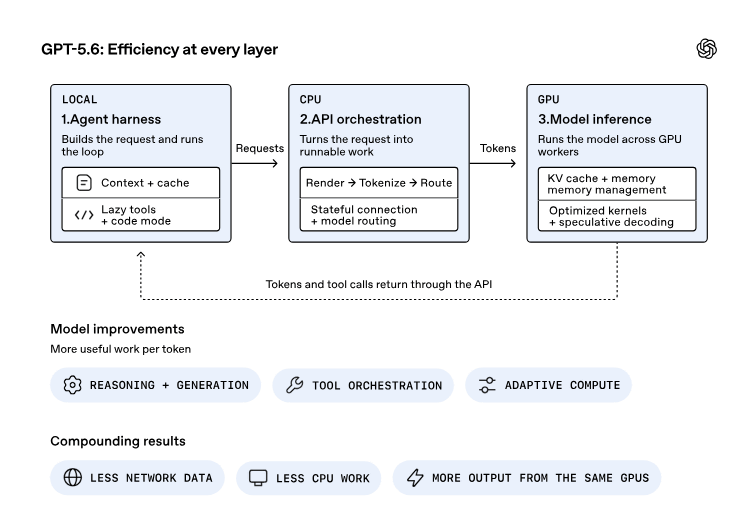
OpenAIによると、システムは地域、利用可能な容量、アクセラレーターの種類に応じてリクエストを割り当てます。クラスター内では、負荷、コンテキスト長、キャッシュの利用可能性なども考慮してタスクを振り分けます。GPT‑5.6 SolはCodexを通じて本番トラフィックを分析し、負荷の偏りの原因を特定し、ルーティング戦略をテストしてヒューリスティックルールを調整します。
モデルのフォワードパス処理では、GPT‑5.6 Solが事前計算可能な処理、回避可能な処理、並列化可能な処理を特定し、Codexを通じて本番環境のGPUカーネルを自律的に書き換え、最適化します。関連するスクリーンショットは以下のとおりです。
チームはGPT-5.6 SolモデルにTritonとGluonという2種類のプログラミング言語を学習させ、それに基づいて推論エンジンのカーネルを最適化しました。これにより、本番環境のGPUカーネルによるエンドツーエンドのサービスコストを最大20%削減しました。
OpenAIはさらに、オープンソースツールのFpSan(浮動小数点数クリーナー)を使用して、GPT‑5.6 Solが作成したカーネルの正確性を検証しました。
OpenAIはGPT-5.6 Solに推測的デコーディング(speculative decoding)の最適化も行わせました。この推論高速化技術では、小型のドラフトモデルが次のtokenを予測し、その後メインモデルが予測結果を検証または修正します。OpenAIは2026年7月29日の公開投稿で、改善後のtoken生成効率が15%を超えて向上したと述べています。