
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-10-10
01TalkLikeYouとは
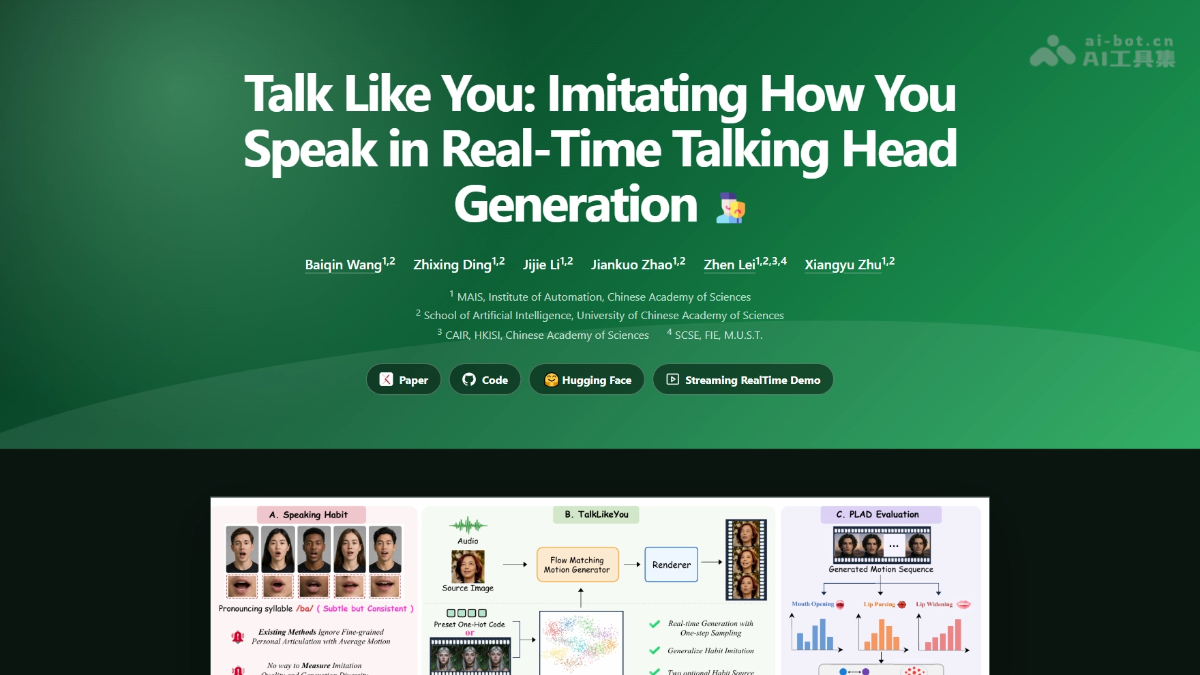
TalkLikeYouは中国科学院自動化研究所がオープンソースで公開するリアルタイムデジタルヒューマンフレームワークです。1枚の写真と音声を入力すると、写真の人物が話す動画を生成でき、口元の動きは指定した人物の話し方の癖を模倣できます。TalkLikeYouはモーション空間モデリングとワンステップサンプリングによってリアルタイム生成を実現し、プリセット番号または参照動画による話し方の癖のカスタマイズに対応しています。さらに、模倣の類似度を定量化する専用指標を提案し、コードとモデルの重みをすべて公開しています。
02TalkLikeYouの主な機能
写真をしゃべらせる:人物写真1枚と音声をアップロードすると、人物が話す動画を生成できます。
話し方の癖の模倣:指定した人物の口元の話し方の癖を模倣できます。プリセット番号または4秒間の参照動画で指定します。
リアルタイム生成:ワンステップサンプリング技術を採用し、生成速度は32.43 FPSに達します。リアルタイムのストリーミング出力にも対応しています。
動画の吹き替え:動画内の人物の口元の動きを置き換え、元の頭部の動きと時系列を維持できます。多言語吹き替えに適しています。
対話型デジタルヒューマン:大規模モデルと音声認識・音声合成を接続することで、リアルタイム対話が可能なデジタル分身を実現できます。
スタイル化された駆動:スケッチ、油絵、アニメ、3Dキャラクターなど、実写ではないスタイルの人物画像にも対応しています。
03TalkLikeYouの技術原理
WeChatでフォローして「开源」と返信すると、AIオープンソースプロジェクトの交流グループに参加できます。
モーション空間モデリング:TalkLikeYouは画素空間で直接画像を生成するのではなく、まず写真をモーションパラメータに解析します。この軽量な数値表現上で話す動きを学習・生成し、レンダラーで動画に合成することで、速度と本人性の安定性を両立します。
ワンステップFlow Matchingサンプリング:Flow Matchingでノイズから目標までの直線経路を学習し、再パラメータ化と組み合わせてクリーンなモーション系列を直接予測します。ワンステップサンプリングで約50ステップに近いリップシンク品質を実現し、32.43 FPSのリアルタイム速度を達成します。
統一された話し方の癖の空間:補間可能な低次元の話し方の癖ベクトル空間を構築し、データセット内の人物の口元の動きの統計をone-hotエンコーディングに圧縮します。参照動画は癖抽出器によって同じ空間にエンコードされるため、2つの入力方法を自由に切り替えたり、補間して組み合わせたりできます。
2段階の学習戦略:まず380人規模のHDTFでone-hotエンコーディングを使って「話し方の癖とは何か」を学習し、その後、大規模なCelebV-HQで参照動画に切り替えて汎化能力を学習します。定期的にone-hotデータをリプレイして忘却を防ぎ、癖の類似度を0.33から0.64に向上させています。
PLAD評価指標:口元の動きを、口の開き幅、唇のすぼめ、唇の横への広がりという3つの発音軸に投影し、分布ヒストグラムで参照人物との類似度を比較します。初めて「話し方の癖がどれだけ似ているか」に定量的な基準を提供します。
04TalkLikeYouの使い方
環境の準備:Linuxシステムを使用し、Python 3.10 + CUDA 12.1 + FFmpegをインストールします。NVIDIA GPUのVRAMは少なくとも12GB必要です。
コードのダウンロード:GitHubからTalkLikeYouのメインリポジトリをクローンします。
依存関係のインストール:conda env create -f environment.yamlを実行して環境を作成・有効化するか、CUDA版PyTorchを自分でインストールした後、pip install -r requirements.txtを実行します。
モデルの重みのダウンロード:Hugging Faceのコマンドhf download doubi-killer/TalkLikeYouを使い、モデルの重みをリポジトリのルートディレクトリにダウンロードします。
素材の準備:人物写真(または動画)と音声を用意します。入力動画は25 FPSである必要があります。
推論の実行:python -m talklikeyou --source 写真 --audio 音声 --person-id 192 --sampling-steps 1を実行して動画を生成します。--person-idを変更すると話し方の癖を変更できます。
癖のカスタマイズ:--person-idを--habit-referenceに置き換え、100フレーム以上の参照動画を指定すると、その動画内の人物の話し方の癖を模倣できます。
動画の吹き替え:--sourceに動画ファイルを指定し、--pose-mode sourceを追加すると、口元の動きだけを置き換えて元の頭部の動きを維持できます。
05TalkLikeYouの主な強み
話し方の癖を個別に模倣:個人の口元の話し方の癖を独立した重要な要素としてモデル化した、業界初のオープンソースフレームワークです。番号または動画で指定でき、「誰が話しても同じ」平均的な口元表現から脱却できます。
高速なリアルタイム処理:ワンステップFlow Matchingサンプリングにより32.43 FPSを実現します。画像拡散ベースのSonicより約100倍高速で、単一のRTX 3090でもVRAM使用量は4GB未満です。
画質と同期を両立:FIDは7.71で2位の3分の1未満、Sync-Cは8.73で全体最高となっており、リップシンクと画質を両立しています。
話し方の癖の類似度で優位:PLAD指標による話し方の癖の類似度は0.62で、MimicTalk(0.48)やPC-Talk(0.39)などの競合を大きく上回ります。
2つの入力方法で柔軟にカスタマイズ:公式のプリセット番号によるコストなしのスタイル切り替えに対応し、任意の参照動画からその場で学習できます。補間によって新しい話し方の癖を作ることも可能です。
06TalkLikeYouのプロジェクトURL
プロジェクト公式サイト:https://bq-wang0511.github.io/TalkLikeYou/
GitHubリポジトリ:https://github.com/BQ-Wang0511/TalkLikeYou
Hugging Faceモデルリポジトリ:https://huggingface.co/doubi-killer/TalkLikeYou
arXiv技術論文:https://arxiv.org/pdf/2610.06658
07TalkLikeYouの活用シーン
バーチャル配信者・ライブコマース:個人特有の話し方の癖を持つバーチャル配信者を低コストで構築できます。4GBのVRAMでローカルのリアルタイム実行が可能で、本人が出演する必要もありません。
多言語動画の吹き替え:動画内の人物の口元の動きを置き換えながら、元の頭部の動きと時系列を維持できます。映画の吹き替えや海外向けコンテンツで、口の動きを対象言語に自然に合わせられます。
デジタル分身・バーチャルカスタマーサポート:大規模モデルと音声合成を組み合わせてリアルタイム対話型の分身を構築し、オンラインサポートやインテリジェントガイドなど、「対面」でのやり取りが必要な場面に活用できます。
個別最適化された教育・研修:教師や研修講師専用のデジタルアバターを作成し、独自の話し方を再現できます。講座の録画や遠隔授業に利用できます。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0