
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-11-05
01OmniEduとは
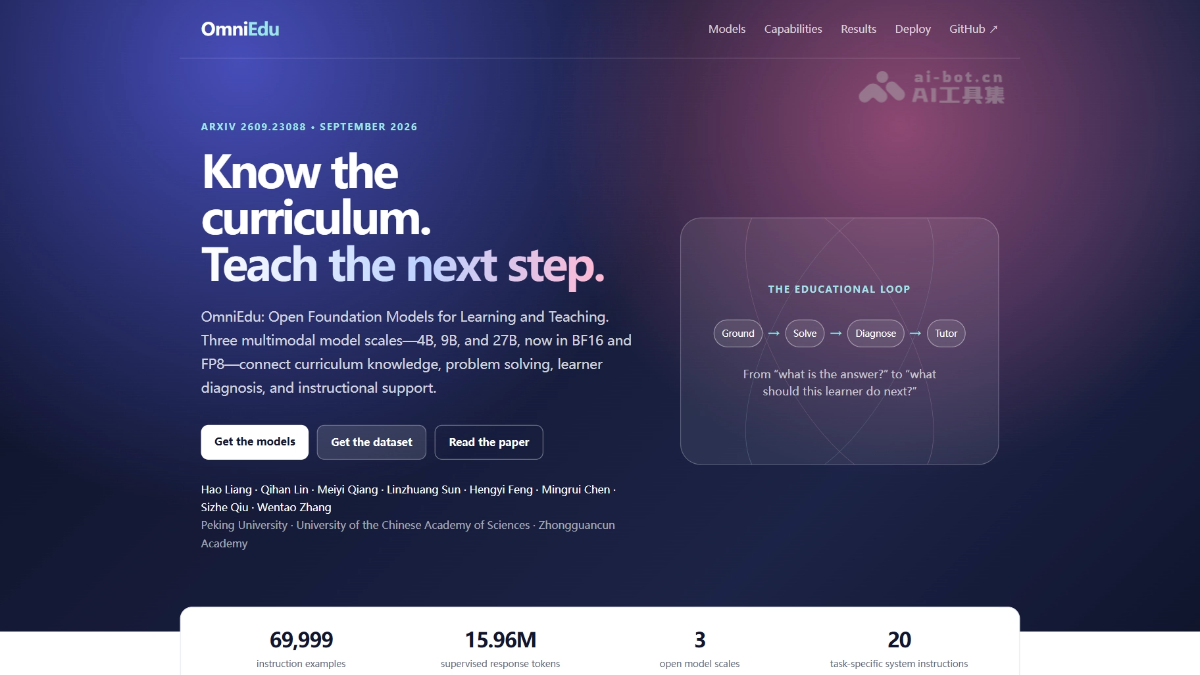
OmniEduは北京大学DCAIチームが中国科学院大学、中関村学院と共同でオープンソース化した教育用マルチモーダルモデルシリーズで、27B、9B、4Bの3規模を提供します。OmniEduは教育能力を重視し、教科問題への回答、知識点のカリキュラム上の位置づけの判断、生徒の誤答原因の診断、適切な教育アクションの選択を行えます。チームは134万件の候補データから約6.9万件のサンプルを厳選して学習に使用し、モデルは複数教科、診断、指導タスクでSOTAレベルに到達しました。そのうち4Bの小型モデルは一般的なサーバーに導入でき、学校での利用のハードルを下げます。
02OmniEduの主な機能
教科問題の解答:数学、科学、読解、作文をカバーし、正解を示すとともに、説明が問題の条件や推論過程と整合するようにします。
カリキュラム理解:問題に対応する知識点、学年、難易度、前提関係を識別し、学習を続ける前に何を補う必要があるかを判断します。
診断推論:生徒の解答過程と誤答に基づき、単に問題から推測するのではなく、誤りの手順、理解のずれ、補足が必要な知識を特定します。
教育アクション:タスクに応じて、ヒント、誘導質問、前提概念の復習、誤りの指摘、完全な解説など、適切な応答方法を選択します。
03OmniEduの技術原理
WeChatでフォローし「开源」と返信すると、AIオープンソースプロジェクト交流グループに参加できます
タスク目標に基づくデータ設計:学習データは約134万件の候補サンプルから、クリーニング、意味審査、品質評価、多様性選別を経て約6.9万件を残します。各教育サンプルを4種類の能力に分類し、20種類のタスク指示のいずれかを割り当て、「サンプルが何を教えるか」と「モデルがどう応答すべきか」を分けてアノテーションすることで、モデルがタスクに応じて行動を切り替えられるようにします。
意味審査と書き換え:言語モデルでタスク基準に沿ってサンプルを審査し、解答の正確性、カリキュラム上の関係、診断根拠、足場かけの質を確認します。不合格の場合は教師回答を書き換えて再審査します。同時にマルチモーダルサンプルの画像とテキストの整合性を確認し、出典の許諾情報を保持して、規約に適合しない出典を除外します。
汚染除去と構造統一:メッセージ形式を統一し、重複、必須フィールド欠落、構造破損のサンプルを削除します。検証可能なタスクの回答を照合し、学習データと評価セットを重複排除して、結果の歪みを防ぎます。
トークン予算に基づく学習比率の調整:長い指導対話は短い回答より多くの教師トークンを含むため、サンプル数でサンプリングすると長い対話の比率が過大になります。タスクバケットごとにトークン予算を配分し、重要な次元の基準を引き上げて多様性を選択することで、各種教育タスクが実際に受ける教師信号量を制御します。
04OmniEduの使い方
方法1:ローカル実行(Transformers) 依存関係のインストール:pip install -U torch torchvision transformers accelerate safetensors pillowを実行します(FP8重みを使用する場合はcompressed-tensorsも追加でインストールが必要です)。
モデルの読み込み:AutoProcessorとQwen3_5ForConditionalGeneration.from_pretrainedを使用して、対応するモデルID(例:lhpku20010120/Omni-Edu-4B)を読み込みます。9B/27BはIDを変更するだけで利用できます。
入力の構築:生徒の問題、解答、画像をchatテンプレートに従ってmessagesとして構成し、画像問題には{"type": "image"}項目を追加します。
回答の生成:generateを呼び出します(必ずenable_thinking=Falseを指定)。batch_decodeで出力結果をデコードします。
方法2:サービスのデプロイ(vLLM、推奨) サービスの起動:vllm serve lhpku20010120/Omni-Edu-4B --max-model-len 32768 --reasoning-parser qwen3 --default-chat-template-kwargs '{"enable_thinking": false}'を実行します(FP8版ではOmni-Edu-4B-FP8に変更し、マルチGPU時は--tensor-parallel-sizeを調整します)。
リクエストの送信:curlでhttp://localhost:8000/v1/chat/completionsにアクセスし、OpenAI互換形式で質問します。
方法3:公式ツールキットの利用 SDKのインストール:pip install omnieduを実行します(評価にはomniedu[eval]のインストールが必要です)。
対話の呼び出し:OmniEdu.from_pretrained("4B", base_url=サービスアドレス)の後、model.chat(text=...)を使用して質問します。
評価比較:omniedu eval --listで12の教育評価ベンチマークを確認し、レポートを生成します。
05OmniEduの主な優位性
タスク指示による行動切り替え:20種類のシステム指示により、同じモデルで段階的な問題解決、誤答診断、ソクラテス式質問、指導対話など、タスクに応じた応答方法を使い分けられます。
綿密に設計された高品質な学習データ:約134万件の候補サンプルから、意味審査、汚染除去、トークン比率の調整を経て約7万件を厳選し、「何を学ぶか」と「どう教えるか」を明確にしています。
SOTAレベルの性能:27BはGPT-5.4、Claude-Opus-5など5つの最先端モデルとの60回の比較で51回勝利し、複数の教育指標で首位となりました。
足場かけ指導の大幅な向上:MathTutorBenchの足場かけ勝率は最高で14%から78.74%に上昇し、教育行動を効果的に学習できることを示しました。
さまざまなシーンに対応する複数規模:4B、9B、27Bをすべてカバーし、FP8版ではダウンロード容量を37%–44%削減。小型モデルは学校の一般的なサーバーにも導入できます。
06OmniEduのプロジェクトアドレス
公式サイト:https://haolpku.github.io/Omni-Edu/
GitHubリポジトリ:https://github.com/haolpku/Omni-Edu
HuggingFaceモデルリポジトリ:https://huggingface.co/datasets/lhpku20010120/Omni-Edu
arXiv技術論文:https://arxiv.org/pdf/2609.23088
07OmniEduの利用シーン
個別学習指導:生徒が問題を解く際、モデルがまずつまずいている箇所を特定し、ヒントや追加質問によって自力で考えられるよう導くため、自習に適しています。
誤答診断分析:教師が生徒の解答過程をモデルに入力すると、誤答の原因や対応する知識の不足を自動分析し、的を絞った補習案を生成して、採点の負担を軽減します。
カリキュラムに沿ったコンテンツ生成:教師は指定したカリキュラム基準と学年に基づいて、練習問題、レベル別課題、解説資料を生成し、知識点の対応関係と前提関係を自動で注記できます。
授業インタラクション支援(ソクラテス式教授法):モデルがティーチングアシスタントを演じ、誘導質問によって生徒の推論を促します。根拠に基づいて指導方針を調整し、習熟度別指導をサポートします。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0