
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-10-15
01DMADとは
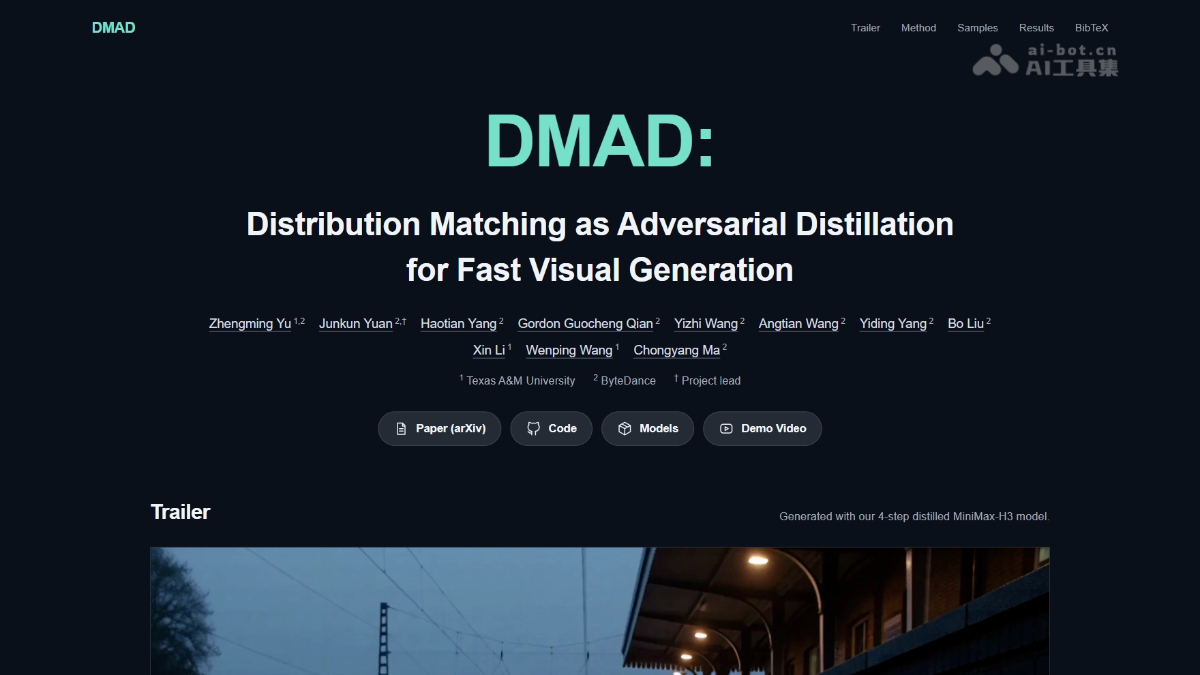
DMAD(Distribution Matching as Adversarial Distillation)は、ByteDanceとテキサスA&M大学が共同でオープンソース化した少ステップ蒸留フレームワークで、拡散モデルの生成を高速化します。DMADは二値分類判別器を学習して、目標分布と学生分布の差異を直接学習し、補助拡散モデルを不要にします。50ステップの教師モデルを4ステップの学生モデルへ蒸留できます。ImageNet、SDXL、Wan2.1、MiniMax-H3-33Bに対応しており、8GBのVRAMで約5秒の1344×768音声付き動画を生成できます。
02DMADの主な機能
少ステップ画像生成:ImageNet-64のEDMモデルを1ステップサンプリングへ蒸留し、FIDは最小1.04を達成します。SDXLはわずか4ステップでテキストから画像を生成できます。
少ステップテキスト動画生成:Wan2.1-T2V-14Bを4ステップの学生モデルへ蒸留し、VBenchで85.15を達成します。
音声・動画の統合生成:MiniMax-H3-33Bの50ステップ教師モデルを4ステップへ蒸留し、1344×768の動画と32kHzネイティブステレオ音声を出力します。
コンシューマー向けハードウェア対応:8GB VRAM向けのComfyUIワークフローと低VRAM向けコマンドライン推論を提供し、8GB GPUでは約5秒、12GB GPUでは約15秒の音声付き動画を生成できます。
学習・推論を完全オープンソース化:蒸留手法、学習コード、推論スクリプト、多モデルLoRA重みを公開し、コマンドラインとComfyUIの両方に対応します。
03DMADの技術原理
WeChatでフォローして「开源」と返信すると、AIオープンソースプロジェクト交流グループに参加できます。
分布マッチングによる敵対的蒸留:DMADは二値分類判別器を学習し、目標サンプルと学生サンプルを区別します。最適判別器のlogitは2つの分布の対数密度比に等しく、その入力に対する勾配を求めることでscoreの差が得られます。これにより学生モデルの修正方向を直接導出でき、補助的なscoreフィッティングモデルが不要になります。
共有バックボーンと2つの判別ヘッド:判別器は単一の共有特徴バックボーンと2つの判別ヘッドで構成されます。教師ヘッドは教師サンプルと学生サンプルを、実データヘッドは実データサンプルと学生サンプルを区別し、いずれもバイナリクロスエントロピーで学習します。学生モデルは2つのlogitの加重線形損失で更新され、更新時には判別器パラメータを凍結しつつ、勾配の逆伝播は維持します。
ノイズ区間の動的重み付け:教師サンプルと実データの分布差はノイズレベルによって変化します。DMADは、実データヘッドが2種類のサンプルに出力する平均logitの差を経験的シグナルとして使用し、減衰率0.99の指数移動平均で各ノイズ区間を追跡します。差が小さい区間ほど高い教師重みを付与し、正規化したうえで学生損失に使用します。
オフライン教師サンプルによる学習高速化:教師モデルは事前生成・キャッシュ済みのサンプルのみを提供するため、学習中に教師モデルをオンラインで呼び出す必要がありません。4枚のH200、MiniMax-H3 rank-128 LoRA構成では、1回の学生更新と関連する判別器更新にかかる時間が818.1秒から233.3秒に短縮され、約3.51倍の学習高速化を実現します。
04DMADの使い方
リポジトリをクローン:git clone https://github.com/Yzmblog/DMAD.git を実行し、プロジェクトディレクトリへ移動します。
環境を作成:condaでPython 3.12環境を作成して有効化します。
依存関係をインストール:公式の固定バージョンに従ってPyTorch 2.11.0(cu126)、torchvision、torchaudioをインストールし、その後 pip install -r requirements.txt と pip install -U modelscope-hub を実行します。
ハードウェアを準備:CUDA対応のNVIDIA GPUを用意し、システムメモリ約64GBとディスク容量170GBを確保します。
ベースモデルをダウンロード:modelscope download MiniMax/MiniMax-H3 を実行してMiniMax-H3ベースモデルをダウンロードします。
蒸留重みをダウンロード:魔搭からDMADの4ステップLoRAをダウンロードします。
コマンドラインで推論:inference.pyを実行し、モデルパス、LoRA、プロンプトファイル、--steps 4、--height 768 --width 1344を指定します。VRAM容量に応じて --low-vram 8 または --low-vram 12 を選択します。
出力を確認:出力ディレクトリには0000.mp4、プロンプトtxt、settings.jsonが含まれます。正常に動作したら、自分のプロンプトファイルに置き換えられます。
05DMADの主な優位性
推論を大幅に高速化:50ステップの教師モデルを4ステップの学生モデルへ蒸留し、デノイズ反復回数を92%以上削減しながら、教師モデルに近い生成品質を維持します。
高い学習効率:判別器が分布差を直接学習するため、補助拡散モデルが不要です。4枚のH200では学習更新を約3.51倍高速化できます。
優れた生成品質:ImageNet-64の1ステップ生成でFID 1.04を達成し、DMD2やSiDAなどの手法を上回ります。人間による評価では、DMD2に対する総合選好率79.1%、rCMに対して84.6%を達成しています。
マルチモーダルな用途を網羅:同一フレームワークで画像生成、テキスト動画生成、音声・動画の統合生成に対応します。
06DMADのプロジェクトリンク
プロジェクト公式サイト:https://yzmblog.github.io/projects/DMAD/
GitHubリポジトリ:https://github.com/Yzmblog/DMAD
HuggingFaceモデルリポジトリ:https://huggingface.co/ZhengmingYu/DMAD
arXiv技術論文:https://arxiv.org/pdf/2610.02188
07DMADの利用シーン
ショート動画コンテンツ制作:ネイティブ音声付きの5–15秒動画を4ステップで生成できます。クリエイターは8GBのコンシューマー向けGPUでソーシャルメディア用素材を迅速に制作でき、制作コストを大幅に削減します。
広告・マーケティング素材の生成:ブランド企業はプロンプトに基づいて商品紹介やシーン動画を一括生成し、高品質な音声出力と組み合わせることで、広告素材の構想から完成までの期間を短縮できます。
映像制作のプリビズとコンセプトデザイン(Previs):監督や美術チームは少ステップ蒸留によってショットのプレビジュアライゼーション、雰囲気の参考素材、絵コンテの草案を迅速に生成し、初期段階のアイデア検討を加速できます。
ゲーム・アニメーション素材制作:キャラクターアニメーション、シーンコンセプト画像、動的背景素材を生成し、インディーゲームスタジオや小規模アニメーションチームの素材制作コスト削減を支援します。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0