
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-09-15
01HiDream-O1-Video-1.0とは
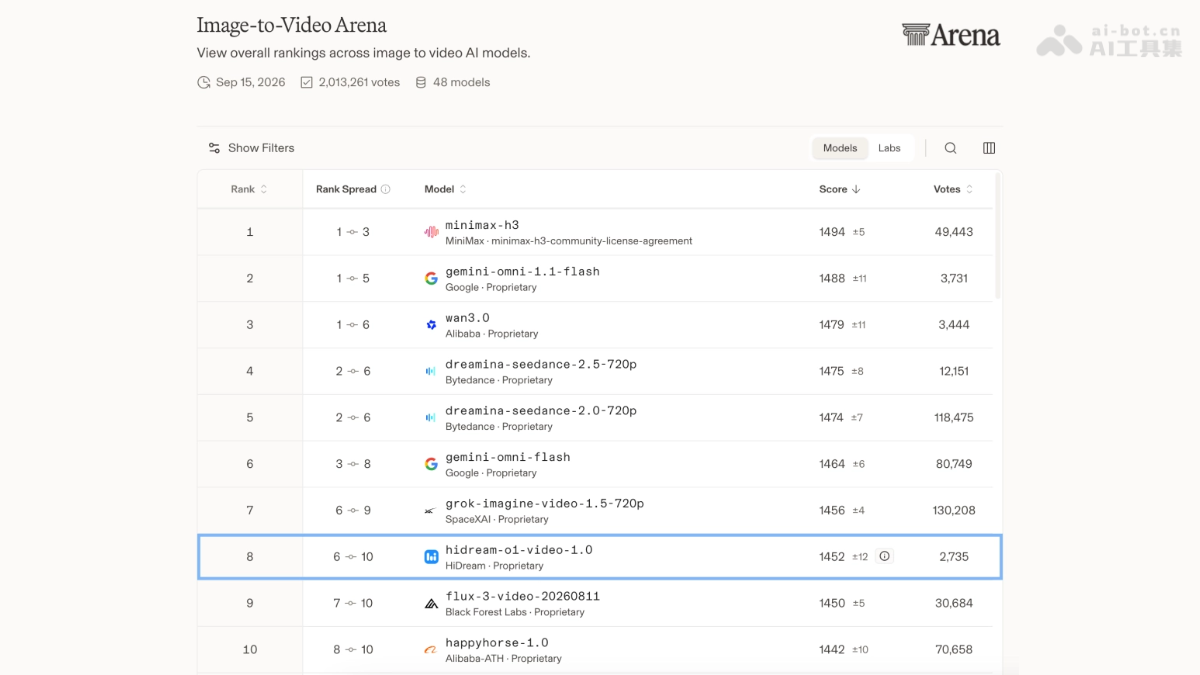
HiDream-O1-Video-1.0(略称:HD-V1)は、智象未来(HiDream.ai)が開発したネイティブな全モーダル動画生成モデルです。テキスト、画像、動画などのマルチモーダル入力に対応し、ワンクリックで5~20秒の1080p動画を直接生成できます。物理法則に基づく生成と音声・映像のネイティブな一体化を実現しており、Artificial Analysisの画像から動画生成ランキング(With Audio)で世界第4位、Arena.aiのブラインドテストランキングで第8位にランクイン。中国のAI動画技術が世界トップクラスに入ったことを示しています。
02HiDream-O1-Video-1.0の主な機能
マルチモーダル入力:テキスト、画像、動画など、複数のモダリティを生成条件としてサポート。
高忠実度動画の直接出力:ワンクリックで5~20秒の1080p高画質動画を生成。
意図理解:マルチモーダル理解モジュールを前段に配置し、口語的な入力をショット、キャラクター、動作、効果音などの専門的なプランへ構造化。
物理法則に基づく生成:重力、衝突、慣性などの物理法則を生成ロジックに組み込み、映像の変形や動きを現実世界に即したものに。
インテリジェントな長さ計画:固定された時間枠を機械的に埋めるのではなく、イベントの論理と物語のテンポに応じて動画の長さを自動決定。
映像と音声の一体化:テキスト、動画、音声信号を統合的にモデリングし、リップシンク、効果音、映像をネイティブに同期。
物語と人物の一貫性:計画、共同生成、Rewardアライメントのプロセスを採用し、長回しの物語の連続性と人物の一貫性を維持。
03HiDream-O1-Video-1.0の技術原理
ネイティブな全モダリティ統合アーキテクチャ:HD-V1は智象が独自開発したネイティブな全モダリティアーキテクチャを採用しています。設計当初からテキスト、動画、音声の統一表現を前提とし、3つを同一の生成プロセスで共同モデリングし、相互に制約・整合させます。映像の動きが音声のリズムを導き、セリフや効果音がショットの感情を反映し、テキスト条件が全体を通して機能します。
マルチモーダル意図理解モジュール:モデルはまずマルチモーダル理解モデルを用いてユーザー入力を深く理解し、構造化された計画に変換します。口語的で曖昧な自然言語を、ショットの長さ、シーンの場所、登場人物、動作や表情、ショットサイズと構図、カメラワークや焦点距離、セリフ、背景音などの専門的な項目へ変換します。理解が深いほど計画は安定し、計画が安定するほど、その後の共同生成で意図から逸脱しにくくなります。これにより、意図の読み落とし、ショット間の不自然な断絶、人物のぶれを根本から防ぎます。
物理法則を内在化した生成ロジック:物体が重力によってどのように落下するか、衝突にどのように反応するか、慣性がどのように持続するか、光と影がどのように減衰するか、空間の連続性をどのように維持するかを考慮します。
計画・生成・整合の3段階生成プロセス:智象は、まず計画し、次に共同生成を行い、その後マルチモーダルRewardによって整合させる技術的アプローチを提案しています。モデルはまず全体レベルで物語とキャラクターの状態を計画し、共同生成の段階で映像、動作、意味を制約します。そしてマルチモーダルな報酬信号によって画質、整合性、物理的妥当性を統一的に整合させ、長回しの中で人物、感情、動機が互いに影響し合う際の全体的な一貫性を保証します。
04HiDream-O1-Video-1.0の使い方
公開状況を確認:現在、このモデルはクローズドベータ段階にあり、まだ全面公開されていません。先行体験資格の申請が必要ですhttps://n1y46cmwsp.feishu.cn/share/base/form/shrcnVBeO99NQQWARxNirglcbct。
QRコードを読み取って申請フォームに記入:長押ししてQRコードをスキャンし、申請フォームのページにアクセスします。
申請情報を送信:フォームの指示に従って個人情報または企業情報と利用目的を入力し、送信後に公式の審査を待ちます。
開通通知を待つ:審査に合格すると、クローズドベータの体験資格が付与されます。
モデルの機能を体験:資格取得後、公式が提供する入口からテキスト、画像、または動画を入力すると、5~20秒の1080p映像と音声が一体化した動画をワンクリックで生成できます。
05HiDream-O1-Video-1.0の主な強み
ネイティブな全モーダルアーキテクチャ:テキスト、動画、音声信号を共同モデリングする業界初の動画モデルであり、映像と音声を本質的に一体化して生成します。
物理法則に基づく生成:重力、衝突、慣性、光と影の減衰、空間的連続性などの物理法則をモデルが真に理解し、生成ロジックに組み込んでいます。映像の変形、動きへの反応、効果音はすべて現実の因果関係に即しています。
深い意図理解:前段のマルチモーダル意図理解モジュールにより、口語的で断片的なユーザー入力を、ショットの長さ、画角と構図、カメラワーク、動作や表情、セリフ、効果音などを含む専門的なプランへ構造化します。これにより、意図の読み落としやショット間の不自然な飛躍を根本から防ぎます。
物語に合わせた尺:従来の「固定長のウィンドウに内容を詰め込む」ロジックを打ち破り、イベントの展開と物語のテンポに基づいてモデルが尺を自律的に計画します。動作完了後の無意味な待機や、尺を埋めるためのスローモーションを防ぎます。
物語の一貫性と人物の整合性:先に計画し、次に共同生成し、その後マルチモーダルRewardで評価する技術パスを採用しています。Diffusion RLと人間の認知にアラインメントしたRewardモデルを組み合わせることで、連続するショットにおける人物、感情、動機の整合性を保ち、ぶれを防ぎます。
06HiDream-O1-Video-1.0の活用シーン
広告・マーケティング動画:音声と映像が一体化した1080pの商品動画を直接生成し、後付けのナレーション費用を削減。物理的にリアルな質感表現で、高品質な商品紹介に対応します。
ショート動画/SNSコンテンツ制作:5–20秒の可変長がショート動画のテンポに自然にマッチし、口語的なプロンプトだけで効果音やリップシンク付きの完成動画を生成できます。
映像制作のプリビズ・絵コンテ(Previs):ショット構成、画角、カメラワーク、効果音を構造化して計画し、撮影前に演出のテンポや映像の実現可能性を迅速に検証できます。
EC商品紹介動画:商品画像を入力するだけで使用シーンの動画を生成。物体の物理的な動きをリアルに再現し、効果音との同期によってコンバージョン率を高めます。
教育・教養コンテンツ:断片的な知識を、物理法則に忠実な動的デモンストレーションへ変換。音声と映像の同期により、理解のハードルを下げます。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0