
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-11-04
01EvaOmniとは
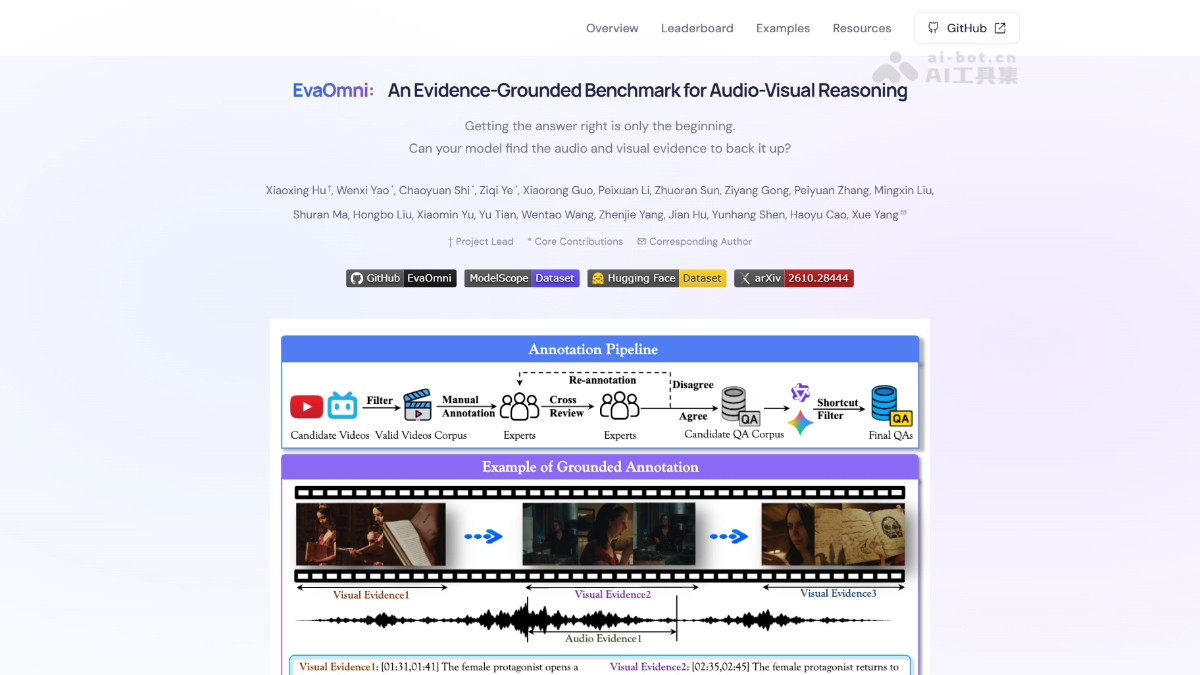
EvaOmniは、上海交通大学、復旦大学、Tencent YouTuなどがオープンソースで公開する全モーダル大規模モデル評価ベンチマークで、実際の動画392本、専門家が注釈を付けた1,027問のQ&Aを収録し、15種類の能力と3段階の推論レベルをカバーします。EvaOmniでは、回答だけでなく音声・動画の証拠時間区間も同時に提示する必要があり、回答精度、証拠カバレッジ、両モーダル定位の3指標で評価します。EvaOmniの実測では、24モデル中で最も強いGemini3.7-Flashの精度は79.4%でしたが、両モーダル定位はわずか35.1%で、人間の専門家の94.3%を59.2ポイント下回りました。これは、正解できても根拠を示せないという弱点を浮き彫りにしています。
02EvaOmniの主な機能
回答評価:視聴覚選択問題に対するモデルの回答が正しいかを判定し、精度Acc.を算出します。
証拠の注釈付けと返却:各問題について、回答を裏付ける音声・動画の時間区間を人手で注釈し、モデルは回答とともに両モーダルの証拠区間を返す必要があります。
証拠カバレッジ評価(C.G.):人手で注釈された証拠区間が、モデルの予測区間に含まれる割合を集計し、モデルがどれだけ多くの手掛かりを見つけたかを測定します。
両モーダルのボトルネック定位(B.G.):音声と動画をそれぞれ評価して時系列IoUを算出し、弱い方のモーダルでスコアを決定します。両モーダルで同時に正確な定位が求められます。
3段階の能力レベル:検索・定位、基礎理解、複雑推論にタスクを分類し、単一点のアライメントから多段推論まで、モデルの能力の広がりを検証します。
ショートカット除去:テキスト、音声、視覚の単一モーダル入力で問題をスクリーニングし、単一モーダルや文字情報の常識だけで正解できるサンプルを除外します。
モデルの横断評価:24の全モーダルモデルに共通のベンチマークとランキングを提供し、オープンウェイトモデルと独自モデルの比較・選定を支援します。
03EvaOmniの技術原理
WeChatで「開源」と返信すると、AIオープンソースプロジェクト交流グループに参加できます。
証拠認識型の注釈データ構造:EvaOmniでは、各問題に音声証拠区間と動画証拠区間を同時に注釈し、動画内容に基づいて設計した誤答選択肢のセットも付与します。そのため、モデルの出力は「選択肢、音声タイムスタンプ集合、動画タイムスタンプ集合」の3つ組として定義され、評価プログラムは回答の正確性と証拠定位の品質を個別に検証できます。
4段階のデータ構築パイプライン:データ生成は、動画選別、人手注釈、相互レビュー、ショートカット除去の4段階で行われます。まず、ハードコード字幕や画面の大部分を覆う文字を含む動画を除外し、視聴覚の手掛かりが実際に有効であることを保証します。次に、専門家が問題を作成し、動画内容に紐づく誤答選択肢を設計して、両モーダルの証拠区間を注釈します。その後、別の注釈者が能力分類、証拠品質、ショートカットの問題を相互レビューし、意見が分かれるサンプルは追加の専門家2名が独立して再確認します。最後に、テキストのみ、音声のみ、視覚のみの3種類の単一モーダル入力でモデルに回答させ、単一モーダルで正解できる問題はすべて修正・再注釈します。これにより、データ段階で「視聴覚の共同推論を回避する」ショートカットを遮断します。
カバレッジと定位による二指標評価体系:証拠カバレッジスコアC.G.は、人手で注釈された各証拠区間が、いずれかの予測区間と正の長さで重複しているかを集計し、見つけられたかを測定します。ボトルネック定位スコアB.G.は、各モーダル内で予測区間全体と注釈区間全体をそれぞれ統合し、時系列の交差・和集合比IoUで重複度を算出します。最終スコアは音声と動画の2つのIoUのうち弱い方を採用します。両指標は回答の正解スコアを乗算するため、誤答は0点です。この設計により、広い予測ではカバレッジスコアしか得られず、正確な境界だけが定位スコアに貢献します。また「弱いモーダル」でスコアを決めることで、強いモーダルで弱いモーダルを補う行為を防ぎます。
3段階の能力レベル設計:データセットは、推論と証拠の複雑度に応じて3つのレベルに編成されています。Level 1の検索・定位では、音声と動画の間で時間、イベント、エンティティを対応付ける能力を検証します。Level 2の基礎理解では、相補的な視聴覚の手掛かりを統合し、イベント、感情、意図を理解することを求めます。Level 3の複雑推論では、異なる時点に分散した複数の証拠を統合し、多段階の判断を行うことを求めます。レベルが高いほど、1問あたりの証拠数とカバー時間が大幅に増加するため、検索、理解、長距離の多段推論におけるモデルの弱点を具体的なレベルまで特定できます。
04EvaOmniの使い方
ModelScopeクライアントをインストール:pip install -U modelscopeを実行してModelScope SDKをインストールまたはアップグレードします。
データセットをダウンロード:dataset_snapshot_downloadでデータセットID VisionXLab/EvaOmni-Datasetを指定し、データをローカルディレクトリに取得します。
モデル入力を準備:評価プロトコルに従って動画を前処理し、対応する音声コンテンツを用意します。
評価対象モデルを接続:GitHubリポジトリの説明に従って全モーダルモデルを接続し、統一プロンプトで選択肢、音声タイムスタンプ、動画タイムスタンプの3つ組を出力させます。
評価を実行:評価フレームワークを呼び出し、全1,027問のQ&Aを一括推論します。プログラムが回答と区間の一致を自動的に検証します。
結果を確認:Acc.、C.G.、B.G.の3指標と3段階の能力レベル別スコアを確認し、ランキングと比較してモデルの弱点を特定します。
05EvaOmniの主な強み
証拠定位を評価に導入:モデルに音声と動画の証拠時間区間を返させ、偶然の正解と根拠に基づく回答を区別します。
二指標で証拠品質を定量化:証拠カバレッジスコアC.G.で手掛かりを見つけ切れたかを測定し、ボトルネック定位スコアB.G.では時系列IoUの弱いモーダルでスコアを決定することで、強いモーダルによる弱いモーダルの隠蔽を防ぎます。
3段階の能力レベルで詳細に評価:検索・定位、基礎理解、複雑な多段推論へと段階的に進み、異なる推論深度におけるモデルの具体的な弱点を特定できます。
高品質な人手注釈:専門家による問題作成、相互レビュー、意見が分かれたサンプルへの専門家2名による再確認を経ており、自動生成された同種のベンチマークよりデータの信頼性に優れています。
厳格なショートカット除去:テキスト、音声、視覚の3種類の単一モーダル入力で問題をスクリーニングし、視聴覚の共同推論を回避して正解できるサンプルを除外することで、公平な評価を保証します。
実際の能力差を可視化:実測では、最強モデルの回答精度は人間と17ポイントしか差がありませんでしたが、両モーダル定位では59.2ポイントの差があり、現行モデルの本当の弱点を明らかにしています。
06EvaOmniのプロジェクトリンク
プロジェクト公式サイト:https://xiaoxing2001.github.io/EvaOmni.github.io/
GitHubリポジトリ:https://github.com/VisionXLab/EvaOmni
HuggingFaceモデルリポジトリ:https://huggingface.co/datasets/VisionXLab/EvaOmni-Dataset
arXiv技術論文:https://arxiv.org/pdf/2610.28444
07EvaOmniの利用シーン
全モーダルモデルの研究開発・評価:モデルチームはOmni LLMを改良する際、Acc./C.G./B.G.の3指標で「回答は向上したが証拠定位が追いついていない」能力の断絶を特定し、トレーニングの改善方針を決定できます。
企業向けAIの選定・受入検査:金融、行政など、モデルに「検証可能な根拠の提示」を求める場面で、導入側はB.G.のボトルネック定位スコアによって、真に両モーダルで信頼できるモデルを選別できます。
動画コンテンツの審査と追跡可能性:審査用途では、違反コンテンツが「どの画面、どの音声」に現れたかをモデルが示す必要があります。EvaOmniの時間区間出力と定位指標は、そのまま受入基準として利用できます。
教育・映像コンテンツのQ&A製品:動画付き学習アシスタントや映像解説製品では、元映像の一部を引用して回答する必要があります。このベンチマークで、関連する映像や台詞を正確に定位できるかを評価できます。
学術研究とランキング構築:研究者は、証拠注釈付きのオープンソース動画392本を基に、視聴覚推論、時間定位、多段推論などの研究をさらに進めたり、複数ベンチマークによる統合評価体系に組み込んだりできます。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0