
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-09-08
01LLaDA-Imageとは
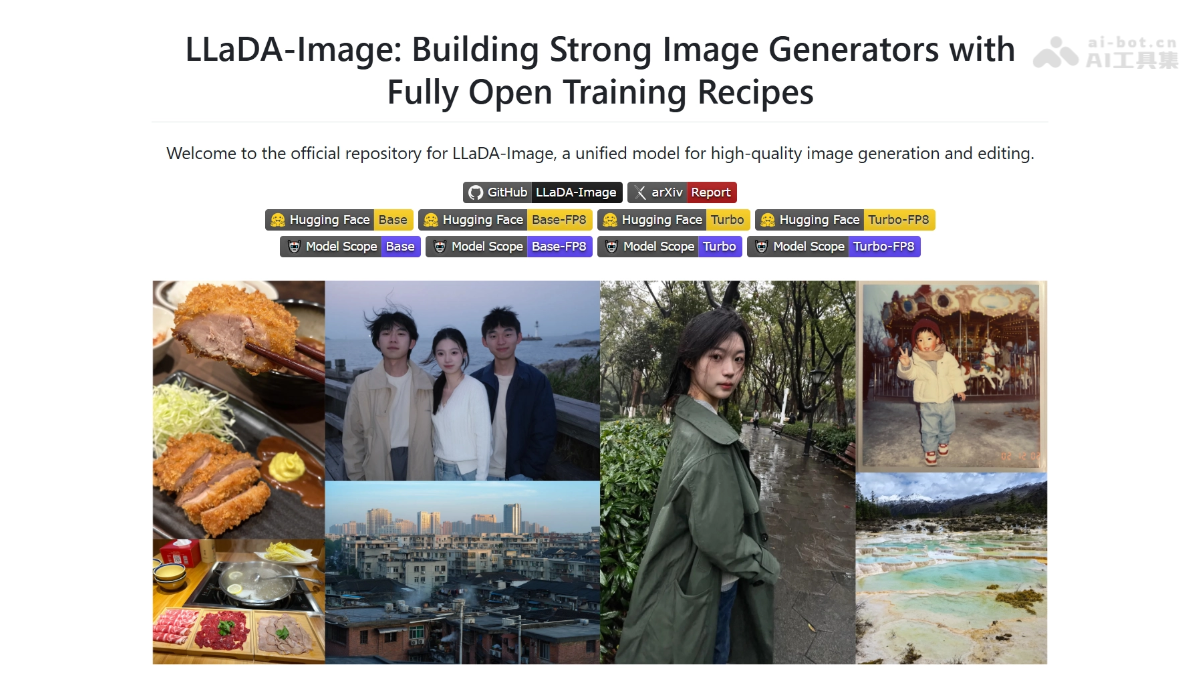
LLaDA-Imageは、アリババグループのinclusionAIがオープンソースとして公開した、60億パラメータの統合画像生成・編集モデルです。純粋な画像による事前学習を行った後に言語アライメントを実施する革新的なアプローチを採用し、全拡散アーキテクチャ(LLaDA2.0-miniによる理解 + 6B DiTによる生成)で、テキストから画像への生成、指示ベースの編集、中国語・英語テキストのレンダリングを実現します。Turbo版はわずか2~4ステップで画像を生成でき、Qwen-Image-Benchの中国語・英語両部門でオープンソースモデル1位を獲得しています。
02LLaDA-Imageの主な機能
テキストから画像への生成:自然言語による説明に基づき、高忠実度で細部まで豊かな写実的画像を生成します。
指示ベースの画像編集:参照画像をアップロードして自然言語の指示を入力すると、指定領域を正確に変更しながら、それ以外の部分を維持します。
中国語・英語のバイリンガル文字レンダリング:生成画像内に中国語と英語のテキストを正確に表示し、ポスター、レイアウト、アート文字のデザインに対応します。
VQ条件付き生成:視覚量子化(VQ)トークンを条件入力として、制御可能な画像生成を実現します。
参照画像編集:アップロードした画像を参照し、スタイル変換や内容変更などの編集を行います。
Turbo高速推論:蒸留版モデルはわずか2~4ステップのサンプリングで、1024×1024の高品質画像を生成します。
03LLaDA-Imageの技術原理
WeChatでフォローして「オープンソース」と返信すると、AIオープンソースプロジェクト交流グループに参加できます。
全拡散統合アーキテクチャ:モデルは、理解モジュールLLaDA2.0-mini(MoEベースの拡散言語モデル)と生成モジュール6B DiTで構成されます。両者のバックエンドは拡散モデルであり、Connectorによって接続することで、意味理解とピクセル生成を分離します。
段階的学習戦略:「まず絵を描けるようにし、次に指示に従えるようにする」という方針を採用しています。まず純粋な画像の事前学習と中間学習で強力な視覚生成事前分布を構築し、その後、ペアになった言語による教師信号を導入してテキストと視覚のアライメントを実現します。
高品質データの構築:生成学習では累計約2.2億サンプルを使用し、その98%が実画像です。言語アライメント段階の画像説明はQwenシリーズの大規模モデルが生成・検証し、指示追従の正確性を確保しています。
効率的な学習最適化:全工程でパラメータ非依存のRMSNormをLayerNormの代わりに使用し、Muonオプティマイザを採用することで、大規模学習の安定性と効率を高めています。
Twin-DMDによる高速蒸留:Turbo版はTwin-DMD蒸留技術によってBaseモデルを圧縮し、2~4ステップのサンプリングで1024×1024の高品質画像を生成し、速度と品質のバランスを実現します。
04LLaDA-Imageの使い方
環境構築:Python 3.11、PyTorch 2.8、Diffusers 0.39.0、FlashAttention 2.8.3などの依存関係をインストールし、ローカル推論環境を構築します。
モデルの取得:Hugging FaceまたはModelScopeから、LLaDA-Image(高忠実度版)またはLLaDA-Image-Turbo(高速版)のモデルファイルをダウンロードします。
テキストから画像を生成:モデルを読み込んだ後に説明文を入力します。Base版は50ステップ、guidance scale 5.0、Turbo版は2~4ステップ、guidance scale 1.0に設定し、1024×1024の画像を生成します。
指示による画像編集:参照画像をアップロードし、自然言語の編集指示(例:「背景を海辺に変更」)を入力すると、モデルが未編集領域を自動的に維持します。
サイズに関する注意:テキストから画像への生成とVQ条件付き生成の入力サイズは16の倍数、編集タスクでは32の倍数にする必要があります。
05LLaDA-Imageの主な強み
オープンソース性能で先行:中国語・英語のQwen-Image-Bench両部門でオープンソースモデル1位を獲得し、FLUX.2 Maxなど主要なオープンソースモデルを総合スコアで上回っています。
生成と編集を統合:単一モデルで高品質なテキストから画像への生成と精密な指示ベースの画像編集に対応し、モデルを切り替える必要がありません。
超高速推論:Turbo蒸留版はわずか2~4ステップのサンプリングで1024×1024の高忠実度画像を生成し、待ち時間を大幅に短縮します。
中国語・英語の文字レンダリング:優れた中国語・英語テキスト生成能力を備え、ポスター、レイアウト、アート文字などのデザインタスクに対応できます。
写実的な表現:98%が実画像である事前学習データに基づき、自然な照明、豊かなディテール、高いリアリティを備えた生成結果を実現します。
06LLaDA-Imageのプロジェクトページ
GitHubリポジトリ:https://github.com/inclusionAI/LLaDA-Image
Hugging Faceモデルコレクション:https://huggingface.co/collections/inclusionAI/llada-image
arXiv技術論文:https://arxiv.org/pdf/2609.03796
07LLaDA-Imageの利用シーン
ECビジュアルデザイン:商品の説明から商品メイン画像をワンクリックで生成したり、指示によって背景や光の当たり方をすばやく変更したりでき、撮影・後処理のコストを削減します。
マーケティングポスター制作:優れた中国語・英語文字レンダリング機能により、ブランドのSloganやイベント情報を含む商用ポスター、ソーシャルメディア用画像を直接生成できます。
ソーシャルメディアコンテンツ制作:ブロガーやクリエイターに、写実的な人物、風景、ライフスタイル画像の生成機能を提供し、スタイル編集と高速生成に対応します。
ゲーム・映像コンセプトデザイン:テキストからキャラクターやシーンのコンセプト画像をすばやく作成し、指示で細部を繰り返し変更できるため、初期のクリエイティブ工程を加速します。
個人向け写真レタッチ:写真をアップロードし、自然言語の指示で不要物の除去、空の変更、色調調整などを行えます。未編集領域を維持できるため、複雑な画像編集ソフトの代わりになります。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0