
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-10-16
01FLUX 3 Image Kleinとは
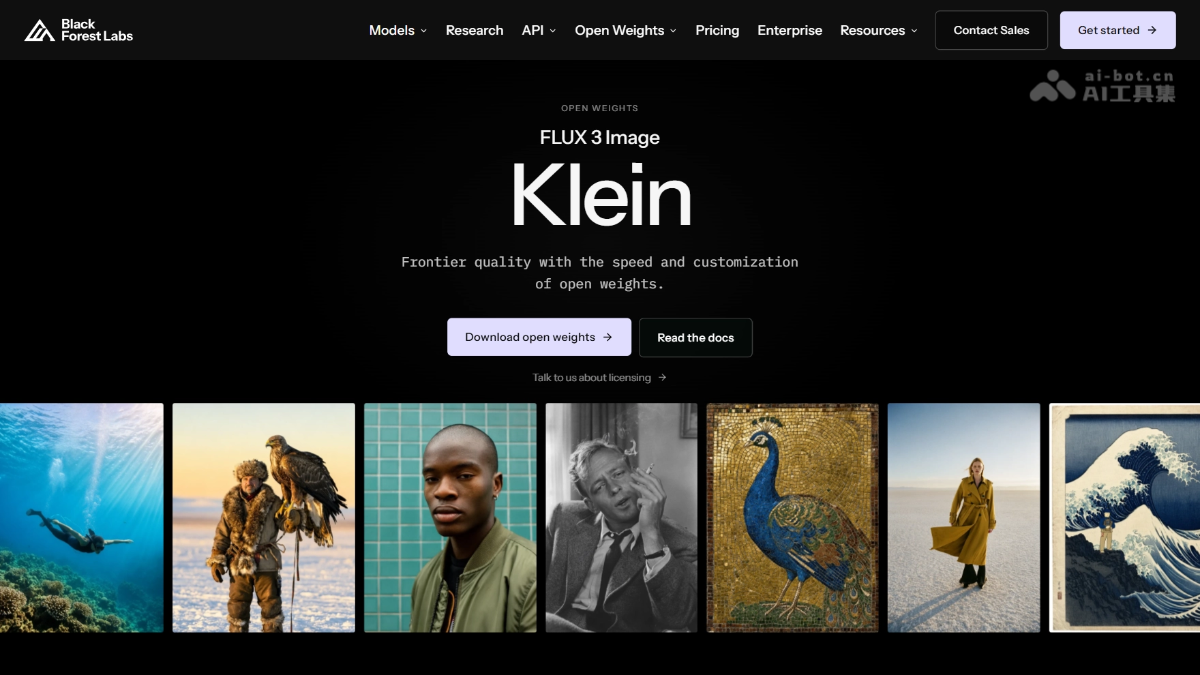
FLUX 3 Image Kleinは、Black Forest Labsがオープンソースで公開するAI画像生成モデルです。わずか5.6Bパラメータで、一般向けGPU 1枚で実行できます。FLUX 3 Image Kleinは、テキストからの画像生成、指示による画像編集、最大10枚の参照画像を使った複数画像生成に対応し、ネイティブ4K出力、ピクセル単位の高精度編集、座標ボックスによるレイアウト制御を実現します。公式の社内ブラインドテストでは、中国語画像生成、編集、複数参照の3項目すべてで1位となり、Qwen-Image 2.1とKrea 2を上回りました。
02FLUX 3 Image Kleinの主な機能
テキストからの画像生成:最大ネイティブ4K解像度の高品質な画像生成に対応。
指示による画像編集:自然言語で画像の任意の部分を変更でき、指定していない領域のピクセルはそのまま保持。
複数参照画像による生成:1回の処理で最大10枚の参照画像を受け付け、キャラクター、スタイル、製品の一貫性を維持。
座標ボックスによるレイアウト制御:0〜1000のグリッド座標ボックスで要素の位置を正確に指定したり、編集範囲を限定したりできます。
統一重みアーキテクチャ:生成、編集、複数参照のタスクで同じ5.6Bパラメータの重みを共有し、モデルを切り替える必要がありません。
一般向けハードウェアで実行可能:INT8量子化版はVRAM 8GBのGPUで動作し、蒸留版は4ステップで画像を生成。
微調整エコシステム:公開重みにはLoRAトレーニングのサポートが付属し、スタイル、ブランド、ワークフローをカスタマイズできます。
03FLUX 3 Image Kleinの技術原理
WeChatでフォローして「開源」と返信すると、AIオープンソースプロジェクトの交流グループに参加できます。
Rectified Flow生成方式:従来の拡散モデルがノイズから画像への曲がりくねった確率的経路を学習するのに対し、FLUXファミリーはノイズとデータを結ぶ近似的な直線経路を学習し、確率微分方程式ではなく常微分方程式を解いてサンプリングします。経路が直線に近いほど必要な積分ステップ数は少なくなるため、蒸留版では16ステップ、4ステップ相当のサンプリングだけで高品質な結果を得られます。
MMDiTデュアルストリームTransformerバックボーン:モデルはマルチモーダル拡散Transformerを中核とし、画像トークンとテキストトークンを前段のデュアルストリームブロックで共同処理します。共有アテンションを通じて情報を交換し、その後シングルストリームブロックで統合的に精錬することで、各層でテキスト指示と視覚生成を深く結び付けます。これが、複雑なプロンプトへの追従能力と文字レンダリング能力を支える構造的基盤です。
独立したテキストエンコーダー構成:5.6Bパラメータは画像生成の主幹部分のみを指し、テキスト理解は外付けのQwen3-VL-4B-Instructエンコーダーが担います。両者を分離することで、意味理解能力と生成バックボーンを独立してアップグレードできます。つまり、実際の導入時にはエンコーダーのメモリ使用量もVRAM消費に含める必要があります。
マルチモーダル共同学習の移転:KleinはFLUX 3の大規模モデルで得られた事前学習成果を直接継承し、画像、動画、音声の3モダリティで共同学習されています。異なるモダリティが相互に制約し合う仕組みにより、小規模モデルでもパラメータ数を超える視覚理解能力を獲得しています。
04FLUX 3 Image Kleinの使い方
ハードウェアを確認:蒸留版BF16には11.2GBのVRAMが必要です。8GB GPUではINT8/FP8量子化版を選択してください。FP8版の容量はわずか5.6GBです。
重みをダウンロード:Hugging Faceのblack-forest-labs/FLUX.3-Kleinリポジトリから必要な精度の重みを取得し、対応するQwen3-VL-4Bテキストエンコーダーもダウンロードします。
ライセンスに同意:「Agree and access repository」をクリックしてFLUX Kommunity Licenseに同意すると、ダウンロードできるようになります。商用利用の前に、年間売上が500万米ドルの基準を下回っているか確認してください。
導入方法を選択:ComfyUIではManagerからBFL公式プラグインをインストールし、ノードグラフでKleinモデルを選択します。またはDiffusersを使い、数行のPythonコードで読み込めます。
プロンプトを作成:通常のテキストからの画像生成では説明を直接入力します。複雑なレイアウトには、公式のPrompt Upsamplerを有効にしてプロンプトを自動最適化することをおすすめします。
座標ボックスでレイアウトを制御:プロンプト内で文字や主体などの要素に[y_min, x_min, y_max, x_max]の座標ボックスを指定すると、モデルがグリッドに従って要素を正確に配置します。
画像編集:元画像をアップロードし、「この通りを雪景色に変えて」のように自然言語で変更内容を指示します。指定していない領域のピクセルはそのまま保持されます。
複数参照画像による生成:APIまたはUIで最大10枚の参照画像と説明文をアップロードすると、参照対象の一貫性を保ちながら新しい画像を生成できます。
パラメータを調整して生成:蒸留版はCFGなしでそのまま使用できます。Base版はCFG 3.5、50ステップを推奨します。VRAMが不足する場合は解像度を下げるか、量子化を有効にしてください。
05FLUX 3 Image Kleinの主な強み
パラメータ効率:わずか5.6Bパラメータで、公式ブラインドテストにおいて7BのQwen-Image 2.1と12.9BのKrea 2を上回り、クローズドソースのIdeogram V4.5にも勝利。
低いハードウェア要件:INT8量子化版はVRAM 8GBの一般的なコンシューマー向けGPUで動作し、同クラスの最先端機能を持つオープンソースモデルの中でも導入コストが最低水準です。
3タスクを1つの重みで処理:テキストからの画像生成、画像編集、複数参照画像生成で同じ重みを共有し、タスクごとにモデルを切り替えたり組み合わせたりする必要がありません。
レイアウト制御能力:座標ボックスで要素の位置を正確に制御できます。これまでは大規模なクローズドモデルでしか見られなかった機能で、オープンソース陣営には同等の競合がありません。
ピクセル単位の編集忠実度:編集時に指定していない領域のピクセルを完全に保持するため、ECやデザインなど元画像を損なえない用途に適しています。
ネイティブ4K出力:超解像処理を経ずに4K解像度で直接生成でき、二次処理による画質劣化を省けます。
06FLUX 3 Image KleinのプロジェクトURL
公式サイト:https://bfl.ai/models/flux-3-image-klein
Hugging Faceモデル: https://huggingface.co/collections/black-forest-labs/flux-3-image-klein
07FLUX 3 Image Kleinの活用シーン
越境ECの商品メイン画像を一括作成:10枚の参照画像をアップロードし、座標ボックスで製品、訴求点、価格タグの位置を指定して、多言語版の4K商品メイン画像を一度に生成。
EC商品の季節変更編集:既存の商品画像に「この通りを雪景色に変えて」と入力すると、背景全体を変えながら商品本体のピクセルを一点ずつ保持し、レタッチなしで冬季版を作成。
ポスターやバナーの高速レイアウト:0〜1000のグリッド座標ボックス内でタイトル、ロゴ、メイン画像の位置を1つずつ指定し、文字がずれないイベントポスターを直接生成。
書籍・雑誌の表紙デザイン:座標ボックスで書名とイラストの相対位置を固定し、ネイティブ4K出力で印刷解像度に直接対応。レイアウトソフトによる二次調整を省けます。
ブランドLoRAのカスタマイズ:自社製品画像でLoRAを学習させると、その後の生成画像でブランドカラー、フォント、製品外観を自動的に統一し、スタイルの揃ったSNS用素材を一括作成。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0