

AnyJevの機能
AnyJevは、オープンな言語モデルをJev形式の意思決定モデルに変換します。モデルに回答を生成させてテキストを解析する代わりに、AnyJevはprefillからモデルの次トークン分布を読み取り、確率付きの型付き意思決定を返します。
これは、リクエストのルーティング、アクションが危険かどうかの推定、タスク完了度のスコアリングなどのワークフローに役立ちます。各結果には使用した意思決定レベルが記録されるため、後続のコードで、未キャリブレーションまたはゼロラベルの結果と、学習済みヘッドによる結果を区別できます。
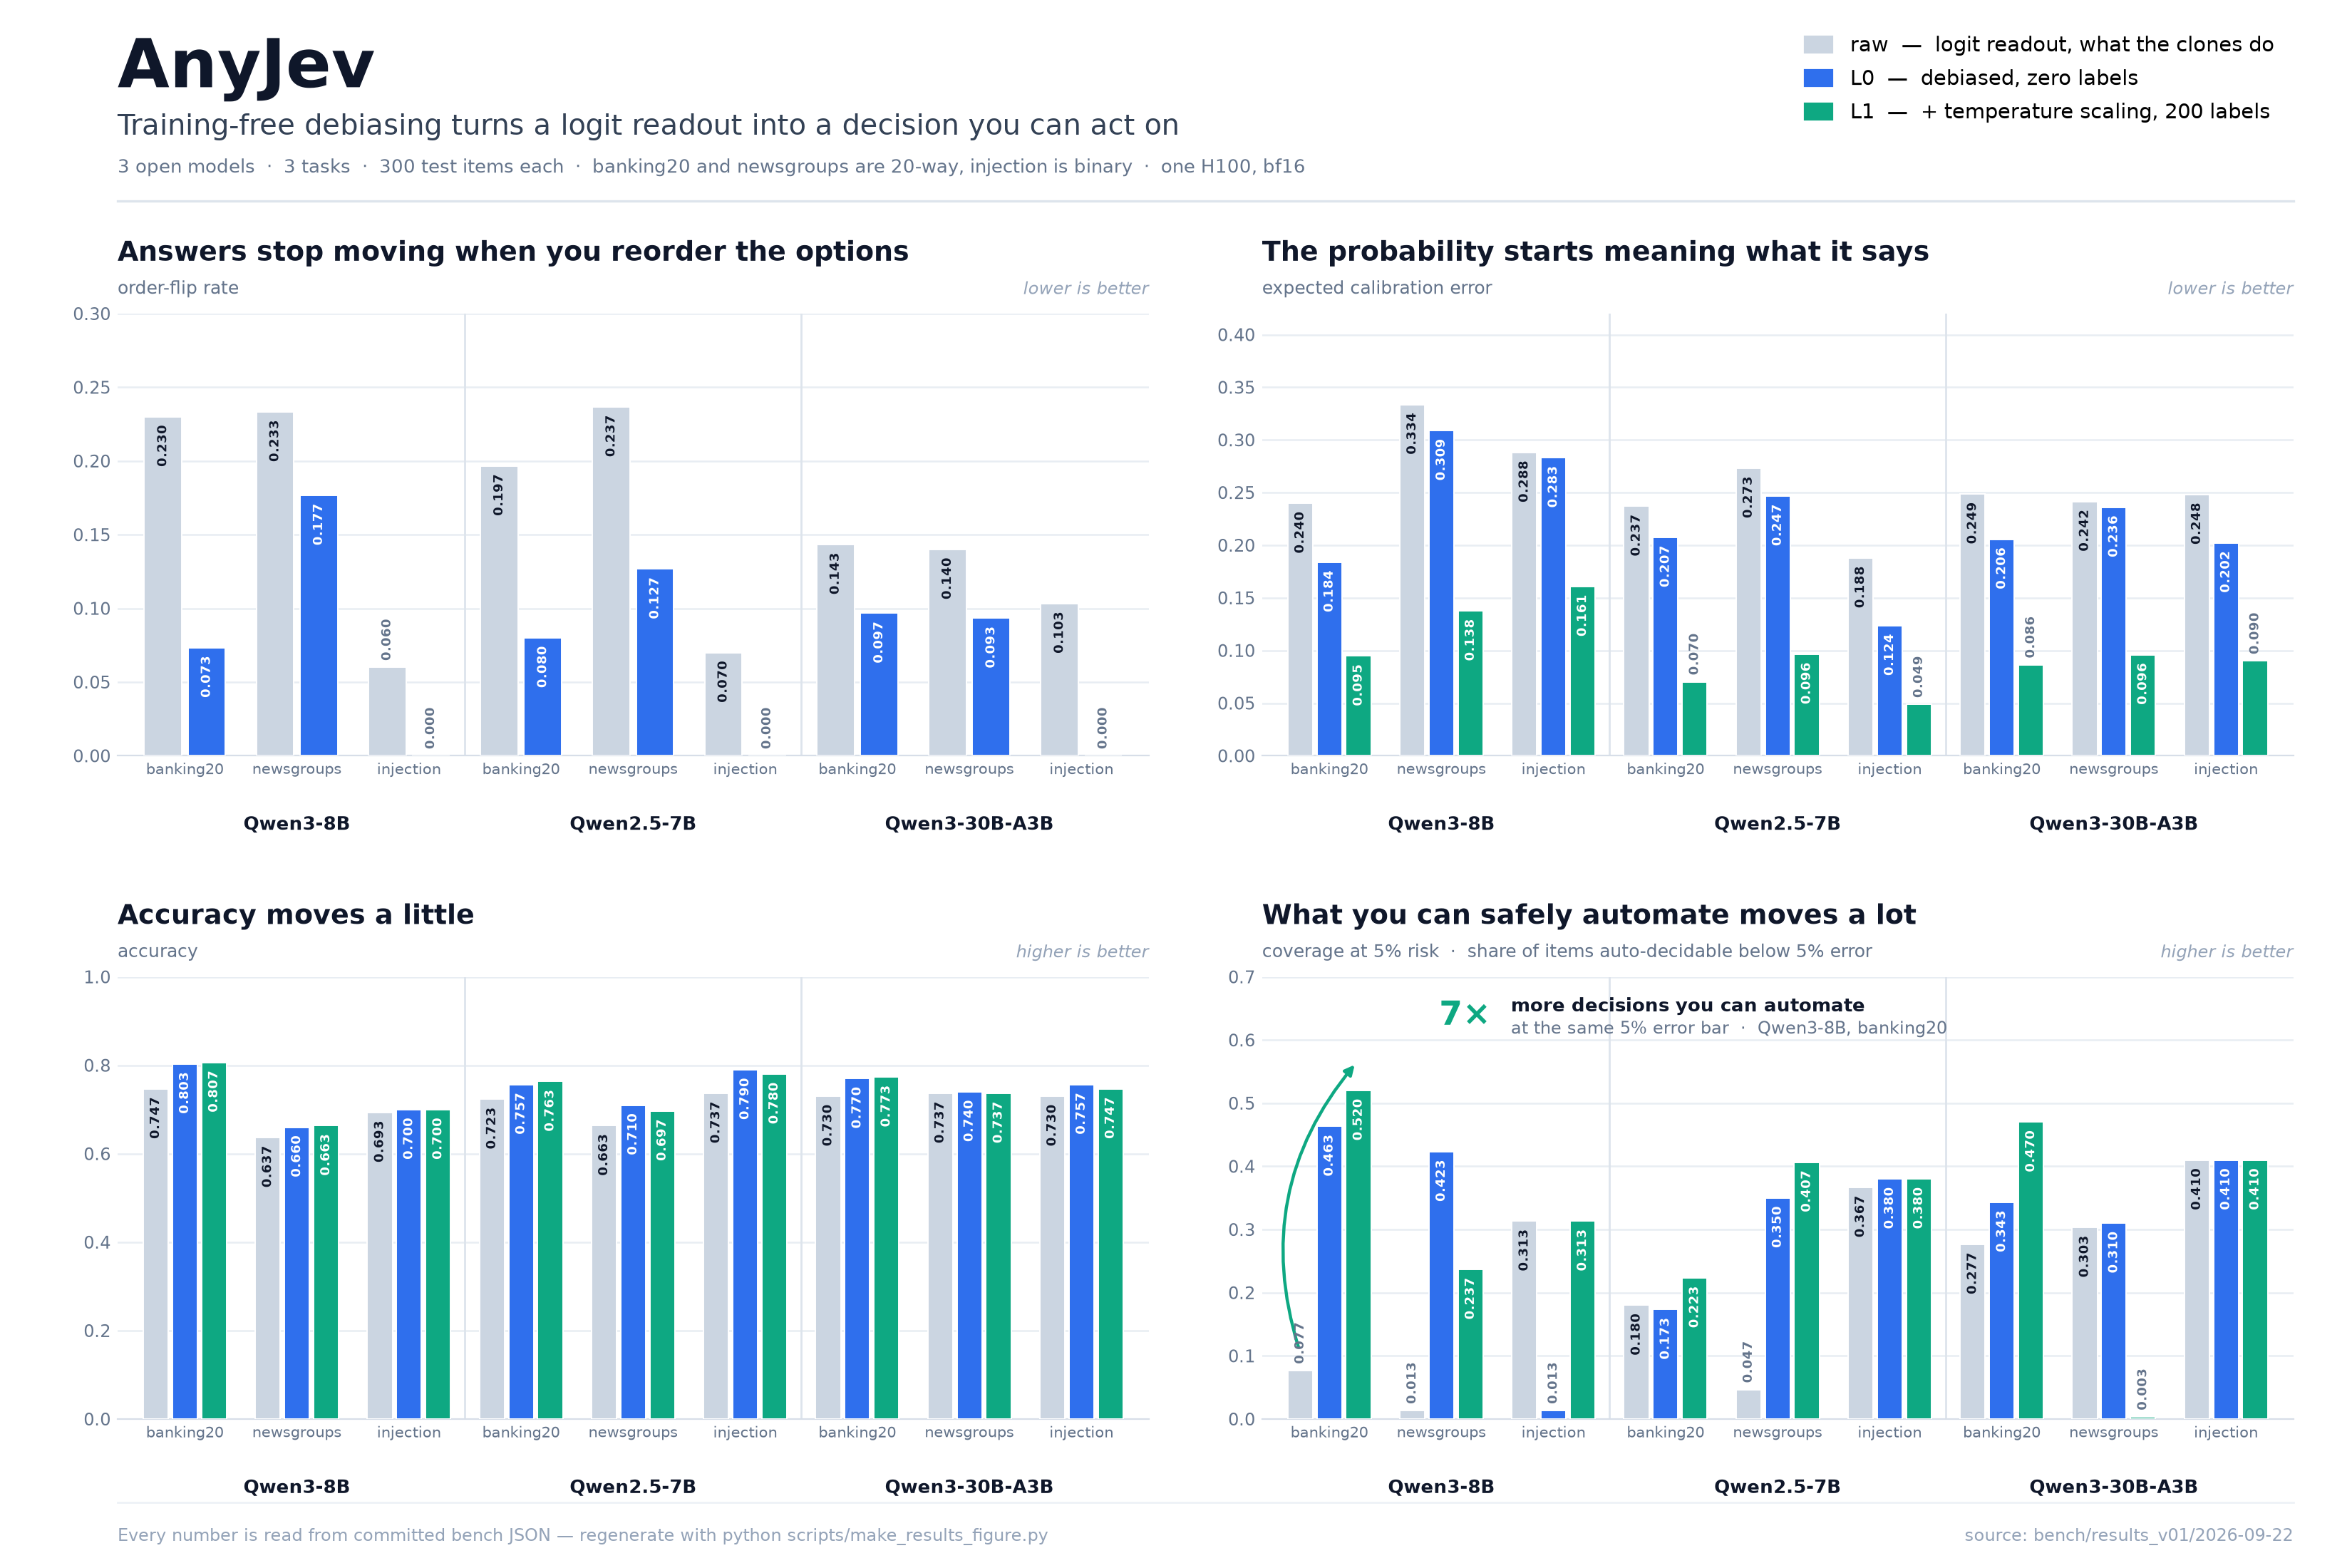
AnyJevは、生のロジットに関する2つの実用上の問題に対処します。オプションの順序を変えると予測が変わる可能性があること、また、しきい値ベースの自動化に十分なほど生の信頼度が適切にキャリブレーションされていない可能性があることです。READMEのQwen3-8B BANKING77実験では、ラベルなしでL0を使用すると、オプション順序による反転率が0.230から0.073に低下しました。ラベル付きの例を使用したL1では、期待キャリブレーション誤差が0.240から0.095に低下しました。
意思決定レベル
AnyJevは、必要なデータとサービング要件が異なる複数のレベルを提供します。
- raw: ラベルのトークンに対して制限付きsoftmaxを適用します。位置バイアスの補正や信頼度のキャリブレーションは行いません。
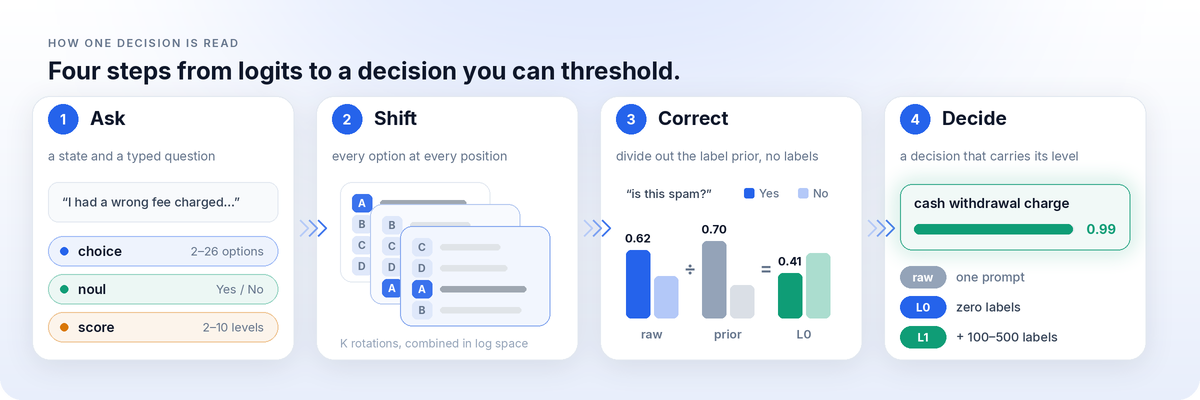
- L0: ラベルは不要です。オプションを循環的に入れ替えて評価し、位置バイアスを平均化するとともに、推定したラベル事前分布を除去します。
- L1: 質問ごとに約100~500個のラベルを使用して、L0上で温度スケーリングを適合させます。キャリブレーションを改善しますが、順位は変えません。
- L2: 質問ごとに約100~300個のラベルを使用し、中間隠れ状態から縮小LDAまたはリッジヘッドを解きます。ローカルモデルが必要で、モデルと質問の両方に固有です。
複数オプションの選択でL0を使用する場合、ローテーションを評価するために複数回のprefillが必要です。一方L2は、1つのプロンプトを使用して固定された中間ブロックで停止するため、報告されたQwen3実験では完全なフォワードパスより低コストです。
主な機能
- 型付きの
choice、noul、score質問。 - テキスト生成や回答解析が不要。
- オプション位置とラベル事前分布の影響を補正する、ゼロラベルのL0補正。
- 数百個のラベルによるL1温度キャリブレーション。
- 勾配やモデルのファインチューニングなしで数秒で適合できる、L2の閉形式ヘッド。
level="auto"によるL2、L1、L0の自動選択。observeによるラベルの段階的な収集。- 多数の状態と1つの質問に対するバッチ意思決定。
- 後でサービング用に保存・読み込みできる小さなJSONアーティファクト。
インストールとセットアップ
Hugging Faceバックエンドをインストールする
Hugging Face統合付きでAnyJevをインストールします。
pip install "anyjev[hf]"現行リリースでは、Transformersベースのanyjev.backends.hfバックエンドを通じて、すべての意思決定レベルを提供します。vLLMとSGLangのサポートはロードマップ上にあり、このリリースでは利用できません。
決定器を作成する
コアAPIをインポートし、オープンモデルでHFBackendを初期化します。
from anyjev import Decider, Question
from anyjev.backends.hf import HFBackend

decider = Decider(HFBackend("Qwen/Qwen3-8B"))
同梱されているL2ヘッドは、5つのQwen3モデル、1.7B、4B、8B、30B-A3B、32Bを対象としています。L2ヘッドはベースモデルと質問に固有であるため、あるモデルまたは質問用に適合したヘッドを別のモデルや質問に自動的に再利用することはできません。
型付き質問を定義する
質問は、出力タイプ、有効な回答、安定した名前を記述します。同じアプリケーション状態に対して、複数の質問タイプを評価できます。
route = Question.choice(
    "Which team should handle this?",
    ["billing", "technical", "sales", "other"],
    name="route",
)

risky = Question.noul(
    "Is this tool call destructive or irreversible?",
    name="risky",
)

done = Question.score(
    "How complete is the task?",
    bins=5,
    name="done",
)カテゴリカルな意思決定にはchoice、真偽の意思決定にはnoul、区分化した数値スコアにはscoreを使用します。文字トークンの読み出しが現在サポートするオプション数は最大26個です。
基本的なL0意思決定を行う
L0はデフォルトで、ラベル付きの例を必要としません。質問に必要な情報を含む状態を構築し、decideを呼び出します。
state = {
    "conversation": [
        {"role": "user", "content": "I was charged twice."}
    ],
    "tool_call": {
        "name": "refund_payment",
        "arguments": {"payment_id": "pay_123"},
    },
}

result = decider.decide(state, [route, risky, done])

print(result["route"].distribution)
print(result["risky"].p_true)
print(result["done"].value)
print(result.level)代表的なルート分布では、指定した各オプションを確率に対応付けます。ブール値の意思決定ではp_true、スコアの意思決定ではvalueを参照できます。上位レベルのアーティファクトがない場合、全体の結果はL0を報告します。
確率は、そのレベルに応じて解釈してください。L0は安定性を向上させ、推定されたラベルバイアスを補正しますが、不確実性を完全にキャリブレーションするものではありません。
L1キャリブレーションを追加する
質問について約100~500個のラベル付き状態がある場合は、calibrateを呼び出してL1温度を適合させます。
decider.calibrate(risky, states, labels)L1は、L0の上に生成された確率をキャリブレーションします。最も高い順位の回答は変えませんが、信頼度のしきい値をより意味のあるものにできます。
L2の閉形式ヘッドを適合させる
より高い精度を得るには、約100~300件のラベル付き例を使って、質問ごとのL2ヘッドを適合させます:
decider.fit_head(route, states, labels)

decider.save_artifacts("qwen3-8b.json")
適合処理では、まず例を対象にモデルを1回実行し、その後、閉形式でヘッドを解きます。勾配は使用せず、言語モデルの重みも変更しません。プロジェクトによると、ヘッドのサイズは通常約100 KBで、サポート対象の小型Qwen3モデルでは数秒で解けます。
保存したアーティファクトを後続のプロセスで読み込み、自動レベル選択を要求します:
decider.load_artifacts("qwen3-8b.json")

result = decider.decide(state, [route], level="auto")
print(result["route"].level)level="auto"を指定すると、質問を振り分けられる互換性のあるヘッドがある場合、AnyJevはL2を使用します。それ以外の場合は、キャリブレーションが利用可能ならL1にフォールバックし、次にL0へフォールバックします。
ラベルを段階的に収集する
AnyJevは、レビューキュー、観測された結果、または別のフィードバックソースからラベルが届くたびに受け取れます:
decider.observe(route, state, correct_label)プロジェクトの自動ループは、30件の観測でヘッドを解き、その後60件、120件、およびそれ以降の各マイルストーンで再解決します。これにより、新しい質問をL0で開始し、十分なフィードバックが蓄積された後にL2へ移行するデプロイライフサイクルを実現できます。
バッチ推論
1つの質問を多数の状態に適用する場合は、decideを繰り返し呼び出すのではなく、バッチAPIを使用します:
results = decider.decide_batch(states, route)これは、1つの型付き質問に対して多数の入力を処理するための想定インターフェースです。
パッケージ化されたデモを試す
リポジトリをチェックアウトした状態で、モデルをダウンロードせずに合成デモを実行します:
python -m demo.jev_mode --backend fakeデプロイライフサイクルをシミュレートするには、ライフサイクルオプションを追加します:
python -m demo.jev_mode --backend fake --lifecycle--backend fakeを削除すると、同梱されたヘッドを使って実際のQwen3デモを実行できます。
高度なデプロイのヒント
質問の識別性を維持する
L2は質問とモデルごとに適合されます。新しい選択肢のセットには、新しいラベルと新しいヘッドが必要です。同じ質問の言い換えや、同じ選択肢の順序変更は、既存のヘッドに振り分けられる可能性があります。
ラベルなしトラフィックで表現の適応を行う
言い換えた質問に対して、AnyJevは約30件のラベルなしリクエストを使って、ヘッドの特徴量平均とスケールを再センタリングできます。この適応は質問の表現と選択肢の順序に適用されますが、アプリケーションの状態自体の変化は検出しません。
実データのドリフトを監視する
状態分布の変化は再センタリング機構から見えないため、定期的にラベル付けする評価データの一部を保持し、性能を抜き打ち確認してください。表現の適応を、本番監視の代替として扱わないでください。
判断レベルでアクションを制御する
すべての判断にはレベルが付与されます。下流システムは機密性の高いアクションを実行する前にそのレベルを検査でき、プロジェクトではrequire=によるレベルの強制もサポートしています。これにより、キャリブレーション済みまたはL2の判断を前提に設計されたワークフローが、フォールバック結果に対して黙って動作することを防げます。
検証後にのみしきい値を選択する
キャリブレーションの主な利点は、高信頼度のケースを自動化に回し、不確実なケースをエスカレーションできることです。代表性のあるラベル付きデータでしきい値を選択し、表示された確率が自動的に信頼できると仮定するのではなく、結果として得られる誤り率とカバレッジを測定してください。
重要な制限事項
- L2ヘッドは、別の質問やベースモデルには転用できません。
- 現在のプロジェクトリリースに同梱されているのはQwen3用ヘッドのみです。
- L2には隠れ状態へのアクセスが必要で、現在はTransformersバックエンドを通じて提供されています。
- キャリブレーションによって、モデルが本質的に回答できないタスクを解けるようになるわけではありません。
- 1つのラベルがバッチの事前確率を強く支配している場合、L0によって精度が低下する可能性があります。
- 現在の文字読み出しがサポートする選択肢は26個以下です。
- 報告されている5%のリスクカバレッジ推定は300例に基づいているため、分散が大きくなっています。
- 公開されている型付き判断の精度は、教師LLMとの一致度を測定したものであり、独立して確立された正解データとの一致度ではありません。
- 報告された判断は、完全なエージェントループ内ではなく、単独で評価されています。
まとめ
AnyJevは、ラベルなしの型付き判断から、キャリブレーション済み確率と効率的な隠れ状態ヘッドまで、実用的な段階的アプローチを提供します。まずL0から始めて実際のラベルを収集し、キャリブレーションを優先する場合はL1を追加し、質問ごとにより精度の高い判断経路が必要になったらL2を適合させてください。報告されたレベルを保持し、しきい値を検証し、本番データの変化に応じてラベル付きサンプルを監視します。
実装の詳細と現在の計画については、AnyJevリポジトリ、そのレベル契約、ベンチマークのドキュメント、ロードマップを参照してください。