

Jeffとは?
Jeffは、高速なゼロショット分類向けに設計された、コンパクトなQwen3.5およびGemma 4ファインチューニングモデルのファミリーです。自然言語で状況を入力し、利用可能な選択肢を定義すると、1回のフォワードパスで各選択肢の調整済み確率を取得できます。
従来の生成モデルとは異なり、Jeffはアプリケーションで解析する必要がある文章を生成しません。サポートの振り分け、意図検出、モデレーション、音声コマンド、ゲーム内の操作などのタスクで、直接的な判断を行うことを目的としています。選択肢を明確に説明すれば、それらのカテゴリが学習データに登場していなくても使用できます。
JeffはJevと同じリクエスト形式を使用しますが、独立したプロジェクトであり、TypeSafeとは提携も推奨関係もありません。学習コードはオープンソースのAutoJevレシピを基盤としています。
主な機能
- 高速なローカル推論: 報告されたベンチマークでは、Jeff-Qwen3.5-0.8BはRTX PRO 6000で1判断あたり約22 ms、MLXを使用したApple M4 Maxで28 msです。
- 調整済みの出力: 各判断には、確率、選択された選択肢、信頼度が含まれます。
- ゼロショットカテゴリ: 固定ラベルセットに限定されず、リクエスト時に選択肢を説明できます。
- 3種類の質問:
choice、noul、scoreの質問を使用できます。 - リクエストのバッチ処理: 同じ状態に関する複数の独立した質問をまとめて回答できます。
- ローカルバックエンド: NVIDIA GPUまたはCPUではPyTorchを、Appleシリコン上のQwenモデルではMLXを使用して実行できます。
- ドメイン適応: ゼロショット性能が不十分な場合は、Jeffのチェックポイントをファインチューニングできます。
モデルを選ぶ
Jeffには、Hugging Face上で3つのモデルチェックポイントがあります。
- Jeff-Qwen3.5-0.8B: 16ビット重みが1.7 GBの8億パラメータモデルです。高速な選択肢の選定に適した、推奨のバランスモデルです。
- Jeff-Qwen3.5-2B: 16ビット重みが4.2 GBの20億パラメータモデルです。報告されたベンチマークパネルでは全体的に高いスコアを示しますが、より低速で慎重です。
- Jeff-Gemma4-E2B: 有効パラメータ数20億、保存パラメータ数46億、16ビット重み9.3 GBのモデルです。プロジェクトのMLXバックエンドはQwenモデルのみをサポートします。
初回のデプロイでは、Jeff-Qwen3.5-0.8Bから始めてください。別のチェックポイントに移行するのは、アプリケーションの代表的な例で評価してからにしましょう。
Jeffをインストールしてダウンロードする
このリポジトリでは、依存関係の同期とコマンドの実行にuvを使用します。プロジェクトディレクトリから、デフォルトの依存関係をインストールし、0.8Bチェックポイントをダウンロードします。
uv sync
uv run hf download mstrasser/Jeff-Qwen3.5-0.8B --local-dir checkpoints/jeff-0.8bチェックポイントはcheckpoints/jeff-0.8bに配置されます。別の公開モデルを使用する場合は、Hugging Faceのリポジトリとローカルディレクトリを置き換えられます。
PyTorchでサーブする
NVIDIA GPUまたはCPUでは、デフォルトのPyTorchバックエンドでサーバーを起動します。
JEFF_CHECKPOINT=checkpoints/jeff-0.8b PORT=8765 uv run jeff-serveAppleシリコンでMLXを使ってサーブする
対応するMacでは、追加のMac向け依存関係をインストールし、MLXバックエンドを選択します。MLXによるサーブはQwenチェックポイントで利用できます。
uv sync --extra mac
JEFF_BACKEND=mlx JEFF_CHECKPOINT=checkpoints/jeff-0.8b PORT=8765 uv run jeff-serveどちらのコマンドでも、サービスはローカルのポート8765で公開されます。
最初の分類リクエストを送信する
リクエストには状況を説明するstateと、1つ以上の判断を定義するquestionsオブジェクトが含まれます。次の例では、Jeffに顧客メッセージの振り分けを行わせ、顧客が怒っているかどうかも個別に推定させます。
curl -s localhost:8765/v1/systemone \
  -H 'content-type: application/json' \
  -d '{
    "model": "jeff-latest",
    "state": "Refund request: the customer says the parcel arrived crushed and wants their money back.",
    "questions": {
      "route": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "1": "Refunds and payments",
          "2": "Damaged or lost parcels",
          "3": "Account and login problems"
        }
      },
      "angry": {
        "type": "noul",
        "instructions": "Is the customer angry?"
      }
    }
  }'
Jeffは1回のリクエストで両方の質問を評価します。各回答には、確率、選択された選択肢、信頼度が含まれます。アプリケーションでは選択された回答をそのまま使用することも、独自の信頼度しきい値を適用することもできます。
質問タイプを理解する
Choice
choice質問では、最大255個の選択肢から1つを選びます。criteriaには短い識別子を入れ、対応する値で選択肢の意味を説明します。
"route": {
  "type": "choice",
  "instructions": "Which team should handle this?",
  "criteria": {
    "1": "Refunds and payments",
    "2": "Damaged or lost parcels",
    "3": "Account and login problems"
  }
}
Noul
noul question は、確率として返される yes/no 判定を表します。メッセージが怒っているか、緊急か、安全でないか、関連性があるかといった確認に便利です。
"angry": {
  "type": "noul",
  "instructions": "Is the customer angry?"
}
スコア
score question は、回答を指定した尺度上に配置します。カテゴリ型のラベルではなく、段階的な評価が必要な場合に使用します。
効果的な判定プロンプトを書く
プロンプトの表現は、小規模な分類器の性能に大きな影響を与えます。Jeff を使用する際は、次の実践が特に重要です。
- コードで推論し、Jeff で判定する。 決定論的なルール、将来の状態、複数ステップの結果はアプリケーションで計算します。その結果の状況を Jeff に渡し、最終的な判断をさせます。
- 結果を直接説明する。 モデルに「車が2ターン後に到着する」と予測させるのではなく、特定の手を選ぶと車にひかれることになる、と記述します。
- 選択肢の説明形式を統一する。 選択肢には、同様の構成と比較可能な詳細さを使用します。表現の不統一は判定に偏りを生む可能性があります。
- 短い選択肢キーを使う。 長い内部識別子よりも
{"1": "Engagement letter"}を使用します。長いキーは選択肢の説明を改善せず、処理コストだけを増やします。 - 独立した質問をまとめる。 複数の判定が同じ状態を共有する場合は、入力を繰り返すのではなく、1回のリクエストで送信します。
- 代表的なデータでテストする。 ベンチマーク結果は有用な参考情報ですが、特定のワークフローでの性能を保証するものではありません。
Jeff はプランナーではなく分類器です。コードで関連する事実を準備し、モデルが明確に説明された選択肢から選べるようにすると、最も効果を発揮します。
性能と制限
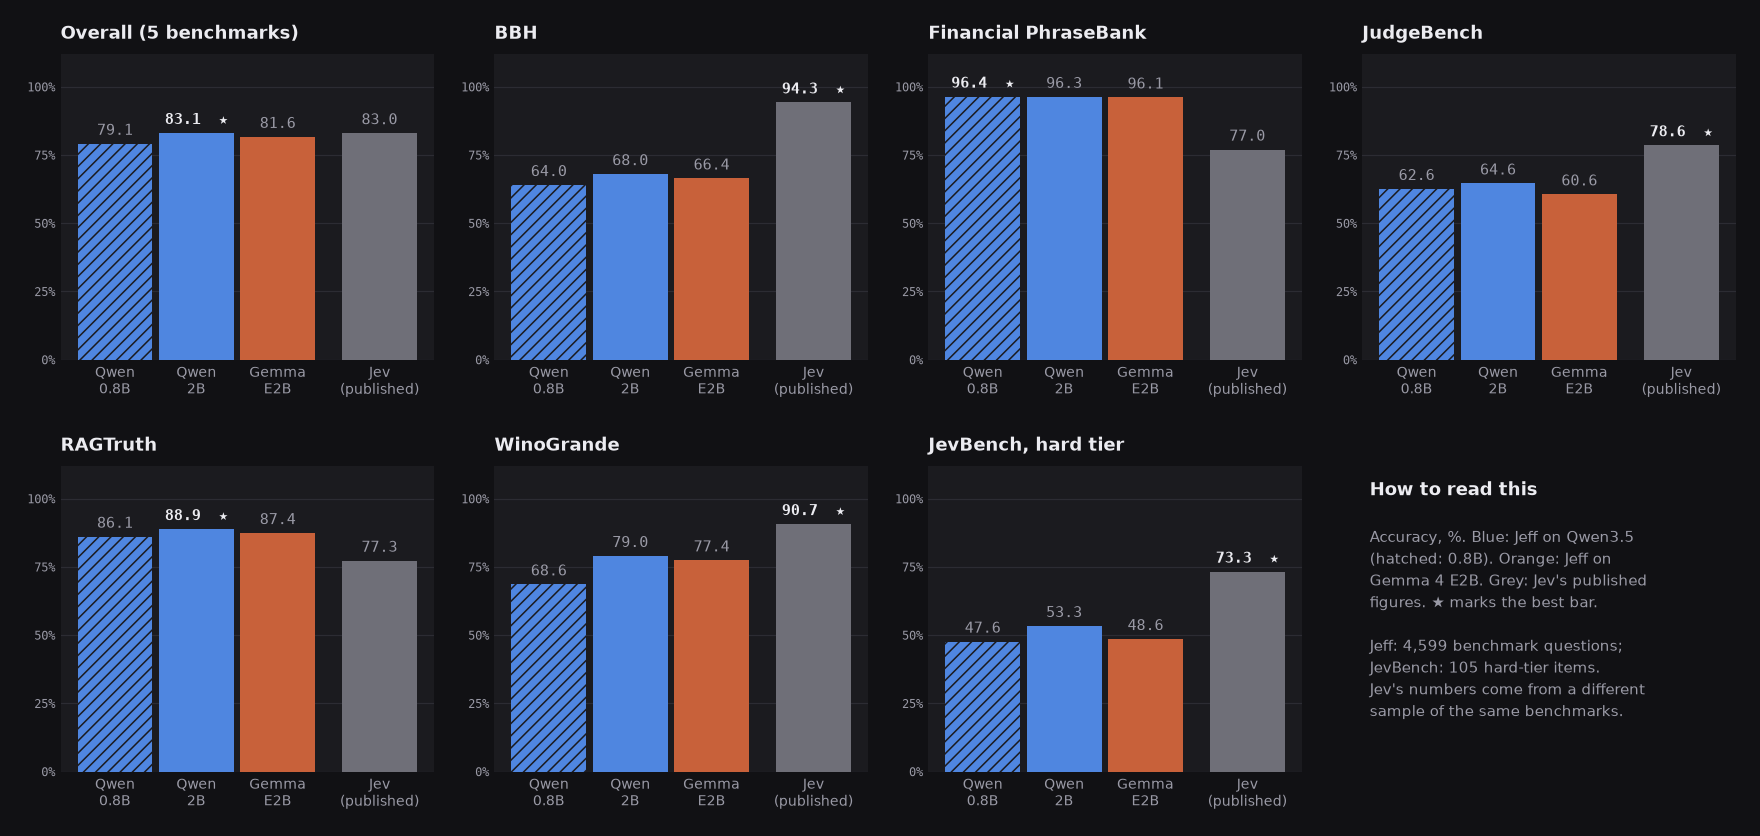
公開ベンチマーク5件でのプロジェクト評価では、Jeff-Qwen3.5-0.8B は79.1、Jeff-Qwen3.5-2B は83.1、Jeff-Gemma4-E2B は81.6を記録しました。Qwen 2B の結果は Jev の公開総合値83.0に近いものでしたが、Jev と AutoJev の数値は同じベンチマークから取得した異なるサンプルで測定されています。
結果はタスクによって大きく異なります。Jeff は Financial PhraseBank や RAGTruth など、複数の分類・グラウンディング評価で優れた性能を示します。一方、BBH、JudgeBench、JevBench の hard tier など、推論負荷の高いベンチマークでは、より大規模なシステムを下回っています。
約200トークンの入力に対する報告済みの推論時間中央値は、0.8Bモデルで RTX PRO 6000 使用時22ミリ秒、MLX を使った M4 Max 使用時28ミリ秒、32スレッドCPU使用時463ミリ秒でした。これらの数値はハードウェア固有のため、自身のデプロイ環境でも再測定してください。
ゲームハーネスを試す
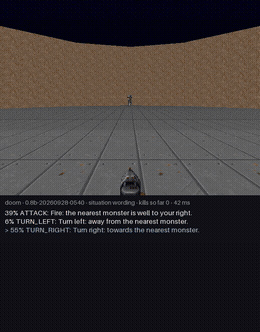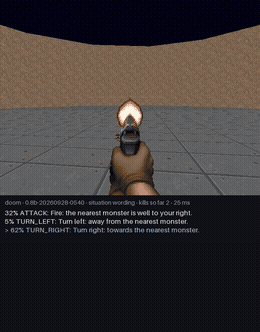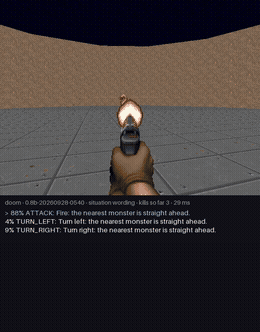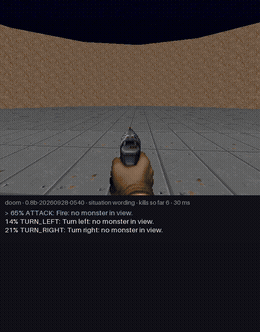
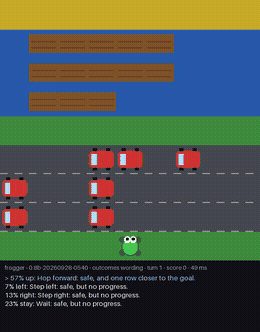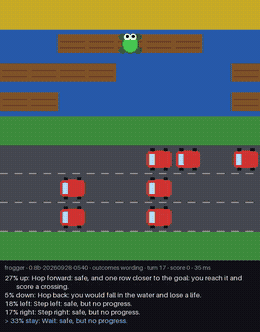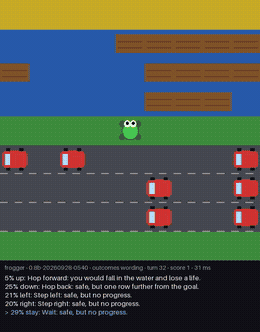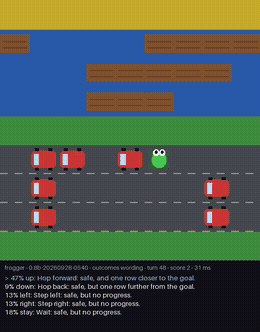
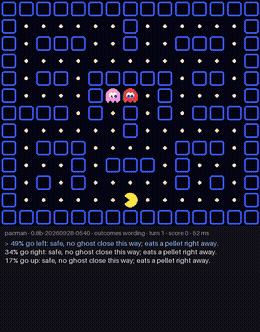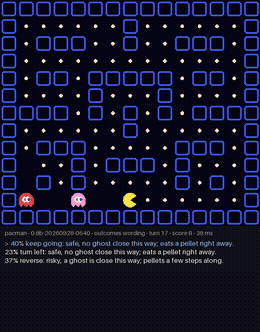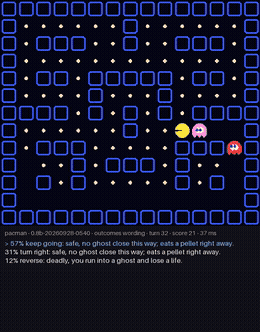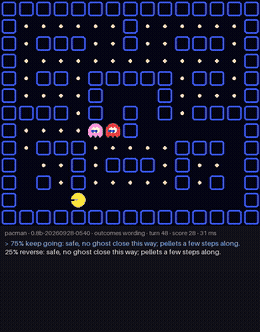
リポジトリには、動的に記述された合法手に対する判定を示す Doom、Frogger、Pac-Man の実験が含まれています。実行前にオプションのゲーム依存関係をインストールしてください。
uv sync --extra gamesJeff サーバーを起動した状態で、付属の Doom と Frogger の評価を実行できます。
uv run python -m jeff.games --game doom --player jeff --criteria situation --url http://127.0.0.1:8765 --video --out runs/games/doom.json
uv run python -m jeff.games --game frogger --player jeff --criteria outcomes --url http://127.0.0.1:8765 --out runs/games/frogger.json
比較のため、Pac-Man のルールベースプレイヤーを実行することもできます。
uv run python -m jeff.games --game pacman --player rule --out runs/games/pacman-rule.jsonこれらの実験は、重要な制限も示しています。ベンチマークの順位は、インタラクティブなゲーム性能を必ずしも予測しません。公開結果では、2Bモデルの総合ベンチマークスコアが高かったにもかかわらず、複数のケースで0.8Bの Jeff モデルのほうが2Bの Jeff モデルよりゲームをうまくプレイしました。
ドメイン向けに Jeff をファインチューニングする
ゼロショット精度が不十分な場合は、Jeff のチェックポイントを起点にし、アプリケーションの例で学習します。README によると、約11,000件のアプリケーション固有の例を使った音声ナビゲーション向けファインチューニングにより、1台のGPUで約30分かけて、ホールドアウト精度が31.7%から95.8%に向上しました。
autojev-train --initial-checkpoint <jeff> --epochs 1 ...リポジトリでは、より広範な学習ワークフローも提供しています。一般的な手順では、データの混合を作成し、学習を実行して、選択したチェックポイントを評価します。
uv run autojev-mix ...
scripts/train.sh RUN data/mix/public.jsonl data/mix 5e-6 40 Qwen/Qwen3.5-0.8B <revision> --epochs 1
uv run autojev-evaluate --data data/panel.jsonl --local --checkpoint checkpoints/RUN/selected --output runs/eval/RUN.json
公開されているレシピでは、1エポックの全重みファインチューニング、バッチサイズ256、選択肢の文字に対するクロスエントロピー、確率キャリブレーション用の学習済み温度を使用します。チェックポイントはベンチマークパネルではなく、開発用データセットを使って選択されます。
ローカルでの合成データ生成パイプライン全体、リークフィルタリング、学習率のスイープ、ダッシュボードのワークフローについては、scripts/train_all.sh を参照してください。プロジェクトでは、学習データの出典とライセンスを docs/data-sources.md に記載しています。
高度なデプロイのヒント
- 自分のデータで測定値をキャリブレーションする。 汎用モデルをキャリブレーションしても、エスカレーションやフォールバックの動作には、アプリケーション固有のしきい値が必要になる場合があります。
- 安全なフォールバックを追加する。 信頼度が低すぎる場合は、リクエストを人間、決定論的なルール、またはより高性能なモデルに振り分けます。
- 状態を簡潔に保つ。 判断に必要な事実を提示し、小型モデルの注意をそらす可能性がある無関係なテキストは避けます。
- 表現のバリエーションを評価する。 本番スキーマを確定する前に、指示と基準について一貫性のある複数の表現を比較します。
- モデルは実証的に選択する。 レイテンシーが重視される選択処理には0.8Bモデルを使用しますが、適切なすべてのチェックポイントを自分の検証セットでテストしてください。
- モダリティの制限を守る。 READMEによると、Jeffが対応しているのは英語テキストのみです。
まとめ
Jeffを使うと、自由形式のテキストを生成したり解析したりせずに、高速でローカルな確率ベースの判断をアプリケーションに追加できます。まずはJeff-Qwen3.5-0.8Bから始め、各選択肢を明確に説明し、独立した質問を1つのリクエストにまとめ、実際のアプリケーション例で評価してください。ゼロショットの動作では不十分な場合は、ドメイン固有のデータで既存のJeffチェックポイントをファインチューニングします。