

WeMM-Embeddingとは?
WeMM-Embeddingは、WeChat Visionチームが開発した汎用マルチモーダル埋め込みモデルのファミリーです。テキスト、画像、動画、ビジュアルドキュメント、インターリーブされたマルチモーダル入力を、統一されたベクトル表現に変換します。これらのベクトルは、異なるモダリティ間でコンテンツを表現・比較する必要があるワークフローを支援できます。
各モデルは、専用の<embedding>トークン位置における最終層の隠れ状態から埋め込みを取得し、その後L2正規化を適用します。現在、音声入力には対応していません。
主な特徴
- 統一されたマルチモーダル表現:同じモデルファミリーで、テキスト、画像、動画、ビジュアルドキュメント、インターリーブ入力を処理できます。
- 複数のモデルサイズ:パラメータ数が2B、4B、9Bのバリアントから選択できます。
- Matryoshka Representation Learning:ストレージ容量や検索効率が重要な場合、対応する短いベクトル次元を使用できます。
- 2つの推論インターフェース:TransformersとSentence Transformersの両方の例が用意されています。
- 本番環境での提供:リポジトリには、vLLMとSGLang用の設定およびラッパースクリプトが含まれています。
- 評価ツール:付属のMMEB-v3パイプラインは、単一ノードおよびマルチノード推論に対応しています。
モデルと次元の選択
モデル一覧には、Hugging Face上の3つのバリアントが掲載されています。利用可能な計算リソースと必要な完全埋め込みサイズに応じてモデルを選択してください。
- WeMM-Embedding-2B:64、128、256、512、1024、2048次元に対応。
- WeMM-Embedding-4B:64、128、256、512、1024、2560次元に対応。
- WeMM-Embedding-9B:64、128、256、512、1024、2048、4096次元に対応。
対応する次元を小さくすると、ベクトルのストレージ容量と下流処理の計算量を削減できます。たとえばREADMEによると、2Bモデルを256次元で使用した場合、MMEB-v2における画像および動画性能の98.7%を完全次元時に対して維持できます。
インストールとセットアップ
1. リポジトリとモデルを取得する
リポジトリをローカルに取得して作業し、Hugging Faceのモデルページからモデルをダウンロードします。または、対応している場合は、関連するサンプルを設定してHugging Faceのモデル識別子を使用します。
2. 依存関係をインストールする
プロジェクトで指定されているバージョンをインストールします。
pip install -r requirements.txt3. 再現性のためにTransformersのバージョンを固定する
新しいリリースでは前処理の動作が異なる可能性があるため、プロジェクトでは推論と再現性のためにtransformers==5.2.0を推奨しています。
pip install transformers==5.2.0サンプルを実行する前に、モデル、テスト画像、テスト動画へのパスを準備してください。
Transformersの基本的な使い方
Transformersのサンプルは、テキスト、画像、動画の入力に対して個別の埋め込みを生成します。ローカルのモデルパスと対応する出力次元を指定して実行します。
python examples/transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
--dimension 2048プレースホルダーのパスをシステム上のファイルに置き換えてください。2Bモデルでは、2048が完全なベクトルサイズです。明示的に指定せず、モデルの完全な埋め込み次元を使用するには、--dimensionを省略します。
python examples/transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4
Sentence Transformersの基本的な使い方
Sentence Transformersのサンプルは、SentenceTransformer.encode()を通じてテキスト、画像、動画の入力を処理します。--dimensionによるMatryoshka次元の選択にも対応しています。
python examples/sentence_transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
--dimension 2048SentenceTransformerはモデルを直接読み込めるため、ローカルパスをHugging Faceのモデル識別子に置き換えることもできます。
python examples/sentence_transformers_inference.py \
  --model tencent/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
  --dimension 2048
Matryoshka埋め込みを正しく使用する
Matryoshka埋め込みを使用すると、完全なベクトルを選択したモデルが対応するいずれかの次元に短縮できます。最終軸を切り詰めた後、短縮したベクトルを再度正規化します。
embedding = torch.nn.functional.normalize(
    embedding[..., :d],
    dim=-1
)dには、モデルに対して一覧表示されている次元のみを指定してください。切り詰めるとベクトルノルムが変化するため、2回目の正規化が重要です。付属のコマンドラインサンプルを使用する場合は、--dimensionで目的のMatryoshka次元を選択します。
vLLMでモデルを提供する
リポジトリでは、vLLM 0.27.0でテストしたことが報告されています。プーリングサーバーを起動し、モデルの埋め込み用チャットテンプレートを指定します。
MODEL_PATH=/path/to/WeMM-Embedding-2B
vllm serve "$MODEL_PATH" \
  --runner pooling \
--chat-template "$MODEL_PATH/embedding_chat_template.jinja"同等のラッパーはscripts/serve_vllm.shに用意されています。
SGLangでモデルを提供する
プロジェクトのドキュメントでは、SGLang 0.5.9がテスト済みのバージョンとして記載されています。埋め込みサーバーを起動する前に、付属の動画パッチを適用してください。
MODEL_PATH=/path/to/WeMM-Embedding-2B
python scripts/patch_sglang_video.py
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --is-embedding \
  --enable-precise-embedding-interpolation
リポジトリには、1つのコマンドで実行できるラッパーとして scripts/serve_sglang.sh も用意されています。
MMEB-v3評価の実行
mmeb_v3_eval/ディレクトリには、報告されているMMEB-v3の結果に使用した評価コードが含まれています。これは公式のVLM2Vecパイプラインを基盤としており、WeMM-Embeddingバックボーン、整合されたデータセット指示、バッチ推論、マルチノード・マルチGPU実行、64フレームの動画サンプリングが追加されています。
まず評価ディレクトリに移動し、データをダウンロードします。
cd mmeb_v3_eval
DATA_ROOT=/path/to/MMEB-V3 bash scripts/download_data.sh
次に、モデル、データセット、出力先のパスを指定して評価を実行します。
MODEL_PATH=/path/to/WeMM-Embedding-2B \
DATA_BASEDIR=/path/to/MMEB-V3 \
OUTPUT_DIR=exps/wemm_embedding \
bash scripts/run_eval.shデータのセットアップ、および単一ノードまたはマルチノードでのコマンドについては、mmeb_v3_eval/README.mdに記載された説明を参照してください。
高度なヒント
- モデルに合わせて次元数を指定する: 2Bモデルで2560次元、4Bモデルで4096次元を要求しないでください。選択したチェックポイントに記載されている次元数のみを使用してください。
- 切り詰めたベクトルを再正規化する: 完全な埋め込みを手動で短縮した場合は、必ずその後にL2正規化を適用してください。
- 前処理の再現性を維持する: リリース間で前処理が変わる可能性があるため、結果を再現する際は推奨されるTransformersのバージョンを使用してください。
- 適切な読み込み方法を使用する: 記載されているTransformersのコマンドではモデルパスを使用しますが、Sentence Transformersの例では
tencent/WeMM-Embedding-2Bを直接読み込むこともできます。 - 未対応の音声を考慮する: 現在、モデルは音声を受け付けないため、報告されているMMEB-v3の音声スコアはゼロです。
- 利便性のためにサービングラッパーを使用する:
scripts/内のシェルスクリプトには、記載されているvLLMおよびSGLangの起動設定がまとめられています。
性能に関する補足
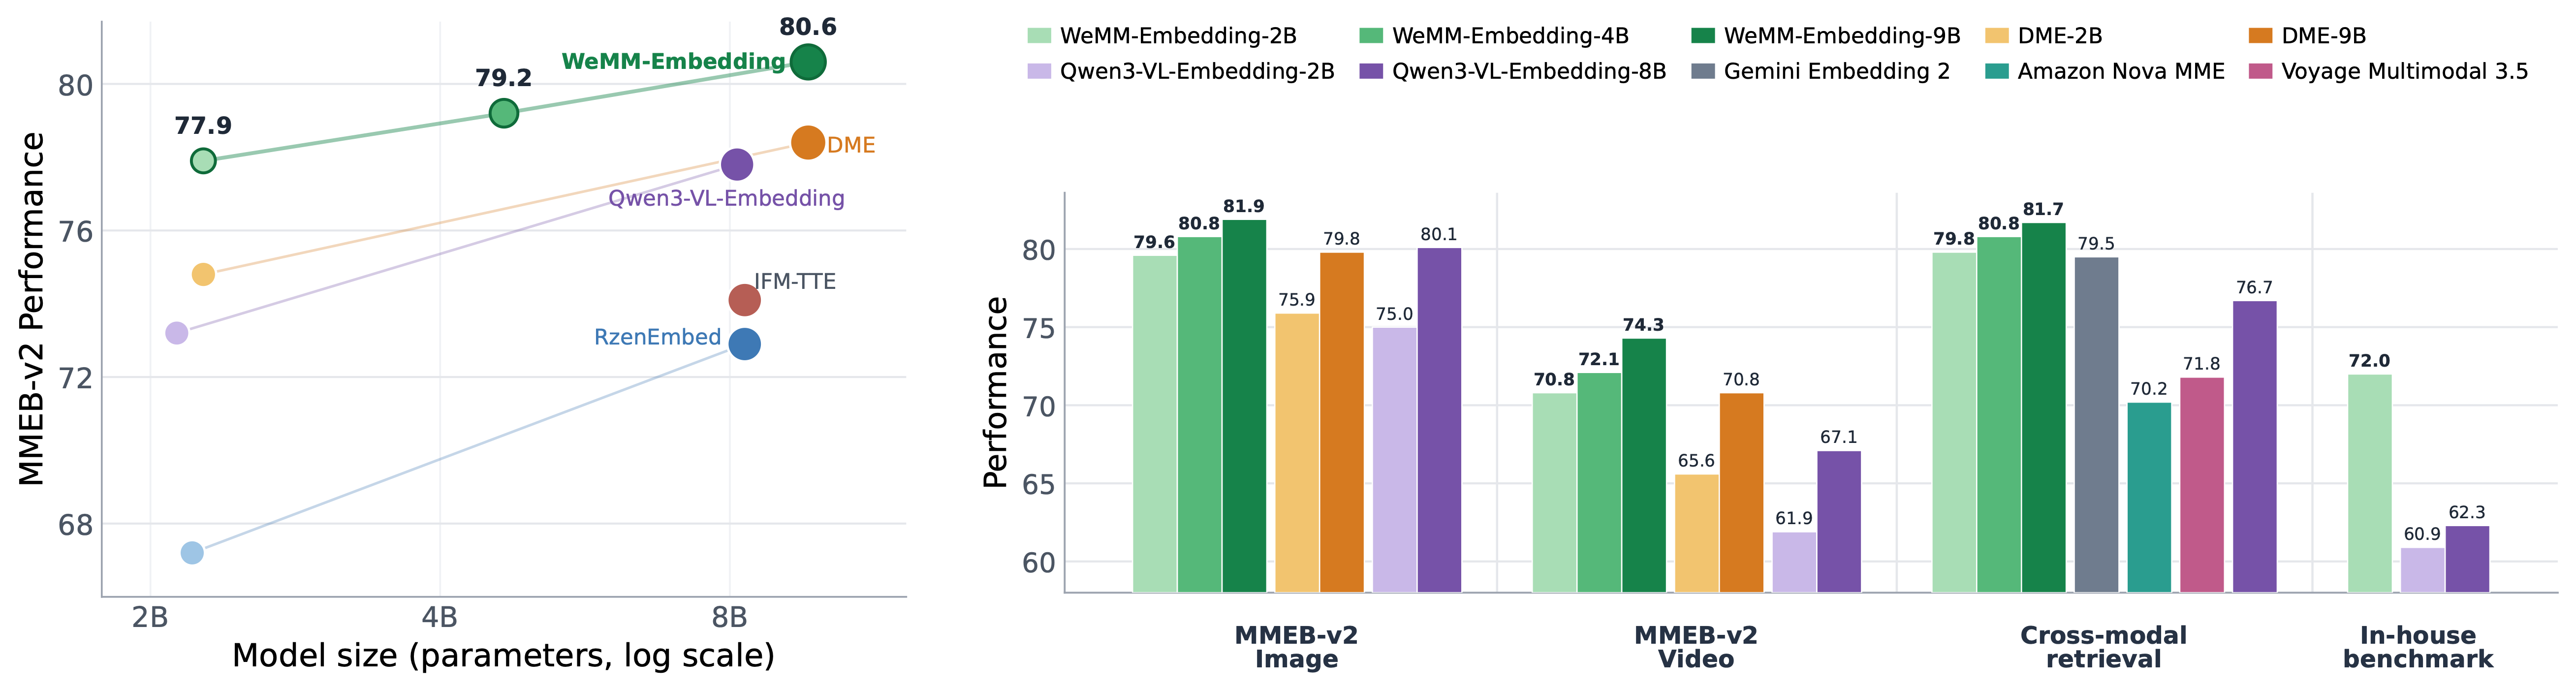
READMEでは、78のMMEB-v2データセットと、MMEB-v3の全190タスクにおける結果が報告されています。MMEB-v2では、2B、4B、9Bの各バリアントの平均スコアは、それぞれ77.9、79.2、80.6です。MMEB-v3で報告されている全体スコアは、それぞれ56.0、58.2、59.5です。指標はタスクグループによって異なり、画像および動画タスクではHit@1、ビジュアルドキュメントおよびテキストタスクではNDCG@5、エージェント、MCMR、音声タスクではHit@1が使用されます。
ベンチマークスコアは、記載されているタスク範囲を踏まえて解釈してください。MMEB-v3では、WeMM-Embeddingの音声タスクを含め、未対応のタスクにスコア0が割り当てられます。
まとめ
WeMM-Embeddingは、複数の視覚およびテキスト入力タイプから正規化された表現を生成するための、1つのモデルファミリーを提供します。まずは2Bチェックポイントと付属の推論例から始め、コンパクトなベクトルが有用な場合は対応するMatryoshka次元を選択し、サービングや評価が必要になったらvLLM、SGLang、またはMMEB-v3パイプラインへ移行してください。特に記載がない限り、Tencentが作成したリポジトリコードはApache License 2.0の下で公開されています。