

DeepInfer-SM80とは?
DeepInfer-SM80は、vLLM V1エンジンを通じてNVIDIA Ampere GPU上でDeepSeek-V4.1を実行するために最適化されたPython、Triton、TileLangモジュールのコレクションです。NVIDIA Blackwellを対象とするDeepSeekのDeepInferの主要なアイデアを移植し、Ampereハードウェアの能力に合わせて重要な実行パスを再設計しています。
tcgen05ワープグループ命令、Tensor Memory、ハードウェアUE8M0スケール命令、ストリーミングマルチプロセッサーあたり228 KBの共有メモリといったBlackwell専用機能に依存する代わりに、このプロジェクトはAmpereのmma.sync.aligned.m16n8k16 Tensor Core、SMを考慮したスケジューリング、整数ビットシフトによるUE8M0デコード、YOCO共有KV再利用を使用します。
データセンター向けのA100やA800などのSM80 GPUに加え、RTX 3090、RTX 3090 Ti、RTX A6000、A40、A10、A30などのSM86デバイスにも対応しています。カーネルが使用する共有メモリはCTAあたり48 KB以下であり、SM86デバイスのより小さい共有メモリ容量でも実行できます。
利用する理由
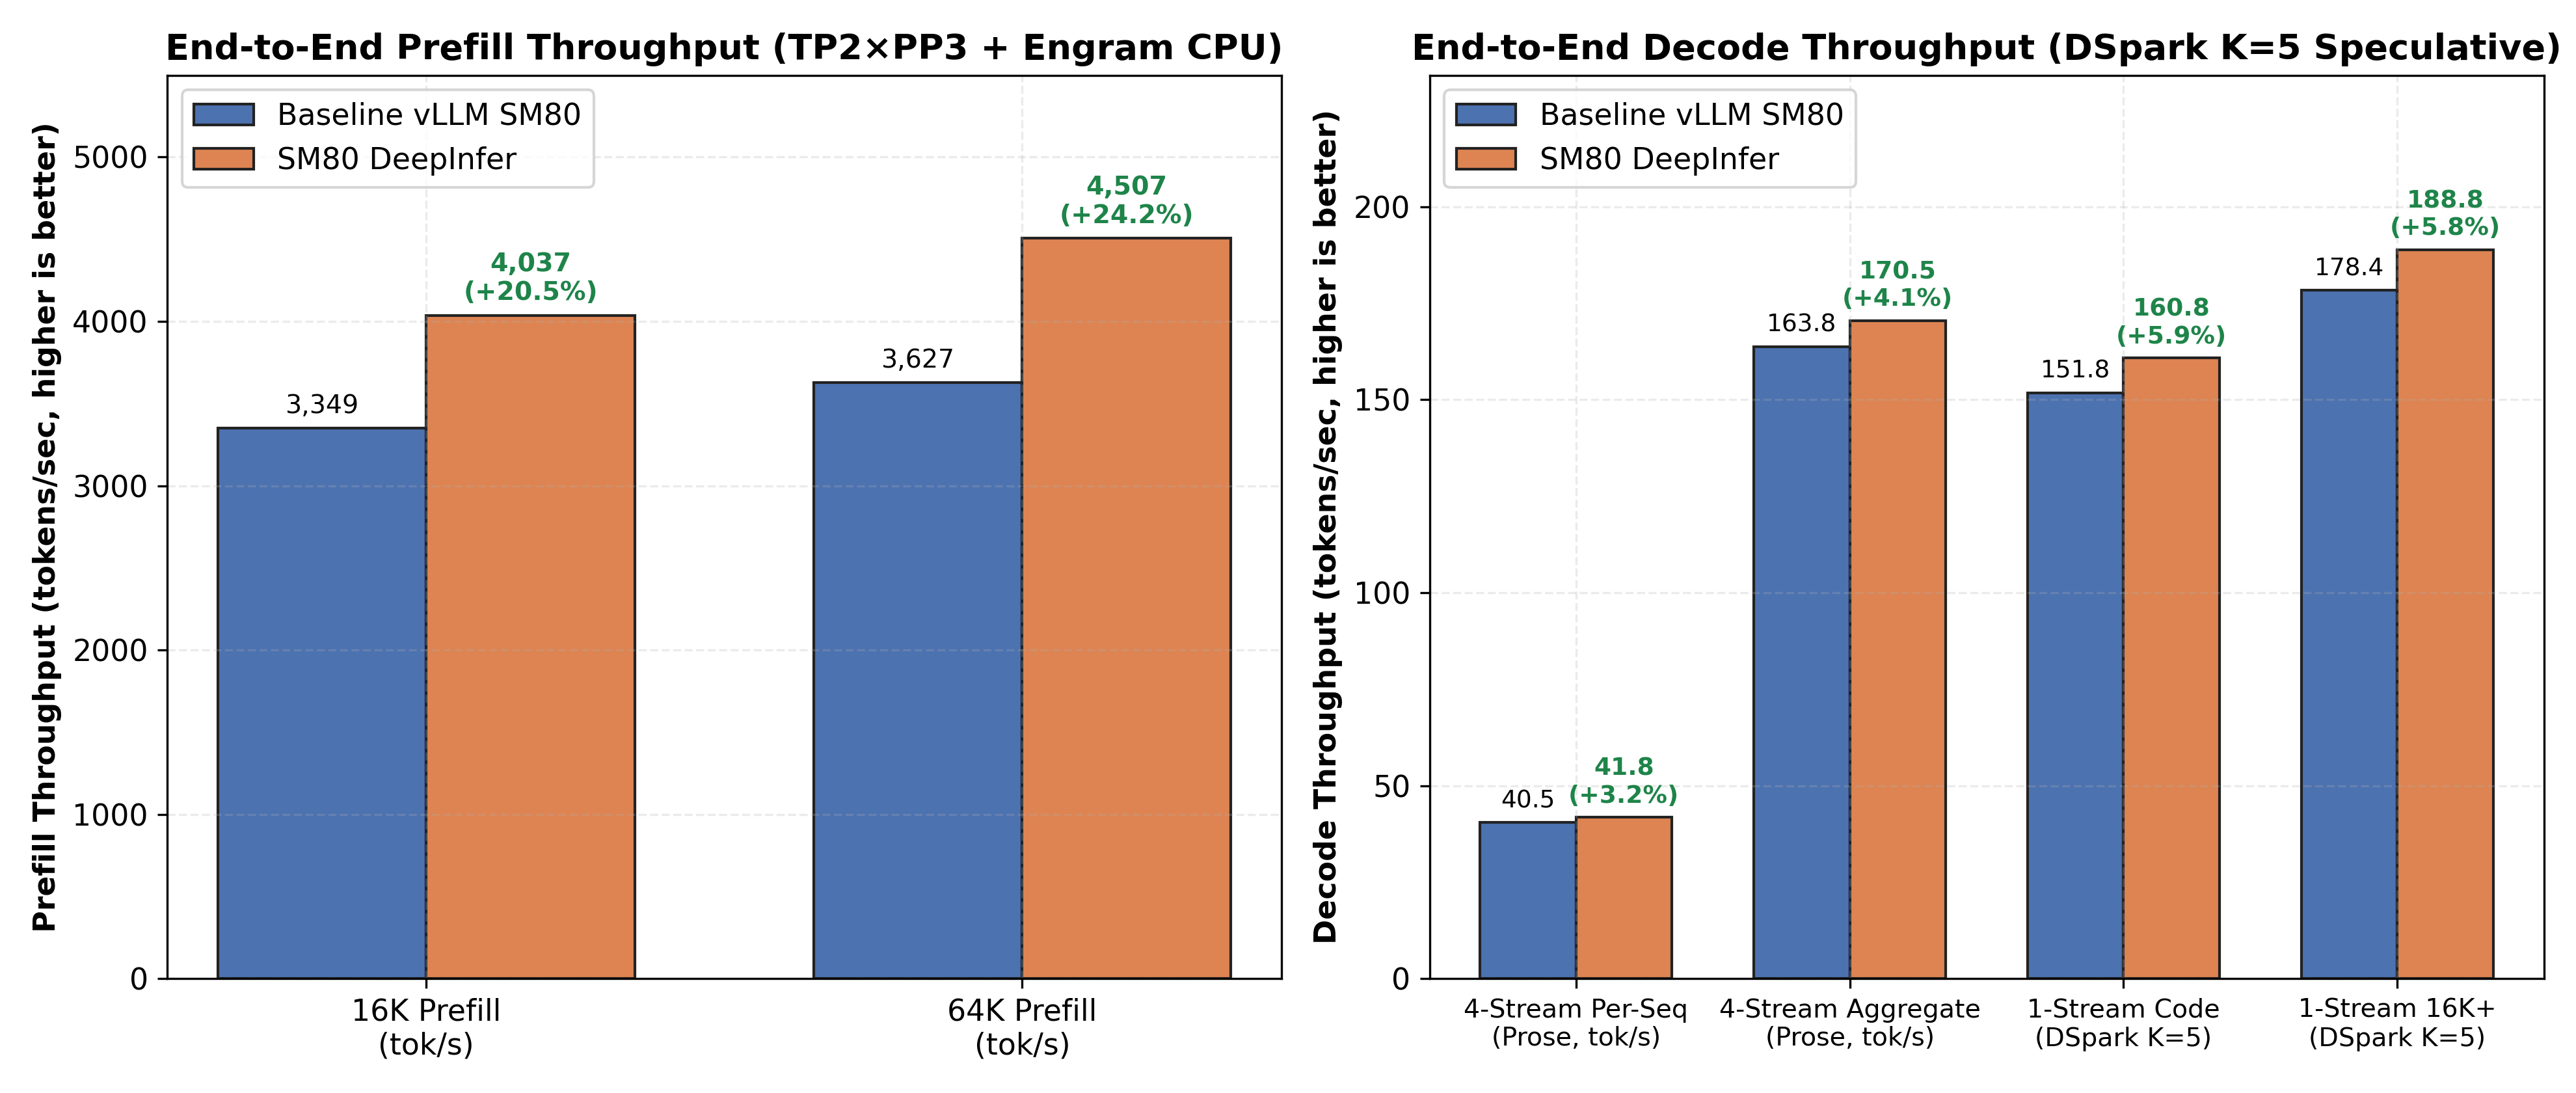
DeepInfer-SM80は、DeepSeek-V4.1のprefill、スパースアテンション、KVキャッシュアクセス、残差ルーティング、長文脈推論に伴う負荷の高い処理に重点を置いています。リポジトリでは、6基のGA100 64 GB GPU、TP2 × PP3、K=5のDSpark投機的デコード、最大コンテキスト長1,048,576トークンを使用した本番構成について、次の結果を報告しています。
- 16Kコールドprefill:3,349.4トークン/秒から4,037.0トークン/秒に向上。
- 64Kコールドprefill:3,627.3トークン/秒から4,506.8トークン/秒に向上。
- 64Kの初回トークン生成時間:13.2秒から10.7秒に短縮。
- 4ストリーム投機的デコード:163.8トークン/秒に対し、合計170.5トークン/秒。
- 単一ストリームのPythonコードデコード:151.8トークン/秒に対し、160.8トークン/秒。
- GPU上のKV容量:4,648,480トークン。ベースラインと比較して追加のVRAMオーバーヘッドなし。
これらの測定値は、リポジトリでテストされたハードウェアとサービング構成に基づいています。他のAmpere GPU、モデル構成、ワークロード、またはvLLM環境では結果が異なる場合があります。
主な最適化
512次元に統合されたスパースMLA
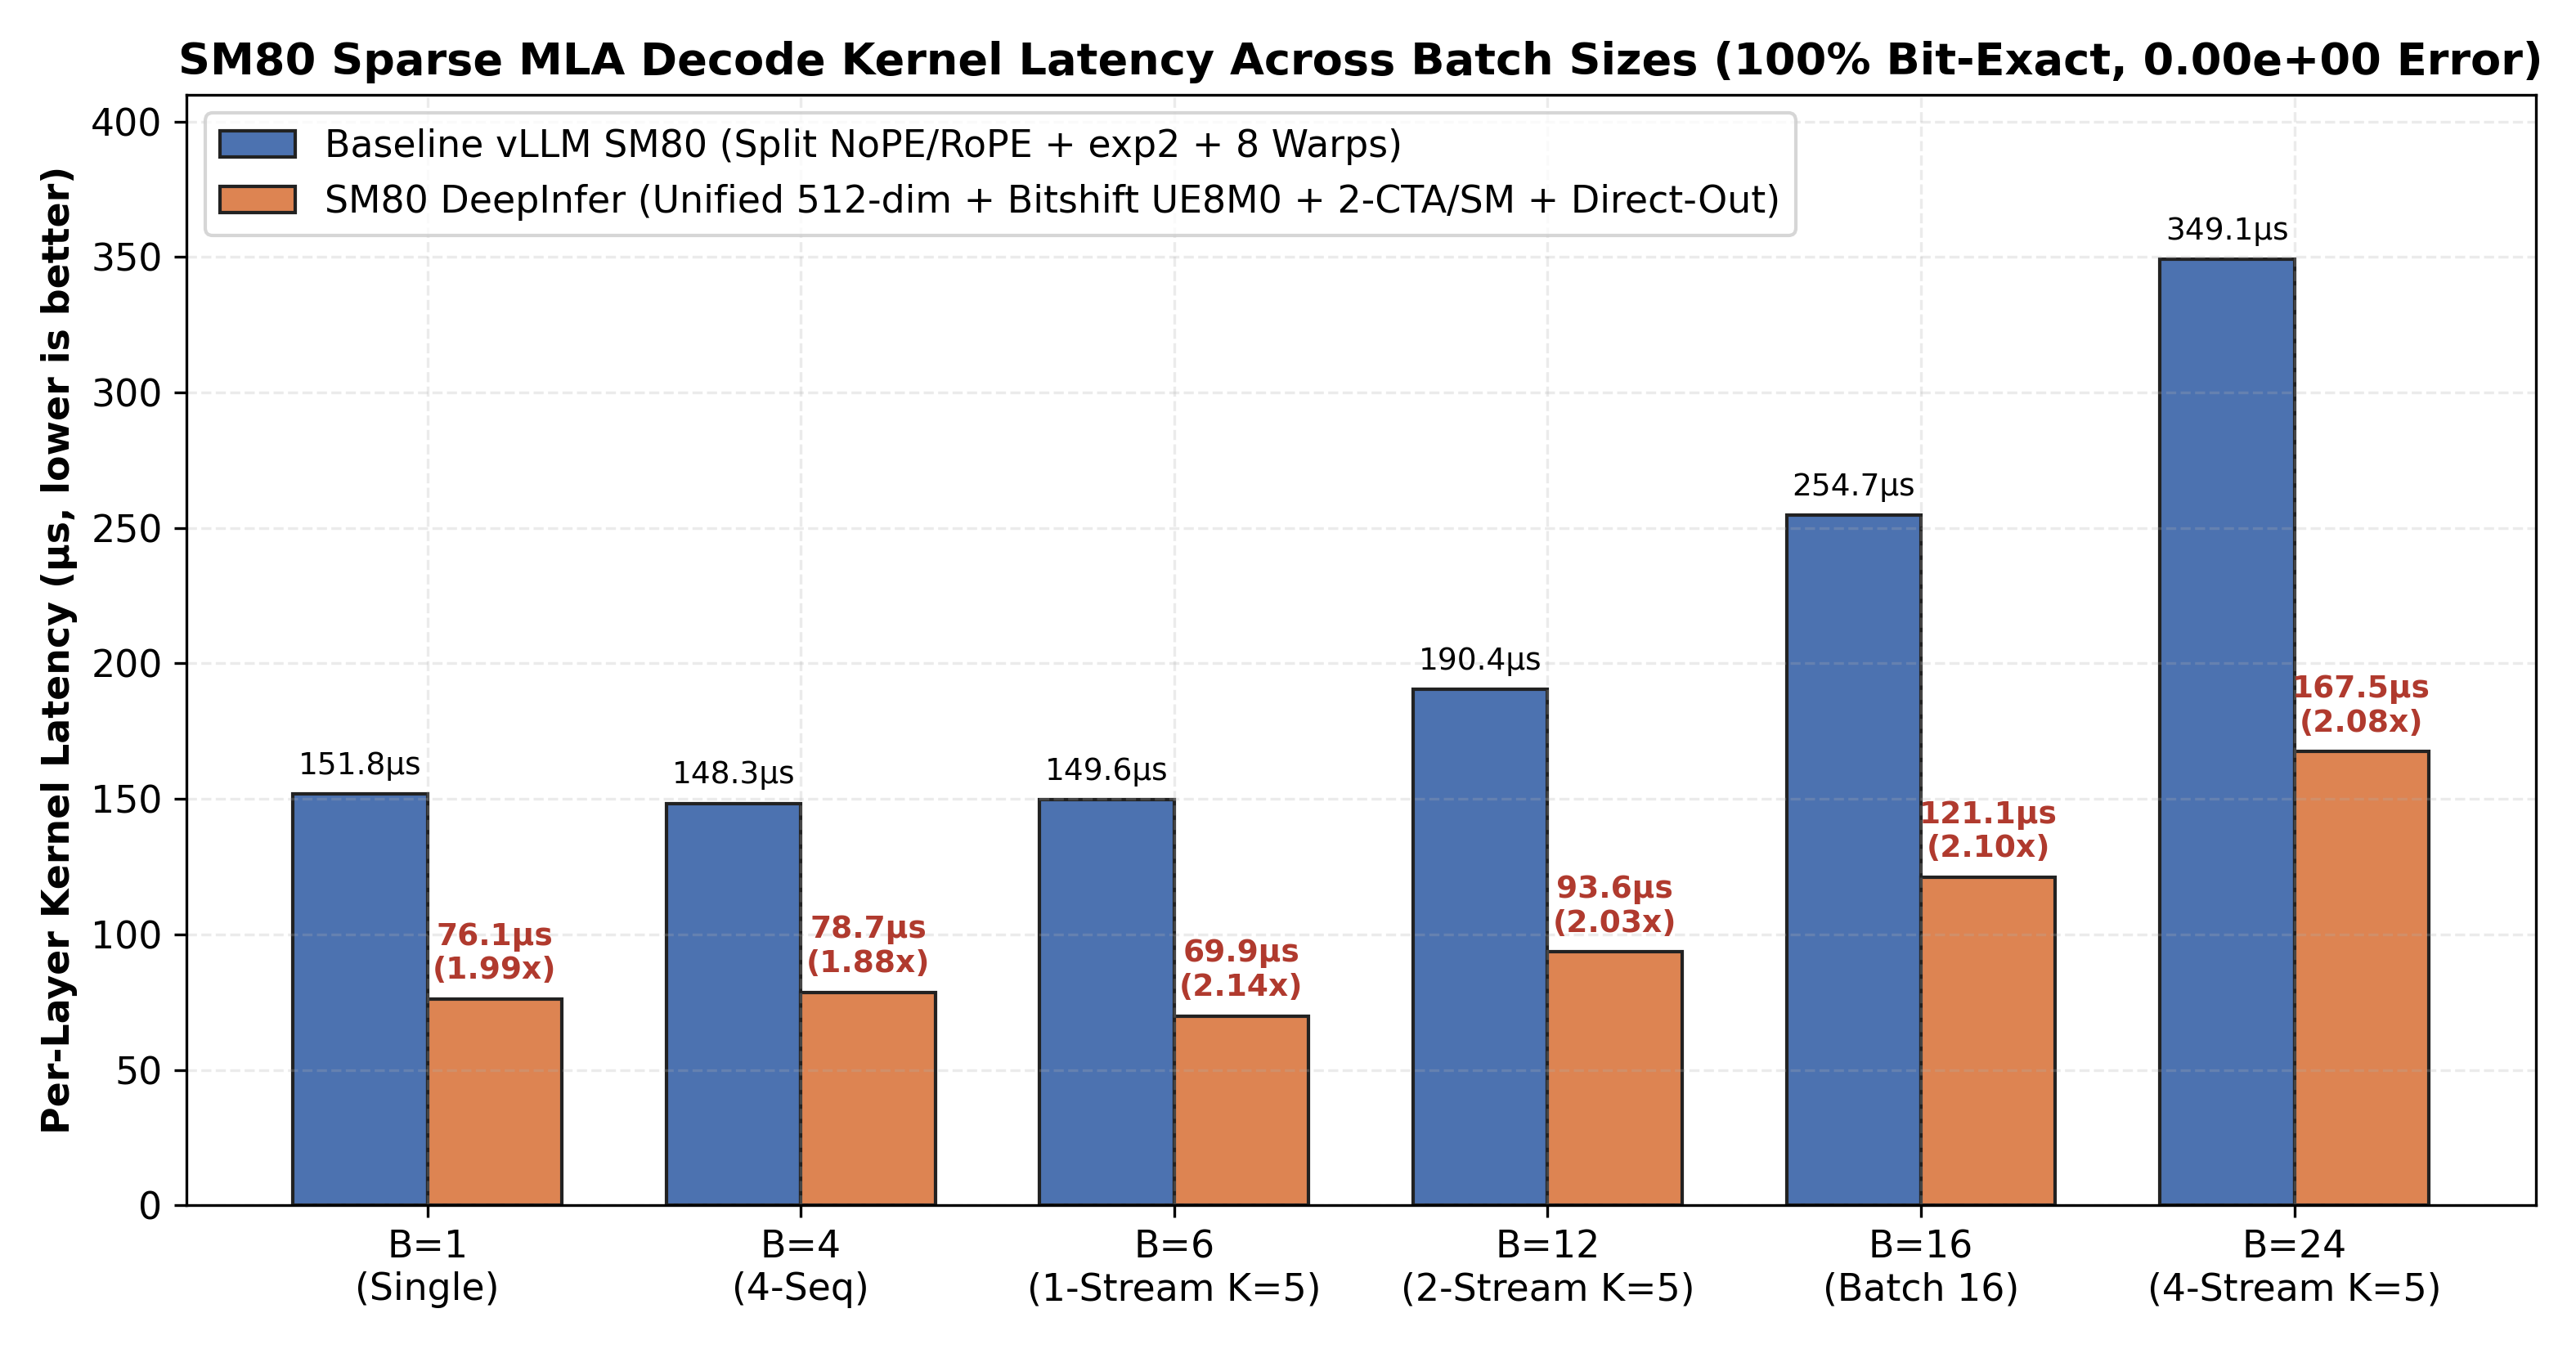
DeepSeek-V4.1のDeepSelectスパースアテンションは、448次元のNoPE潜在表現をUE8M0の2のべき乗ブロックスケールとともにfloat8_e4m3fnで格納し、64次元のBF16 RoPEサフィックスを組み合わせます。DeepInfer-SM80は512次元のタイル全体をロードし、NoPE部分とRoPE部分を個別に処理するのではなく、単一のTensor Coreドット積パスで処理します。
このカーネルは、exp2ベースのUE8M0変換をIEEE-754整数ビットシフトに置き換えます。
(scale_u8.to(tl.int32) << 23).to(tl.float32, bitcast=True)有効なUE8M0指数に対しては、これによりビット単位で同一のFP32スケール値が生成され、処理を超越関数演算から整数パイプラインへ移します。
調整済みの構成はBLOCK_N=64、num_warps=4、num_stages=2を使用します。レジスタ圧力を低減することで、各SM80ストリーミングマルチプロセッサーに2つのCTAを常駐させられます。num_kv_splits == 1の場合、カーネルは最終出力へ直接書き込み、独立したリダクション段階の起動を回避します。
単一CTAによるTop-KとSWAインデックスの結合
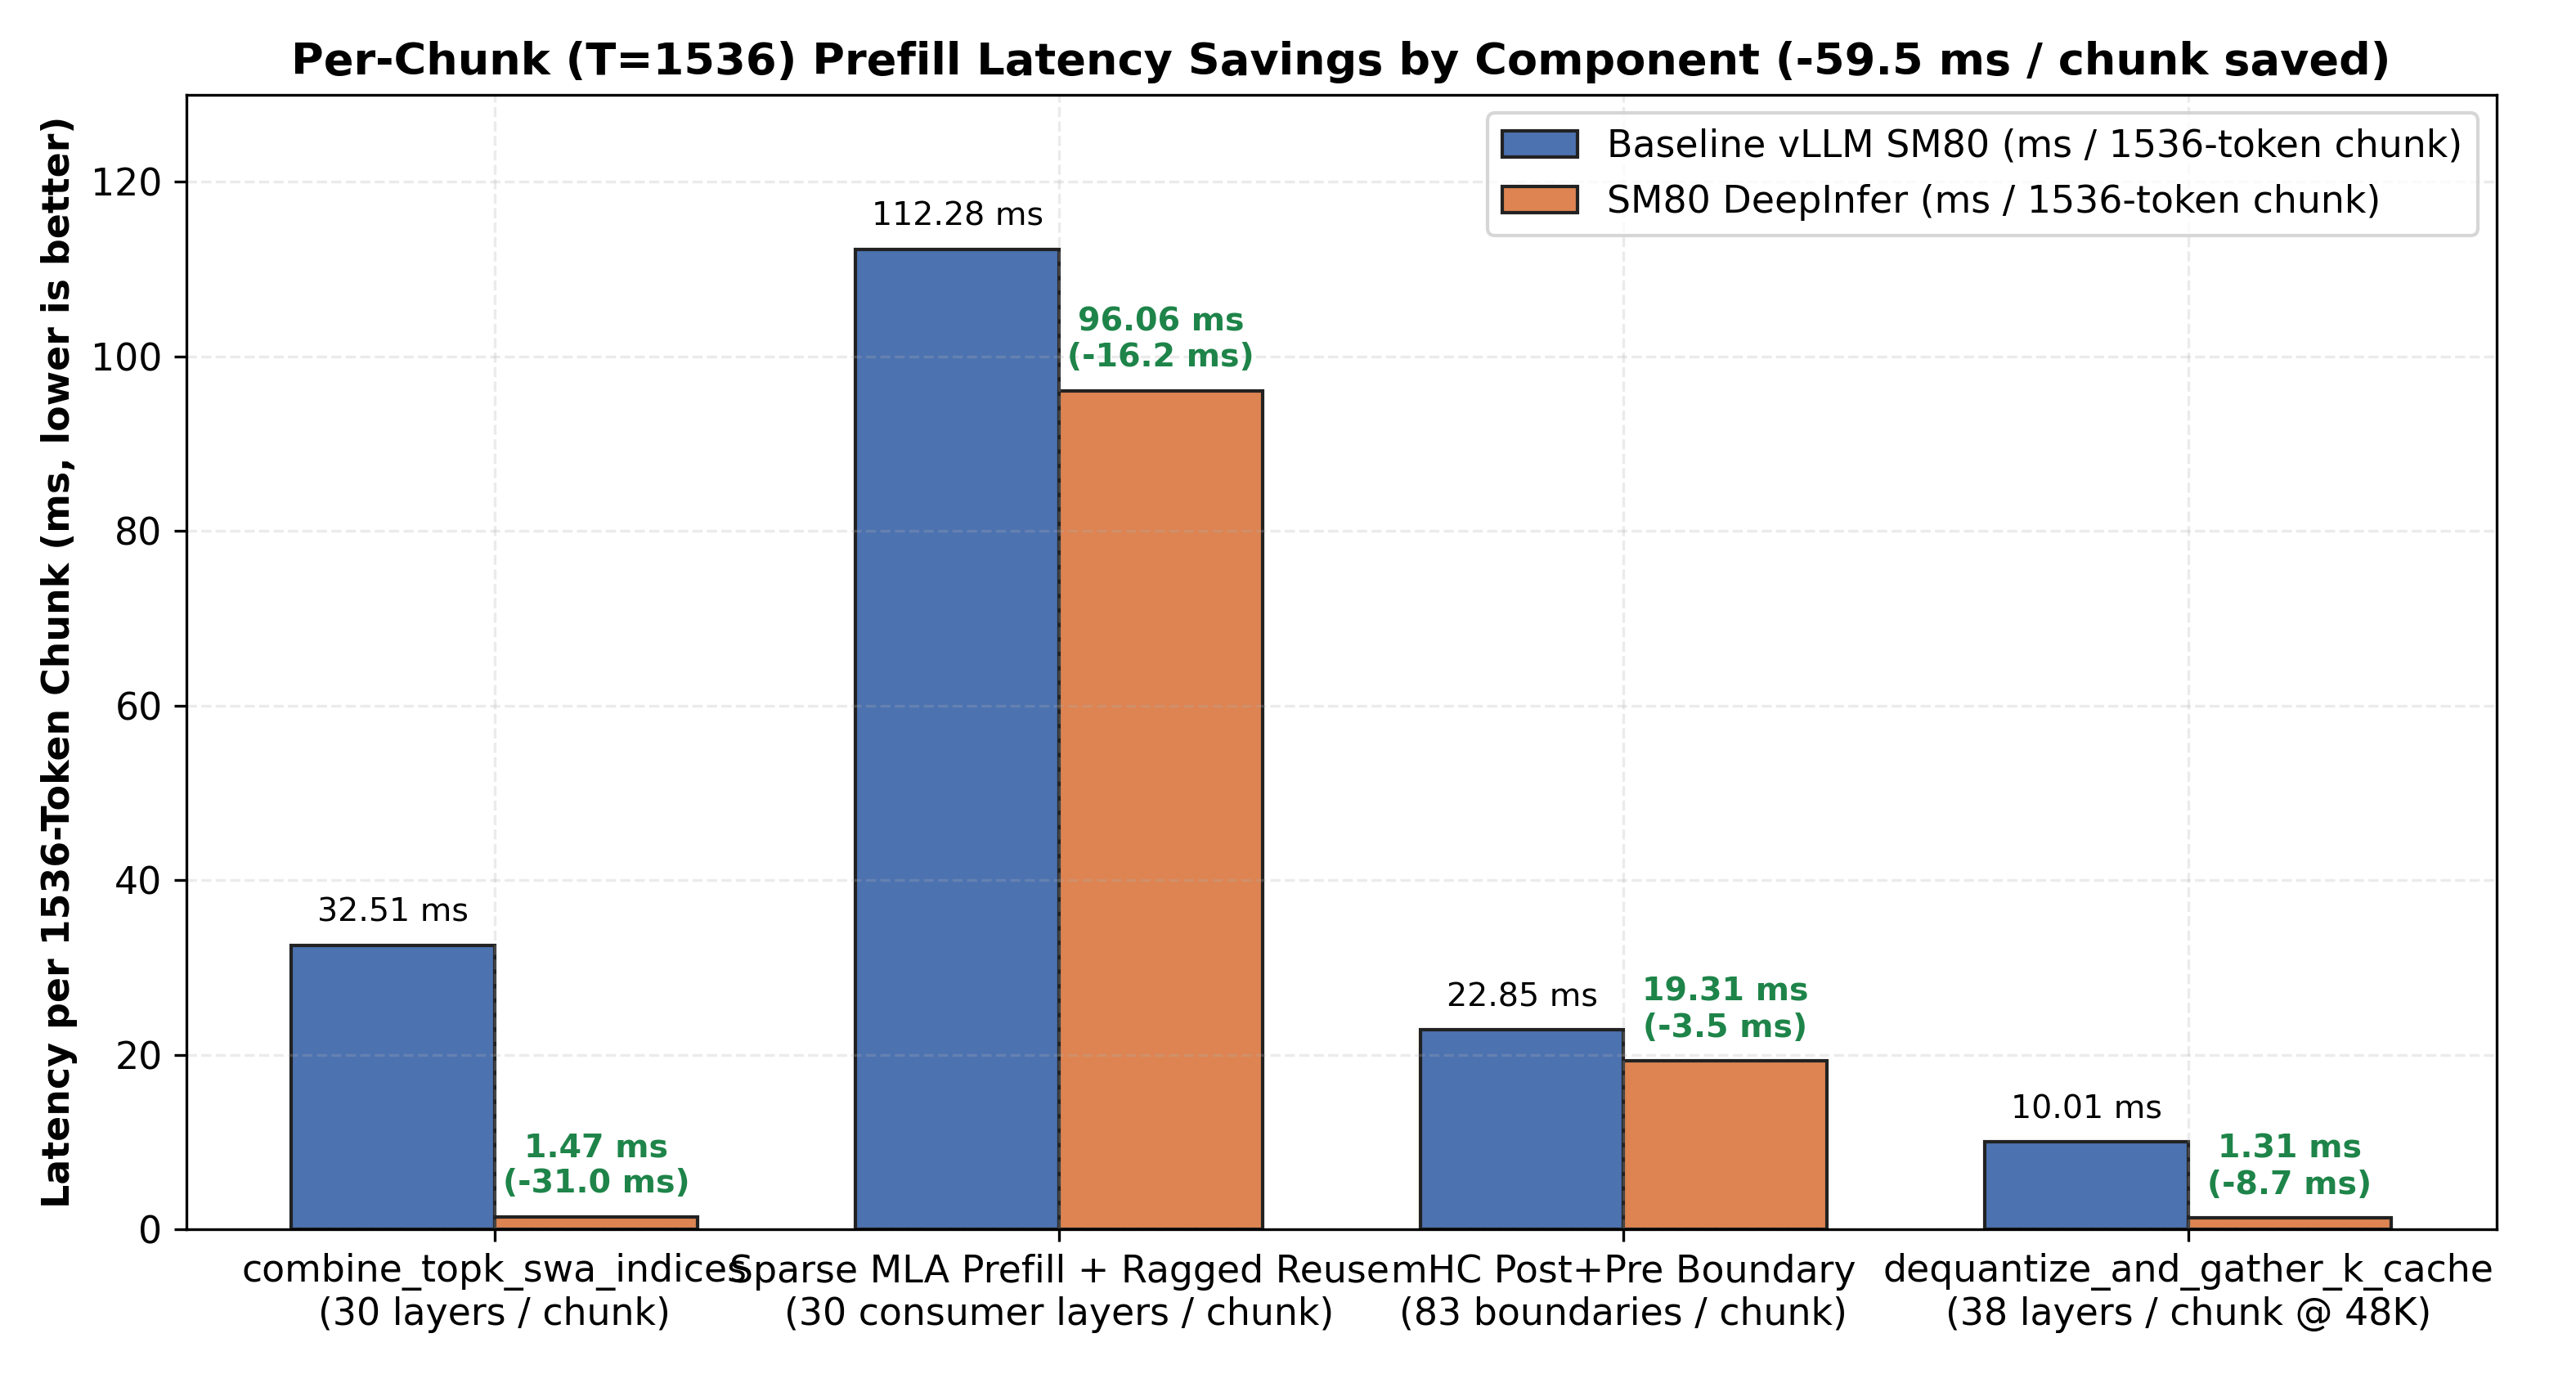
最適化された_combine_topk_swa_indices_kernelは、PyTorchによる一連の割り当てと処理を、クエリトークンごとに1つのCTAを使用する単一のTritonカーネルに置き換えます。T=1536では、測定レイテンシが1,083.72マイクロ秒から48.88マイクロ秒に低下し、22.17倍高速化されます。
ワープ間の書き込み競合を避けるため、各出力行を3つの重複しない領域に分割します。
- 圧縮されたTop-Kインデックスが
[0, topk_len)を占有します。 - スライディングウィンドウアテンションのインデックスが
[topk_len, topk_len + swa_len)を占有します。 - 残りの列は
-1でパディングされます。
READMEでは、テストしたすべてのシーケンス長と、圧縮率0、1、2においてビット単位で完全に一致する出力を報告しています。
KVキャッシュの非量子化と収集の高速化
dequantize_and_gather_k_cacheパスは、同じビットシフトベースのUE8M0変換を使用します。また、Tritonカーネルに渡された宛先ストライドを使って書き込むため、中間torch.empty割り当てと、その後の.copy_()処理を排除します。
測定された高速化率は、16Kコンテキストで4.02倍、48Kコンテキストで7.64倍です。報告されたテストでは、参照実装とビット単位で完全に一致しました。
SM80向けに調整されたmHC残差ルーティング
DeepSeek-V4.1は、フォワードパスごとに83の境界で4ストリームの多様体制約付きハイパーコネクションルーティングを実行します。DeepInfer-SM80は、モデルの隠れサイズ5,120に対して、整列した(6, 8, 128)分割ジオメトリを追加します。8つのスライスはそれぞれ640要素で、128で割り切れます。
また、小行列のしきい値を32から16に下げ、トークン数が16以上の場合にTensor CoreのT.gemmパスを使用できるようにしています。報告されたmhc_fused_post_pre_delayedの高速化率は、T=12で2.89倍、T=6で1.30倍です。
YOCOメタデータの再利用
DeepSeek-V4.1のYou-Only-Cache-Onceアーキテクチャでは、21層から39層が20層のフル解像度KVキャッシュを読み取ります。これらのコンシューマーは、拡張後のシーケンス長、ブロックテーブル、圧縮率を共有します。
DeepInfer-SM80は、20層の処理時にragged KメタデータをvLLMのforward contextに保存します。このデータを21層から39層で再利用することで、prefillチャンクごとに発生していた19本の冗長なメタデータ構築GPUカーネルチェーンを排除できます。
インストール前の準備
対応するNVIDIA Ampere GPU上でDeepSeek-V4.1を実行するvLLM V1環境が必要です。リポジトリには統合パッチと6つの置換モジュールが含まれていますが、READMEではCUDA、Python、Triton、TileLang、vLLMの正確なバージョン番号は指定されていません。パッチおよび既存のDeepSeek-V4.1デプロイメントと互換性のあるvLLMチェックアウトを使用してください。
対応ハードウェアは次のとおりです。
- SM80データセンターGPU: A100 40 GB、A100 80 GB、GA100 64 GB、A800 40 GBまたは80 GB。
- SM86ワークステーションおよびコンシューマーGPU: RTX 3090、RTX 3090 Ti、RTX A6000、A40、A10、A30。
本ソフトウェアはApache License 2.0の下で配布されています。
インストール方法A: 統合パッチを適用する
この方法では、変更された6つのファイルをvLLMのソースチェックアウトに適用します。そのチェックアウトのルートディレクトリでターミナルを開き、次のコマンドを実行します。
git apply /path/to/Deepinfer-SM80/patches/vllm-sm80-deepinfer.patch/path/to/Deepinfer-SM80を、クローンまたはダウンロードしたプロジェクトの場所に置き換えてください。このパッチには、スパースMLA、キャッシュギャザー、Top-KとSWA、mHC、ウォームアップ、YOCOメタデータ再利用の変更が含まれています。
インストール方法B: ドロップインモジュールをインストールする
環境に応じてファイルを直接置き換える場合は、プロジェクトのvLLMモジュールツリーをインストール済みのvLLMパッケージにコピーします。
cp -r vllm_sm80_deepinfer/vllm/* /path/to/site-packages/vllm//path/to/site-packages/vllm/を、実際のvLLMパッケージディレクトリに置き換えてください。同じファイルを、Dockerデプロイメントで読み取り専用のオーバーレイとしてバインドマウントすることもできます。
ドロップインツリーでは、次の機能領域が変更されます。
model_executor/kernels/mhc/は、TileLang mHCの実行とウォームアップに使用します。models/deepseek_v4_1/amd/rocm.pyは、Triton Top-KおよびSWAコンバイナーに使用します。models/deepseek_v4_1/common/ops/cache_utils.pyは、KVキャッシュのギャザーに使用します。models/deepseek_v4_1/nvidia/model.pyは、YOCOメタデータの再利用に使用します。v1/attention/ops/rocm_aiter_mla_sparse.pyは、統合スパースMLAカーネルに使用します。
最適化された2つのファイルにはパス名に
rocmまたはamdが残っていますが、リポジトリではこれらをAmpere向けvLLM統合の一部として明示的に使用しています。ドロップインファイルを適用する際は、提供されたディレクトリ構造を維持してください。
基本的な使用方法: カーネルを検証する
パッチまたはドロップインモジュールをインストールした後、対象のA100、A800、RTX 3090、RTX A6000、その他の対応Ampere GPU上で、付属の分離型マイクロベンチマークを実行します。
python3 benchmarks/microbench_sm80_kernels.py
python3 benchmarks/microbench_sm80_part2.py
python3 benchmarks/microbench_sm80_part3.py
ベンチマークファイルでは、スパースMLAおよびKVギャザーカーネル、TileLang mHCカーネル、Top-KとSWAのコンバイナーを検証します。目的は、ローカルでのカーネルレイテンシーを測定し、最適化された出力をベースラインの参照実装と比較して検証することです。
リポジトリのベンチマークチャートは、次のコマンドで生成できます。
python3 benchmarks/generate_charts.py完全なベンチマークデータセットは、benchmarks/results/sm80_benchmark_summary.jsonでも利用できます。
数値検証について
いくつかの最適化パスはビット単位で完全一致すると報告されています。
_combine_topk_swa_indices_kerneldequantize_and_gather_k_cache_sparse_attn_decode_kernelmhc_post_with_sqrsum
その他のTensor Coreパスでは、BF16の累積処理やMMAの実行順序が変わるため、わずかな差異が生じる場合があります。報告された最大差分は、測定された融合mHC構成では1.9e-3未満、測定されたスパースアテンションprefill構成では4.8e-3未満でした。
プロンプトの対数尤度における負の対数尤度の結果は、報告された実行間ノイズの範囲内に収まりました。デプロイメントを評価する際は、最適化されたすべての演算子がビット単位で完全一致すると仮定せず、性能と数値出力の両方を確認してください。
高度なデプロイメントのヒント
テスト済みの6 GPU本番レイアウトにはTP2 × PP3を使用する
64 GBまたは80 GBのAmpere GPUを6台使用する場合、リポジトリでは14,14,12のレイヤー分割によるTP2 × PP3を推奨しています。テスト構成では、この構成により、選択した単一ストリームコードおよび長時間生成ワークロードで毎秒160.8~188.8トークン、64Kコールドprefillで毎秒4,506.8トークンを実現し、約465万個のGPU常駐KVトークンを収容できました。
この容量は、ベンチマーク構成において、100万トークンのコンテキスト約4.43個に相当します。
代替構成を理解する
- PP6: 容量は約450万~470万トークンですが、テンソル並列度が1でリクエストが6つのパイプラインステージをまたぐため、単一ストリームのデコードが大幅に遅くなるとREADMEでは報告されています。
- 非対称TP2 + TP4: 推定容量は約600万トークンに増加しますが、MoEの中間サイズ2,304を幅576のTP4パーティションに分割するため、Marlinのタイル効率が低下します。
100万トークンのデプロイメントでトポロジーを選択する前に、リポジトリ内の docs/05_TOPOLOGY_1M_CONTEXT_ANALYSIS_SM80.md を参照してください。
実際のワークロードをベンチマークする
最大の改善は頻繁に呼び出される演算子から得られますが、エンドツーエンドの性能向上は、プロンプト長、同時実行数、投機的デコーディング、トポロジー、GPUモデルに左右されます。まず分離ベンチマークを実行し、その後、本番アプリケーションと同じプロンプト、コンテキストサイズ、同時実行レベルを使用して、サービングワークロード全体を比較してください。
直接出力の高速パスを維持する
疎なMLAデコード最適化では、num_kv_splits == 1 の場合に2回目のリダクション起動をスキップします。アテンションのスケジューリングや分割動作を変更する場合は、カーネルを再測定してください。直接出力パスは、報告されているデコード性能向上の重要な要素です。
YOCOメタデータをフォワードコンテキストに保持する
レイヤー20のメタデータキャッシュが有用なのは、レイヤー21~39のすべてのコンシューマーが同じKVソースを共有するためです。モデル実行やフォワードコンテキストの処理を変更する場合は、この再利用を維持してください。そうしないと、エンジンが各コンシューマーレイヤーで同一のraggedメタデータを再構築する可能性があります。
結論
DeepInfer-SM80は、KVキャッシュのVRAM使用量を増やすことなく、NVIDIA Ampere上でDeepSeek-V4.1を高速化するための集中的な手段を提供します。その改善は、Ampere対応の疎なアテンション、ビットシフトによるUE8M0デコーディング、KVキャッシュの直接出力、競合のないTop-KおよびSWAコンバイナー、アラインメント済みmHCルーティング、YOCOメタデータの再利用を組み合わせたものです。
まず、統合パッチを適用するか、6つのドロップインモジュールをインストールしてください。3つすべてのマイクロベンチマークスイートを実行して、使用するハードウェア上でレイテンシーと数値挙動を確認し、その後、実際のサービングワークロードで最適化済みのvLLM環境を評価してください。6基のGPUで100万トークンのコンテキストを扱うデプロイメントでは、リポジトリでテスト済みの TP2 × PP3 構成を主要な参照点として使用してください。