

プロジェクト概要
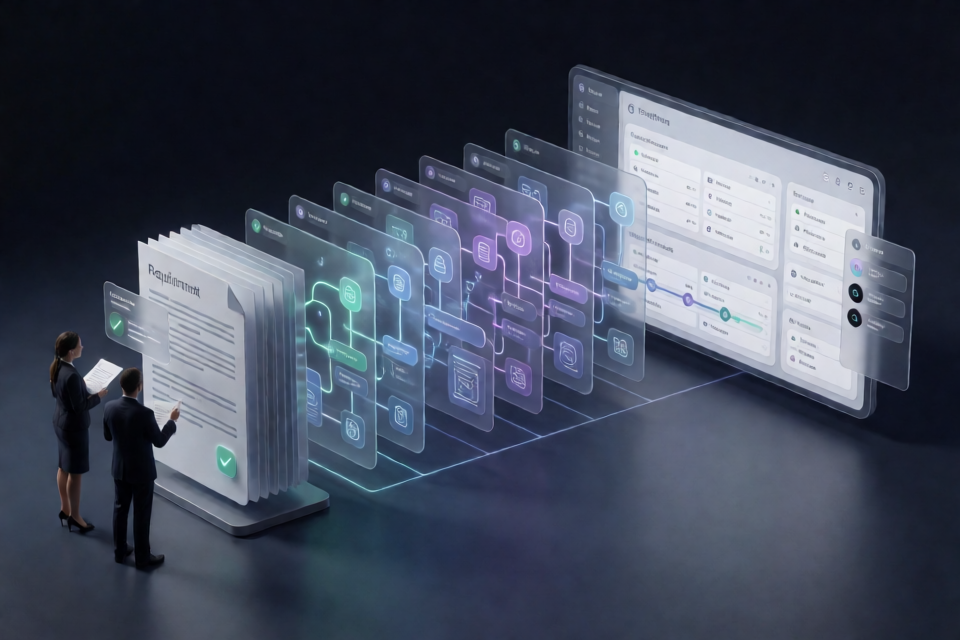
ontology-driven-dev は、業務システム開発向けの AI スキルセットです。「要件探索 → オントロジーモデリング → アプリケーション構築」という強制的な順序の 3 ステップで進めます。1 つの業務説明から始め、各段階で人が確認することで、要件仕様書、7 モデルの YAML、そして実行可能なブラウザベースのフロントエンド・バックエンドシステムを作成できます。
その中心的な目的は、AI に単純に素早くコードを生成させることではなく、要件文書、オントロジーモデル、最終コードを厳密に一致させることです。データベーステーブル、API、メニュー、権限、プロセス、ルール、レポートはすべてモデルを意味上の情報源とするため、要件、設計、実装が分離する問題を減らせます。
要件探索フェーズには 8 つのステップが含まれます。各ステップでは必ず一時停止して人の確認を待つ必要があり、Agent が自動的にスキップすることはできません。
中核機能とプロジェクト構成
主な特長
- 要件の追跡可能性:各機能を、要件仕様書内の対応する項目まで遡って確認できます。
- 7 モデルによる意味の統一:M1、M2、M3、M5、M6、M7、MU の YAML を使用して、オブジェクト、振る舞い、ルール、主体、プロセス、クエリ・レポート、UI を記述します。
- 人による確認ゲート:要件探索のフェーズ 0 からフェーズ 7 までは、すべて人の確認後にのみ次へ進めます。
- 組み込みの技術基盤:
code-paasは Flask、SQLite、React、TypeScript によるモノリシックアプリケーションの基盤を提供し、システム管理、ワークフローエンジン、ワークベンチ、オントロジーレジストリを含みます。 - AI ネイティブなインタラクション:生成されるアプリケーションには右側の AI ダイアログを必ず含め、オントロジーレジストリの注入、ツール呼び出し、SSE ストリーミング応答、読み取り専用 SQL のセキュリティ境界に対応します。
- 複数ツールへの対応:WorkBuddy、Claude Code、Codex、Cursor、Aider、Cline、およびプロジェクト指示を読み込める汎用 Agent で利用できます。
リポジトリの主な内容
SKILL.md:方法論、3 段階のパイプライン、遵守必須の実行規律を定義します。references/:要件作成規約、オントロジーモデリングフレームワーク、モデルから実装への開発ガイド、AI ネイティブ技術アーキテクチャ、UI/UE 規約を含みます。reference-example/:販売契約の履行管理に関する完全な例で、要件文書、7 モデルの YAML、manifest.jsonを含みます。techbase/:複製・拡張可能な code-paas のソースコードで、バックエンド、フロントエンド、モデル例、依存関係ファイルを含みます。
実行環境の準備
開始前に、ローカル環境が以下の条件を満たしていることを確認してください。
- Python 3.10 以降。
- Node.js 18 以降。
- Python とフロントエンドの依存関係を初回インストールする際にネットワークへアクセスできること。
バックエンドには Flask と SQLite、フロントエンドには React、TypeScript、Vite を使用します。プロジェクトは MIT License を採用しており、自由に利用、変更、再配布できます。
AI 開発ツールへのインストール
Claude Code へのインストール
Claude Code はスキルディレクトリ内の SKILL.md を自動的に検出できます。すべてのプロジェクトで使えるよう、ユーザー単位でインストールできます。
cp -r ontology-driven-dev ~/.claude/skills/ontology-driven-dev現在のプロジェクトにインストールすることもできます。
cp -r ontology-driven-dev .claude/skills/ontology-driven-dev完了すると、Claude Code はスキルの frontmatter にある name と description に基づいてフローを認識し、読み込みます。
WorkBuddy へのインストール
ユーザー単位でインストールするコマンドは次のとおりです。
cp -r ontology-driven-dev ~/.workbuddy/skills/ontology-driven-dev1 つのプロジェクトだけで使用する場合は、次を実行します。
cp -r ontology-driven-dev <あなたのプロジェクト>/.workbuddy/skills/ontology-driven-devCodex へのインストール
Codex にはネイティブのスキルレジストリがないため、まずスキルをリポジトリにコピーする必要があります。
mkdir -p .codex/skills
cp -r ontology-driven-dev .codex/skills/
次に、プロジェクトの codex.md または AGENTS.md に読み込みルールを追加します。
ユーザーが「オントロジー駆動開発、要件探索、オントロジーモデリング、7 モデル、code-paas、AI ネイティブアプリケーション」に取り組む場合は、
.codex/skills/ontology-driven-dev/SKILL.mdを読み込み、3 段階のフローと人による確認ゲートに厳密に従って実行する。
Codex は人による確認を、対話形式の質問または承認に対応付けます。npm install と pip install を実行するには、Codex のサンドボックスからネットワークに接続できる必要があります。
Cursor、Aider、Cline での利用
- Cursor:
SKILL.mdの内容をプロジェクトルールまたは.cursorrulesに入れます。 - Cline、Aider:セッション開始時に
SKILL.mdを貼り付けるか、Agent にそのパスを読み込むよう明示的に指示します。 - その他の Agent:このファイルをシステム指示またはプロジェクトメモリとしてコンテキストに注入します。
第 1 段階:要件の探索と確認
第 1 段階では、references/AI需求探索与确认提示词V9.0.md に基づき、初期の業務説明を正式なソフトウェア要件仕様書に整理します。
Agent には、次のような指示を入力できます。
販売契約の履行管理システムを開発してください。契約、入金、納品、承認を管理する必要があります。Agent は、以下の 8 つのフェーズを順番に進める必要があります。
- 全体理解。
- 業務オブジェクト。
- 業務機能とルール。
- オブジェクト間の連携。
- エンドツーエンドの連携と承認フロー。
- 検索、集計、レポート。
- ロールと権限。
- UI プロトタイプ。必要に応じて選択。
各フェーズの終了後、Agent は必ず「質問、AI の提案、理由、その他の選択肢、クイック返信」という形式で確認を求め、あなたの判断を待って一時停止する必要があります。企業固有の B 類の内容についても明確に質問する必要があり、確認されるまで次のフェーズへ進めてはいけません。
この段階では最終的に次のファイルを生成します。
<業務ドメイン>-要件仕様書-V9.md文書の付録 C は、次の段階で 7 モデルを構築するための基準入力です。そのため、業務オブジェクト、プロセス、ルール、ロール、レポートが完全かどうかを重点的に確認してください。
第 2 段階:7 モデル YAML の生成
要件の確認後、Agent は references/ontology_modeling_framework_v9.md と要件文書の付録 C に基づいてオントロジーモデルを構築します。この時点の入力は確定した基準であるため、業務を再び大規模に分割し直すべきではありません。
要件仕様書がすでに用意されている場合は、モデリングのみのフローを直接開始できます。
この要件仕様書に基づいてオントロジーモデリングを行い、7 モデルの YAML と manifest.json を出力してください。yaml/ ディレクトリには、次の内容を出力します。
- M1 オブジェクトモデル:業務オブジェクトを記述します。
- M2 振る舞いモデル:業務上の振る舞いを記述します。
- M3 ルールモデル:業務ルールを記述します。
- M5 主体モデル:ロールと関連主体を記述します。
- M6 プロセスモデル:業務プロセスを記述します。
- M7 クエリ・レポートモデル:クエリとレポートを記述します。
- MU UI モデル:ユーザーインターフェースを記述します。
manifest.json:モデル一覧を記録します。
モデリング完了後は、一貫性チェックを実行する必要があります。少なくとも要件の追跡可能性、M7 と M2 の 1 対 1 の関係、M6 の参照に循環がないことを確認してください。不整合が見つかった場合は、まずモデルを修正してからコード構築フェーズへ進みます。
第 3 段階:実行可能な BS システムの構築
code-paas 技術基盤のコピー
スキルディレクトリ内の techbase/ を、現在のプロジェクトの code-app/ に完全にコピーします。
cp -r <スキルルート>/techbase/. <現在のプロジェクト>/code-app/
cd <現在のプロジェクト>/code-app/frontend && npm install
cd <現在のプロジェクト>/code-app/backend && pip install -r requirements.txt
正式な開発では、第 2 段階で生成したモデルを使用して、基盤に含まれるサンプルの 7 モデル YAML を置き換えます。
10 ステップの順序で実装
- 7 モデルの YAML を書き込む、または整理する。
- DDL とデータベーステーブルを生成する。
- データディクショナリを登録する。
- 振る舞いとルールのサービスを実装する。
- ロール・権限の初期データを書き込む。
- ワークフローエンジンを統合する。
- メニュー、ページ、ルートを生成する。
- 右側の AI ダイアログを実装する。
- フロントエンドとバックエンドの全経路を統合テストする。
- 要件とモデルに基づいて受け入れテストを完了する。
右側の AI ダイアログは必須コンポーネントであり、開発中に省略してはいけません。プロジェクトで定義されたオントロジーレジストリの注入、ツール呼び出し、SSE ストリーミング、読み取り専用 SQL のセキュリティ境界に従う必要があります。
バックエンドとフロントエンドの起動
Flask バックエンドを起動します。
cd code-app/backend
pip install -r requirements.txt
python app.py
バックエンドのデフォルトアクセス先は http://localhost:5000 です。
別のターミナルを開き、フロントエンド開発サーバーを起動します。
cd code-app/frontend
npm install
npm run dev
フロントエンドのデフォルトアクセス先は http://localhost:5173 です。デフォルトアカウントは admin、デフォルトパスワードは admin123 です。基盤の詳しい実行方法については techbase/README.md を参照してください。
よく使う起動方法
既存の入力と目的に応じて、異なる起動フレーズを使用できます。
要件から完全な開発を開始
設備修理管理システムを開発してください。オントロジー駆動開発のフローに厳密に従い、各要件探索フェーズで必ず私の確認を待ってください。オントロジーモデリングのみ実行
この要件仕様書に基づいてオントロジーモデリングを行い、M1、M2、M3、M5、M6、M7、MU、manifest.json を出力してください。既存モデルからアプリケーションを構築
これらの 7 モデル YAML に基づいてシステムを生成し、code-paas 基盤を使用してフロントエンドとバックエンドの統合テストまで完了してください。「オントロジー駆動」「要件探索」「オントロジーモデリング」「7 モデル」「code-paas」「AI ネイティブアプリケーション」「業務システム開発」などのキーワードも、Agent がスキルを識別するのに役立ちます。
発展的な実践の推奨事項
人による確認ゲートを省略しない
初期要件が十分に整っているように見えても、Agent に一度にシステムを直接生成させないでください。段階ごとに確認することで、オブジェクトの境界、承認ノード、権限範囲、集計基準などの問題を早期に明らかにできます。
付録 C をモデリングの境界とする
フェーズ 2 では、要件文書の付録 C を確定した入力として使用します。モデリング中に重要な業務内容の不足が判明した場合は、モデルに未確認の業務範囲を独自に拡張させるのではなく、要件フェーズに戻って補足し、確認してください。
モデル間の参照を優先的に確認する
コード構築に入る前に、M7とM2の対応関係、M6の参照関係、そして要件項目からモデル要素への追跡可能性を重点的に確認します。モデルレベルの誤りがデータベース、インターフェース、画面に入り込むと、後続の結合テストにかかるコストが増大します。
ゴールデンリファレンスを比較用に保持する
reference-example/ には、販売契約の履行管理に関する完全な実例が用意されています。初めて使用する際は、そこにある要件仕様書、7モデルのYAML、manifest.json を参照し、各段階の成果物がどのようにつながっているかを理解できます。
まずモデルを置き換え、その後に基盤を拡張する
techbase/models/ にあるのはサンプルモデルです。本番プロジェクトでは、まず独自の7モデルYAMLを配置し、モデルから実装へ至る10ステップのパイプラインに従って、バックエンドサービス、権限、ワークフロー、メニュー、画面を拡張してください。サンプルデータを前提に業務コードを直接変更することは避けます。
まとめ
ontology-driven-dev は、要件の明確化、オントロジーモデリング、アプリケーション実装を、人手によるゲートを備えた一続きの開発プロセスに結び付けます。正しく利用する鍵は、まず要件を確認し、次に7モデルの整合性を検証し、最後に code-paas を基盤として構築・受け入れを行うことです。これにより、AIによる業務システム開発の効率向上を活用しながら、明確な意味の出所と完全な要件追跡関係を維持できます。