

AIBuildAI LLM-Post-Train Agentとは?
AIBuildAI LLM-Post-Train Agentは、大規模言語モデルの自動かつカスタマイズ可能なポストトレーニングを実行する、再帰的に自己改善するエージェントです。1つの固定されたトレーニング手順を適用するのではなく、タスクを分析し、候補となるポストトレーニングアルゴリズムを設計し、トレーニングデータを収集・整理し、コードを記述し、実験を実行し、結果を評価して、モデルを反復的に改善します。
このリポジトリには、エージェントの実行、参照、変更に必要なソースコードが含まれています。独自データ、モデルファミリー、評価手順、デプロイ目標に合わせたポストトレーニング戦略を必要とする組織や研究者向けに設計されています。
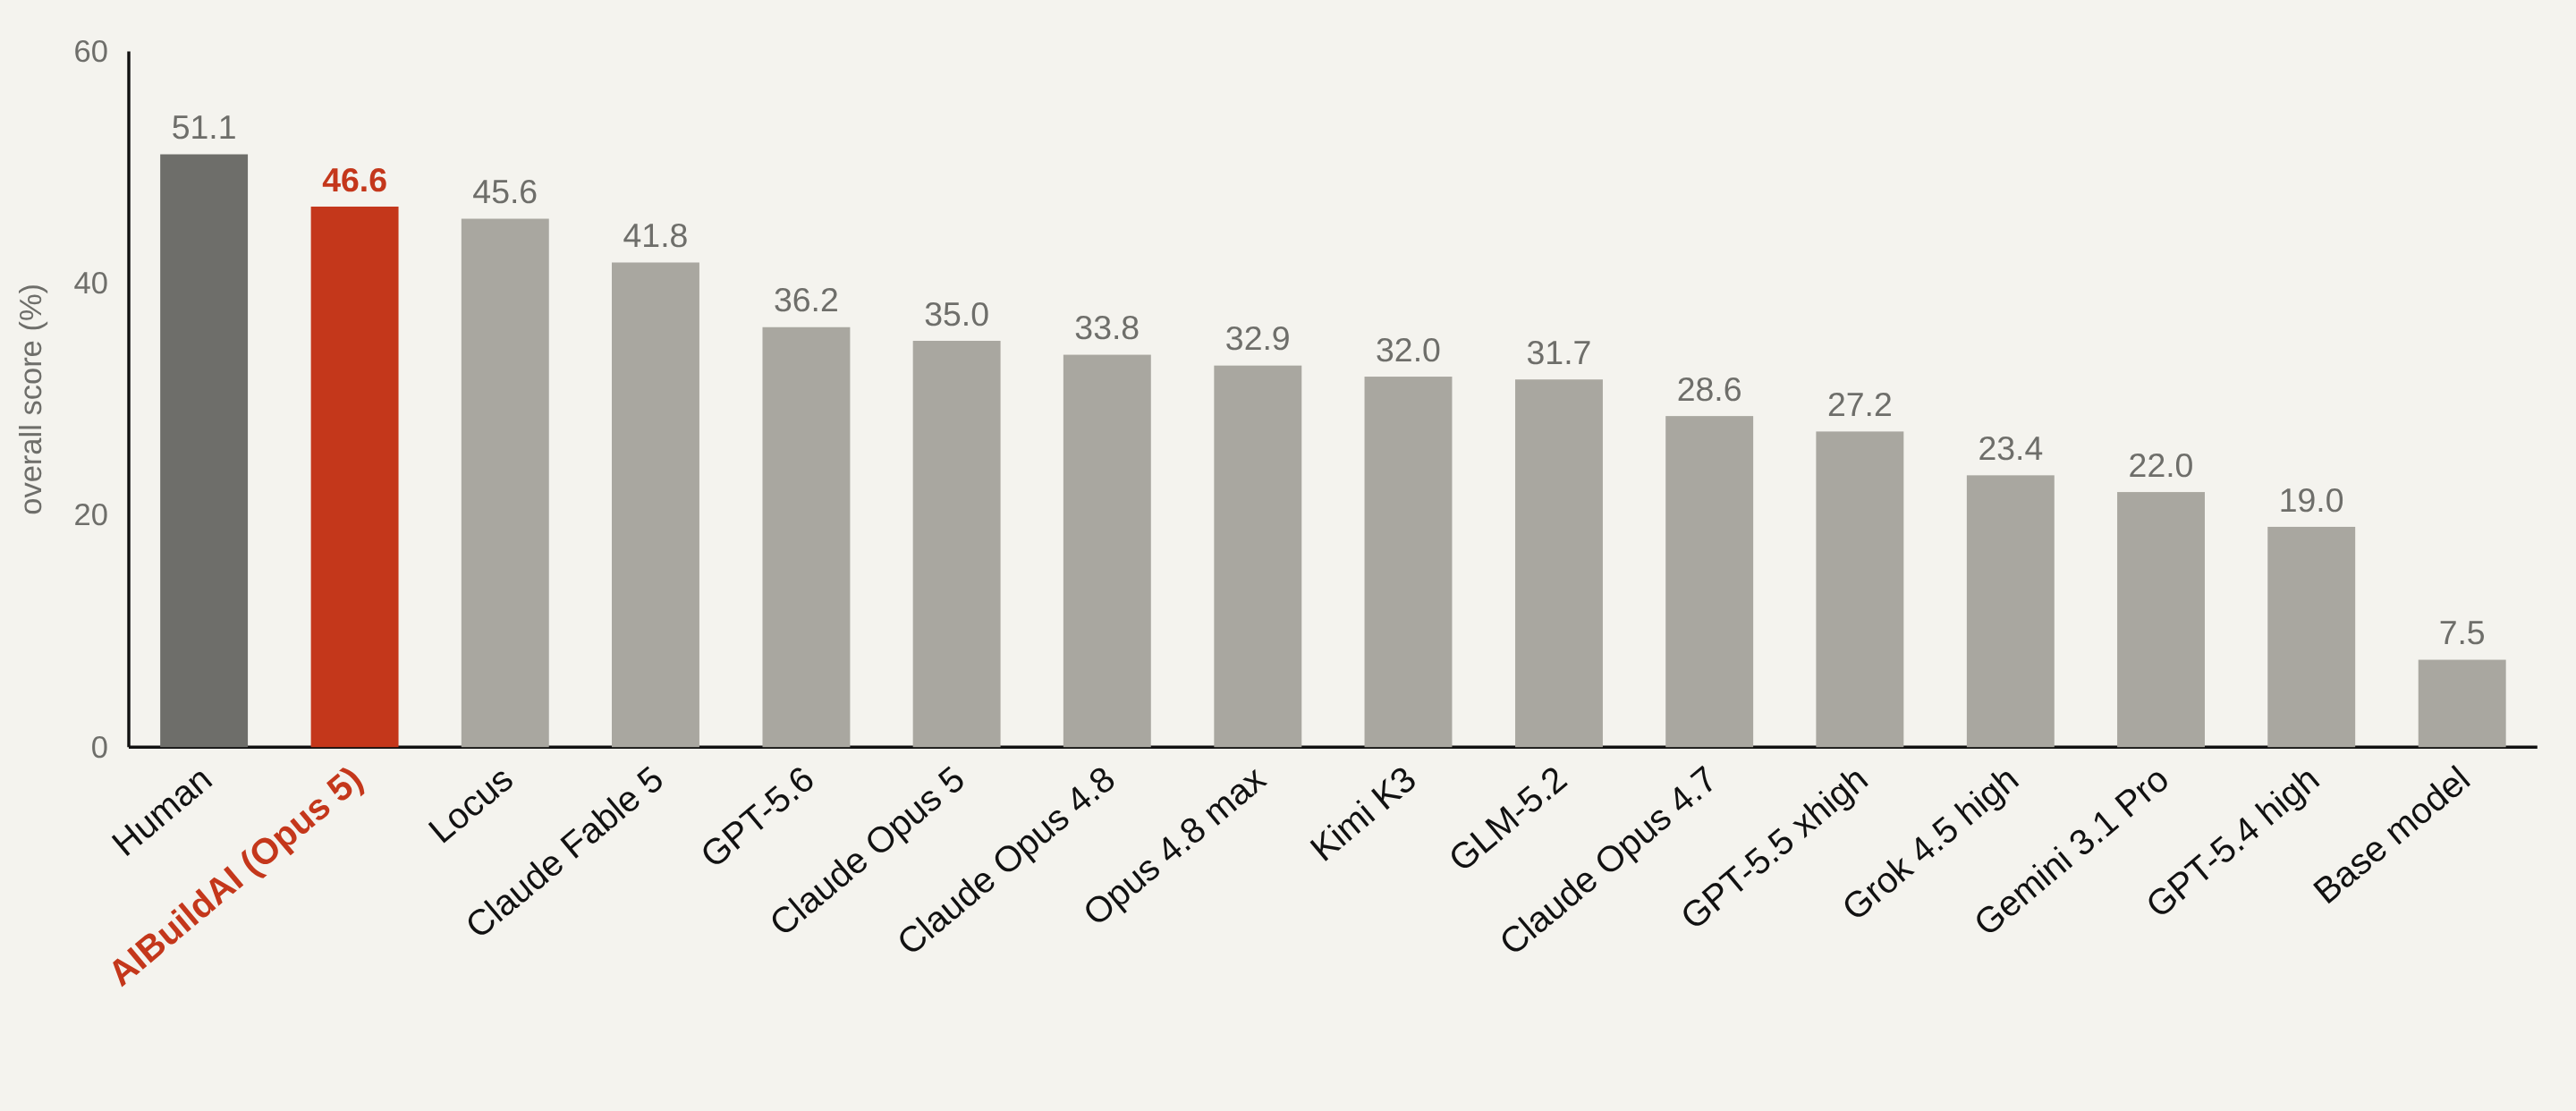
PostTrainBenchでは、プロジェクトの総合スコアは46.6%で、評価対象のモデルとエージェントの中で1位となり、人間の専門家によるベースライン51.1%に次ぐ結果を報告しています。
エージェントの仕組み
実行は、タスクとスコアリング手順から始まります。システムは固定されたタスク説明を準備し、ベースラインを設定し、実験を開始し、完了した各候補を同じスコアプログラムで評価して、最良の結果を成果物にします。
このシステムを一般的なコーディングエージェントと区別する2つの機能があります。
- ナレッジシステム:エージェントはMCP経由でAIBuildAI Knowledge Baseを参照できます。整理されたスキル文書には、ポストトレーニングのワークフロー、手法、データセット、フレームワークがまとめられています。
- メタサーチ:メタエージェントはタスクを調査し、あらかじめ決められた実験トポロジーを実行するのではなく、タスク固有の探索プログラムを作成できます。
各実行には、ライブWebワークスペース、永続的な実行グラフ、ジャーナル化された作業単位、サンドボックス化されたサブプロセス、リソース制御も提供されます。実行イベントは~/.aibuildai/postgresql配下のプライベートPostgreSQLクラスターに保存され、実行の再開と再生に対応します。
主な機能
- LLMポストトレーニング実験の設計と実行を自動化。
- メタサーチや複数の固定探索手法を含む、タスク固有の探索戦略。
- 手法、データセット、フレームワーク、ワークフロー上の判断に関する知識検索。
- 型付きエージェント、決定論的プログラム、ネストされた探索。
- タスクで定義した評価と一貫した候補ランキング。
- ローカルワークスペースサービスによる、ブラウザベースのライブ監視。
- メモリとプロセスを制限するBubblewrapサンドボックスおよびcgroup-v2。
- 過去の実行結果からローカルに生成されるメモリ。
- 集約後の論文草稿作成とPDFコンパイル(オプション)。
- ClaudeおよびAnthropic互換エンドポイントで提供されるその他のモデルに対応。
システム要件
プロジェクトをインストールする前に、ホストが次の要件を満たしていることを確認してください。
- systemdユーザーセッションを備えたx86_64 Linux。
- Python 3.11~3.13。
gccとmakeを含むCツールチェーン。- zlibおよびreadlineの開発用ヘッダー。
bubblewrapパッケージで提供されるbwrap。非特権ユーザー名前空間が有効になっていること。- GitHubリリースおよび
ftp.postgresql.orgへのネットワークアクセス。 - Claude Codeのログイン、Anthropic APIキー、またはAnthropic互換エンドポイントで利用可能な別のモデル。
- CUDA GPUを推奨しますが、エージェントは利用可能なハードウェアを検出して使用します。
初回実行時に、公式ソースtarballからプライベートPostgreSQLをビルドします。また、ruff、tectonic、micromamba、caddy、PostgreSQLなどのツールの固定バージョンを~/.cache/aibuildaiにダウンロードします。システムは、ホストにインストールされた同等のツールではなく、これらの管理対象コピーを使用します。
condaは必要ありません。エージェントは、管理対象のmicromambaインストールを使用してProgram環境を作成します。
cgroup-v2の委任を確認する
実行は1つのcgroup-v2ツリーによって制限されます。systemdユーザーマネージャーは、少なくともmemoryおよびpidsコントローラーを委任する必要があります。次のコマンドで現在の設定を確認します。
U=$(id -u)
cat /sys/fs/cgroup/user.slice/user-$U.slice/user@$U.service/cgroup.subtree_control出力にはmemoryとpidsが含まれている必要があります。どちらかがない場合は、管理者が/etc/systemd/system/user@$U.service.d/配下のドロップインにDelegate=pids memory cpuを追加し、systemdを再読み込みしたうえで、あなたが再度ログインする必要があります。
エージェントをインストールする
1. オペレーティングシステムのパッケージをインストールする
DebianまたはUbuntuでは、コンパイラー、必要なヘッダー、bubblewrapをインストールします。
sudo apt-get install build-essential zlib1g-dev libreadline-dev bubblewrap2. リポジトリをクローンする
git clone https://github.com/aibuildai-inc/aibuildai-llm-posttrain-agent.git
cd aibuildai-llm-posttrain-agent
3. Python仮想環境を作成する
python -m venv .venv
source .venv/bin/activate
4. 固定バージョンの依存関係をインストールする
pip install -r requirements.lock
pip install -e . --no-deps編集可能インストールにより、aibuildaiコマンドが提供されます。このコードベースで検証済みのclaude-agent-sdkの固定バージョンを使用するため、ロックファイルを使用してください。
リポジトリを変更して品質ゲートを実行する場合は、開発用依存関係もインストールします。
pip install -r requirements-dev.lock5. 管理対象ツールを準備する(任意)
ツールは初回実行時にダウンロードされ、ビルドされます。事前に準備するには、次を実行します。
aibuildai setupモデルアクセスを設定する
方法 1: Claude Code のログインを使用する
claude auth login方法 2: API キーを指定する
export AIBUILDAI_API_KEY=sk-ant-...AIBUILDAI_API_KEY が設定されていない場合、アプリケーションはまず ANTHROPIC_AUTH_TOKEN、次に ANTHROPIC_API_KEY を確認します。
別の Anthropic 互換エンドポイントを使用する
AIBUILDAI_BASE_URL にエンドポイントを設定し、そのキーを AIBUILDAI_API_KEY に指定します。
export AIBUILDAI_BASE_URL=https://openrouter.ai/api
export AIBUILDAI_API_KEY=your-key
export AIBUILDAI_SMALL_FAST_MODEL=provider/model-id
deepseek- で始まる単純なモデル識別子は、自動的に DeepSeek の Anthropic 互換エンドポイントを対象にします。OpenRouter のモデル識別子にはプロバイダーのプレフィックスが含まれるため、AIBUILDAI_BASE_URL と AIBUILDAI_SMALL_FAST_MODEL の両方が必要です。
エンドポイントで Claude のモデル階層に別の名前を使用している場合は、AIBUILDAI_HAIKU_MODEL、AIBUILDAI_SONNET_MODEL、AIBUILDAI_OPUS_MODEL で対応付けます。サブエージェントで、そのロールに設定されたモデルとは異なるモデルを実行する場合は、AIBUILDAI_SUBAGENT_MODEL を使用します。
オプションのサービス設定
AIBUILDAI_KB_BASE_URLはナレッジベース MCP サービスを選択します。デフォルトでは、クライアントはプロジェクトの公開された固定スナップショットを使用します。AIBUILDAI_KB_TOKENは、ナレッジサービスで認証が必要な場合にベアラートークンを指定します。AIBUILDAI_WEB_PORTはローカルワークスペースサービスのポートを選択します。AIBUILDAI_WEB_NAMEは同じホスト上の 2 つ目のワークスペースサービスに名前を付けます。明示的な Web ポートの指定が必要です。
基本的な実行を作成して開始する
各実行は 1 つの YAML ファイルで記述します。ドキュメント付きのスターター設定を生成するには、次を実行します。
aibuildai config > task.yaml生成されたファイルには、すべての設定項目、そのデフォルト値、およびドキュメントが含まれます。必須のトップレベルセクションは run、llm、work_units、search、resources で、スターターにはこれらが記入されています。
次のコマンドで実行を開始します。
aibuildai run task.yamlこのコマンドは、http://127.0.0.1:<port>/run/<run-id> のようなワークスペース URL を出力します。開くと、実行状況をリアルタイムで確認できます。ブラウザーは任意であり、ブラウザーなしでも実行は通常どおり継続します。
GSM8K の例を実行する
付属の例では、GSM8K の小学校レベルの数学文章題を解くように Qwen/Qwen3-1.7B-Base を追加学習します。リポジトリによると、この例の実行には 1 台の GPU で約 2 時間かかります。
1. タスクフォルダーを構築する
bash examples/gsm8k-qwen3-1.7b-base/setup.sh ~/gsm8k-exampleセットアップでは、ベースモデルの重みと GSM8K の 2 つの分割を含む約 4 GB のデータをダウンロードします。また、タスクの説明と固定された grader を ~/gsm8k-example/task/ に書き込み、実行専用の Program 環境にインストールするパッケージ用の pip キャッシュを事前に準備します。
生成されたタスクフォルダーには、エージェントが調整できるベースの重み、7,473 件の学習問題、grader、およびその grader が読み込む 1,319 件の問題からなるテスト分割が含まれます。
2. 追加学習を開始する
aibuildai run ~/gsm8k-example/task.yamlこの例では、メタサーチ、探索時間 90 分のウォールクロック制限、およびそれに対応するエージェントごとの予算を使用します。README では、本格的な実行ではこれらの予算を増やすことを推奨しています。
3. 採点契約を理解する
grader が成功の完全な定義です。grader は、質問とそれに続く回答プレフィックスをモデルに与え、貪欲デコードを行い、最後の #### の後にある数値を抽出します。README によると、最初の 200 件のテスト問題に対するベースモデルのスコアは 0.105 です。これは、調整前のベースモデルが当初、必要な回答形式に従わないためです。
4. 最終モデルを評価する
成果物はマージ済みモデルのディレクトリです。<run-home> を生成された実行ディレクトリ名に置き換え、実行の Program 環境を使用してすべてのテスト例を評価します。
H=~/gsm8k-example/playground/gsm8k-qwen3-1.7b-base/<run-home>
$H/program-environment/env/bin/python ~/gsm8k-example/task/grade/evaluate.py --model-path $H/deliverable/final_model --limit -1
独自のタスクでエージェントを使用する
examples/gsm8k-qwen3-1.7b-base.yamlをコピーするか、aibuildai configで完全なスターターを生成します。- 実行で使用する可能性のあるすべてのものを含むタスクフォルダーを作成します。
- 必要なデータファイルすべてに加えて、README、タスクの説明、論文など、読みやすいタスク説明を含めます。
run.data_rootをそのフォルダーに設定します。- モデル、検索、予算、ワークユニット、リソースの設定を確認します。
aibuildai runで YAML ファイルを起動します。
セットアップ中、システムはタスクフォルダー全体を読み込み、その説明を実行の README として固定し、そこから実行のスコアプログラムを構築します。そのため、タスクフォルダーには必要なものをすべて含め、期待される成果物と評価方法を明確に定義する必要があります。
設定では run.setup_from_scratch と run.task_prompt もサポートされています。これらの設定を使用すると、準備済みのタスクフォルダーから開始する代わりに、タスクの説明からセットアップがデータと評価を取得できます。
重要な設定項目
モデルの選択
llm.default.modelはエージェントが使用する基本モデルを選択します。推論はeffortやmax_thinking_tokensなどの設定で調整できます。llm.by_roleを使用すると個々のロールにモデルを固定でき、llm.autoを使用するとルーターがロールに応じてモデルを選択します。
検索方法
search.kindは実験戦略を制御します。READMEで説明されている対応値は次のとおりです。
meta:メタエージェントがタスク固有の検索プログラムを作成します。nb_tree:実験全体を対象とするツリー検索です。nb。tree:汎用スターターでのデフォルトです。linear。parallel。
search.inputの内容は、選択した戦略によって異なります。メタ検索ではreportオプションを受け付けますが、固定戦略ではそれぞれ独自のパラメータを使用し、parallelやearly_stoppingを含められる場合があります。
時間と支出の上限
run.budget.wall_clock_minutesのデフォルトは1,440分です。上限に達すると新しい探索は開始されませんが、実行中の処理と成果物の引き渡しは完了まで許可されます。run.budget.cost_usdでは、実行全体に対する任意のソフト支出上限を設定できます。
work_units内の各エントリには独自の予算があります。ワークユニットでは、固定分数、深さに応じた時間、または余裕を含む予想所要時間を使用できます。
リソース制限
resources.work_unit.cpu_max_coresとresources.work_unit.memory_max_gbを使用すると、各ワークユニットに厳格なCPUおよびメモリ制限を課せます。各ユニットは、メモリとプロセスにcgroup制限を設定したbubblewrapサンドボックス内で実行され、タスクフォルダーは読み取り専用でマウントされます。
高度なヒント
知識検索を有効にする
エージェントがAIBuildAI Knowledge Baseを参照できるようにする場合は、kb MCP設定を追加します。クライアントは、スキルの検索、スキルの読み込み、リファレンスの参照に使用するツールを提供します。コーパスには、ワークフローガイダンス、方法論カード、データセットカード、フレームワークカードが含まれます。
デフォルトの公開サービスは、固定されたコーパスのスナップショットです。独自バージョンをホストするには、オープンソースのknowledge-baseリポジトリをデプロイし、AIBUILDAI_KB_BASE_URLをそのリポジトリに指定します。
タスク固有のトポロジにはメタ検索を選択する
固定ツリー検索では、トレーニング前にスイープを実行する、後でトーナメントを開催する、複数のモデルを組み合わせるといった、あらゆるワークフローを自然に表現できるわけではありません。search.kind: metaを使用すると、メタエージェントがタスクを調査し、パイロットを実行し、組み込みの設計スキルとナレッジベースを参照して、Python検索パッケージを作成します。
生成されるパッケージは、次の3つのプリミティブから構成されます。
- Agent:ツール、ポリシー、型付き出力を備えたLLMセッション。
- Program:専用のリソース制限を持つ管理ワーカー内で実行される決定論的計算。
- Search:型付き入出力を使用して、Agent、Program、ネストされたSearchを生成・調整できるオーケストレーター。
パッケージは検証され、必要に応じてLaTeX設計レポートでレビューできます。その後、同じジャーナル化された実行の子検索として実行されます。トポロジに関係なく、実行の価値はどのノードでも獲得された最高スコアに保たれます。
再利用可能なローカルメモリを構築する
タスクの実行を蓄積したら、得られた知見を編集可能なローカルメモリドキュメントに統合します。
aibuildai memorize task.yamlmemory.enableを設定すると、そのローカルメモリがすべてのエージェントに注入されます。実行から得た知識はマシン上に保持され、リモートナレッジベースには追加されません。
外部ツールを制御する
disallowed_toolsを使用すると、すべてのロールで選択した組み込みツールを使用できないようにできます。たとえば、評価ルールでオフラインワークフローが必要な場合、タスクでWebSearchとWebFetchを禁止できます。
MCP統合を追加する
mcps設定では、ナレッジベース、Kaggleコンペティションへの提出、またはカスタムMCPサーバーを有効にできます。Kaggle統合では、submission.max_submissionsで最大提出回数を設定できます。
論文を生成する
writer.enableを有効にすると集約後に論文を下書きできます。または、完了した実行ディレクトリに対して論文コマンドを実行します。
aibuildai write-paper <run-dir>このコマンドは完了した実行から論文を下書きし、PDFにコンパイルします。
ソース変更を検証する
このプロジェクト系列にはテストスイートが含まれていません。リポジトリの検証ゲートは次のとおりです。
./check.shこのゲートでは、pyright、ruff、semgrep、およびロックファイルの差分チェックが実行されます。使用前にrequirements-dev.lockをインストールしてください。
実行出力を理解する
各実行では、設定されたプレイグラウンドルートの下にホームディレクトリが作成されます。
{playground_root}/<task-name>/<timestamp>_<run-id>/
  run_config.json
  public/
  private/
  deliverable/
  workspace/
  program-environment/
resource_samples.jsonlrun_config.jsonには、再開に使用する最終設定と実行IDが含まれます。public/には、候補向けにSetupが準備した固定READMEとデータが含まれます。private/には、スコアプログラム、メトリックマニフェスト、ベースライン試行、勝者レコードが含まれます。deliverable/には、実行可能なモデルパッケージ、またはタスクで定義された別の成果物が含まれます。workspace/には、試行、成果物、スクラッチデータ、検索ごとの作業ディレクトリが含まれます。program-environment/には、実行用に分離されたProgram環境が含まれます。resource_samples.jsonlには、実行中に収集されたホストリソース測定値が記録されます。
まとめ
AIBuildAI LLM-Post-Train Agentは、モデルのポストトレーニングワークフローの設計、実行、評価、改善をエンドツーエンドで行うシステムです。まず、付属のGSM8Kサンプルを使用してインストールを確認し、実行構成を学習します。次に、明確なタスクフォルダーと評価器を定義し、適切な探索戦略を選択して、現実的な予算とリソース制限を設定します。その後、ライブワークスペースで実行された実験を追跡できます。
アーキテクチャの詳細については、リポジトリのアーキテクチャドキュメントを参照してください。このプロジェクトはApache License 2.0の下で配布されています。